
从工程度量看 Agent 重试成本:埋点、公式与降本清单
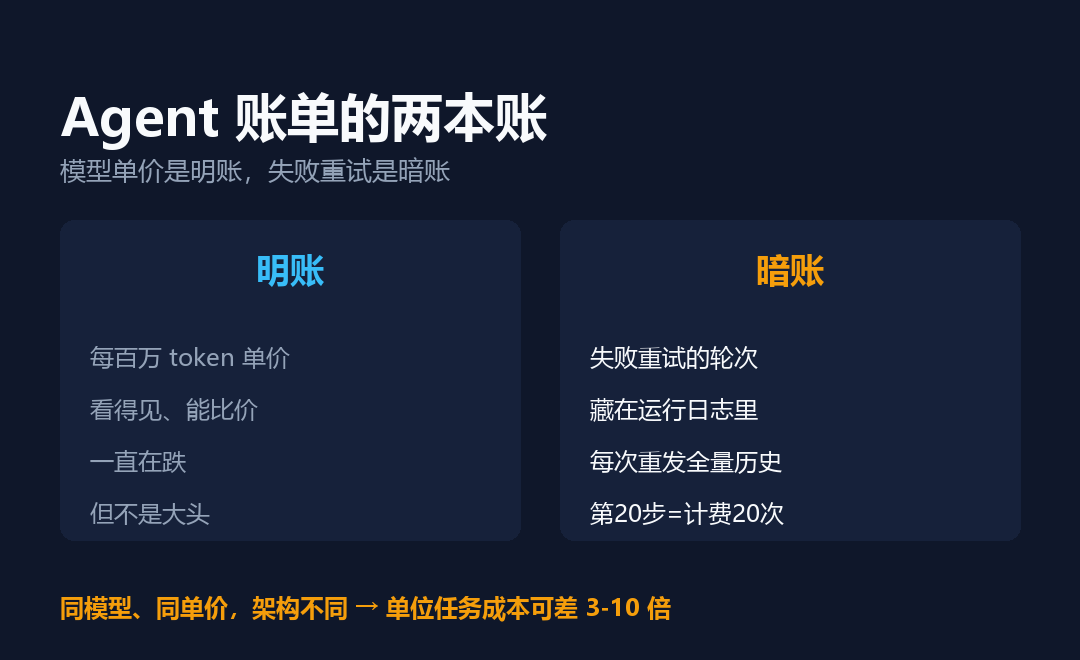
Agent 的成本账,很少有人按"任务"来记,大多按"调用"来记。但真实的花钱大头,藏在失败重试里。
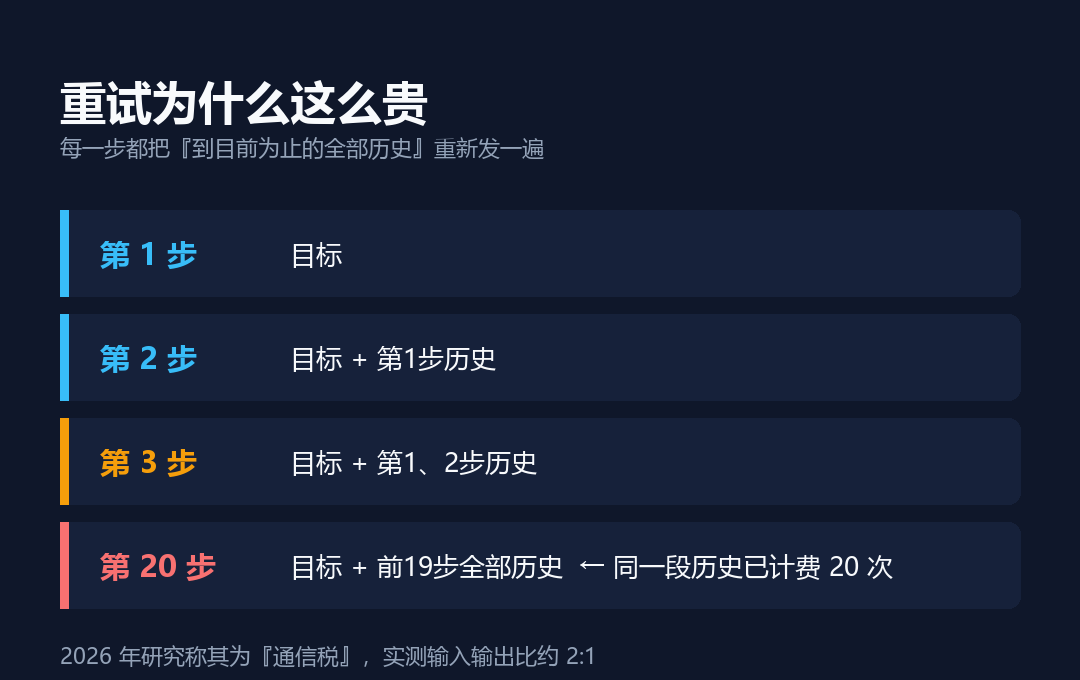
结论先行:Agent 每重试一次,全部历史上下文会被重新计费一次。到第 20 步,同一段历史已被计费 20 次。正确的成本口径是 单位任务成本 = 单价 × 平均调用轮次 × 成功率修正;同模型、同单价,架构不同,单位成本差 3 到 10 倍。
一、为什么"越用越贵"
- 单个 Agent 任务消耗的 token 是单次聊天调用的 5 到 30 倍(Splunk,2026-06);
- 同一文档评估任务,单次结构化处理 1.34 美元/轮,迭代式 Agent 显著更高(MightyBot,2026-07 实测)。
单价在跌、用量在涨——决定账单的是架构,不是标价。
二、必埋的三个点
要度量重试成本,至少埋三处:
| 埋点 | 记什么 | 作用 |
|------|--------|------|
| 调用计数 | 每个判断点一天触发多少次 | 看清"单次小、频次高"的总量 |
| 轮次计数 | 含重试实际消耗几轮 | 最容易被漏、也最贵的一项 |
| 成功率 | 一次判定通过的比例 | 进成本公式的修正系数 |
三、成本公式
```
单位任务成本 = 单价 × 平均调用轮次 × 成功率修正
```
| 方案 | 单价 | 平均轮次 | 单位成本 | 结论 |
|------|------|---------|---------|------|
| A 便宜模型 | 低 | 3.2 轮 | 高 | 便宜在单价,贵在轮次 |
| B 贵模型 | 高 30% | 1.1 轮 | 低 | 贵在单价,省在轮次 |
| C 结构化输出 | 低 | ≈1 轮 | 更低 | schema 约束消除格式失败 |
四、失败从哪来
- 认知层:指令漂移、上下文过载、检索落空;
- 执行层:工具选错、参数非法、推理与行动不匹配;
- 工程层:结果不可用、状态未落库、上下游未适配。
微软 2026-10-09 发布的 AX Practitioner Playbook 总结 9 类反复出现的失败模式,强调"失败读数告诉你什么坏了,轨迹才告诉你为什么坏",配套方法已产出对 Azure Cosmos DB Agent Kit 的 46 项改进。
五、降本清单
1. 幂等 + 断点续跑:长任务拆成有状态小步骤,每步落库,失败从断点续跑;
2. 结构化输出替代"生成再解析":能枚举答案的判断用 schema 约束;
3. 上下文做减法:稳定前缀进 cache,完成步骤折叠成摘要;
4. 阈值熔断:单任务设最大轮次/花费,超限停下告警;
5. 失败当数据:统计一次通过率与平均轮次,优化高重试环节。
六、验证方法
从线上日志捞 20-30 个真实任务,分别用"现有做法"和"优化后做法"跑一遍,记录一次通过率、平均轮次、单位任务成本三个数,对比总消耗而非单价。半天能做完。
三句话
你付的不是一次调用的钱,而是它失败几次的钱。
一次调用便宜,不等于这笔任务便宜。
把失败重试显性化,才是省钱的第一步。
*《AI 成本账》系列第 5 篇。下一篇:当 AI 把试错成本降到接近零,为什么决策反而更慢了。*
*数据来源:Splunk(2026-06);MightyBot(2026-07 实测);Microsoft(2026-10-09)。*

 浙公网安备 33010602011771号