
拆开 Agent 的账单:为什么"判断"这一层值得一个专用模型
复盘一个内部 Agent 的账单,得到一个和直觉相反的结论:最花钱的不是它"写"的内容,而是它每天做的那上万次小判断。
顺着这条线索,我把 2026 年 9 月才出现的"专用决策模型"翻了一遍。这篇只讲工程:它省在哪、架构怎么切、什么时候别用。
一、先把"判断"和"表达"分开
在 Agent 里,这两件事的性质完全不同:
```python
# 判断:输出空间有限、可枚举
route = decide(msg) # {"billing":0.92, "tech":0.06, "other":0.02}
# 表达:输出空间无限
text = generate(msg) # 一段自由文本
```
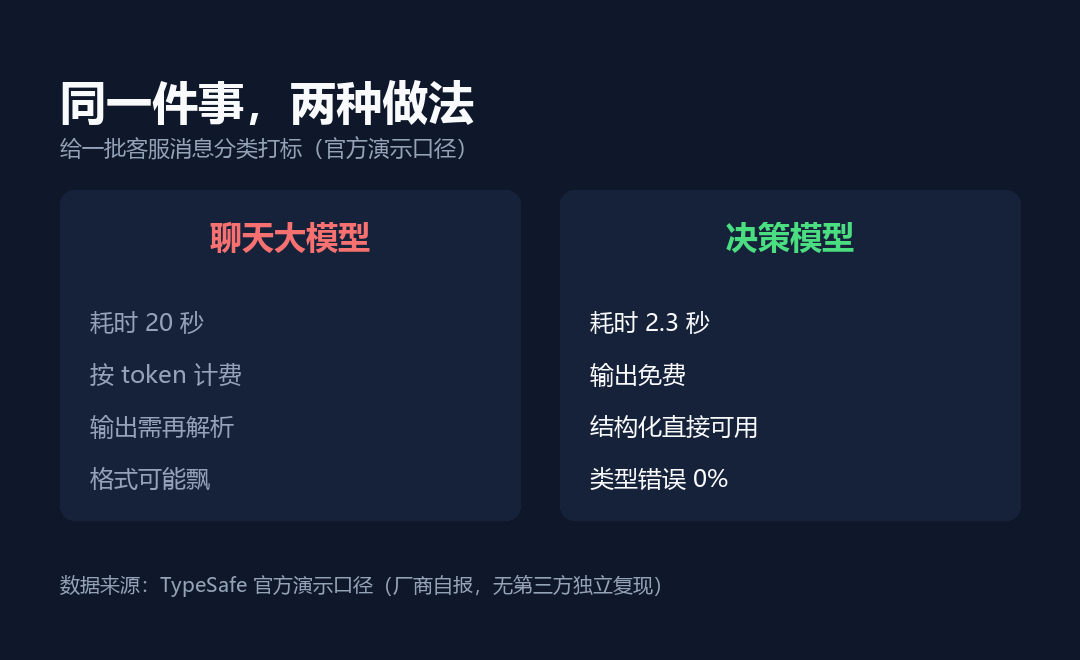
问题在于,过去我们用同一个工具干这两件事——都调通用大模型。于是"这条消息算不算投诉"这种只有两个答案的问题,也要走一整轮文本生成,再从生成的散文里解析结论。
代价是三重的:延迟以秒计;成本按生成 token 计(而输出里真正有用的可能就 3 个字符);脆弱——解析依赖格式稳定,模型一"发挥"下游就断。
二、专用决策模型砍掉了哪一段
TypeSafe 在 2026-09-15 发布的 Jev,给出的答案是把"生成"这一段整个砍掉:
| 原语 | 签名 | 输出 |
|------|------|------|
| `noul` | 是/否问题 | `float` 概率(0–1) |
| `choice` | 从 ≤255 个选项里选 | `str` + 每项概率 |
| `score` | 在 2–10 级标尺打分 | `float` + 概率分布 |
核心是输出空间预先声明:
```json
{
"questions": {
"category": {
"type": "choice",
"instructions": "这条工单属于哪一类?",
"criteria": { "billing": "账单/退款", "tech": "技术故障", "other": "其他" }
}
}
}
```
答案只能落在声明范围内,所以类型错误在结构上不可能发生(官方 0%,且明确说明这是 schema 保证而非实测值)。返回还带 `confidence`,用来校准你的决策阈值。
定价也顺着逻辑走:输入 $0.042/百万 token,输出免费——判断的输出本来就极短,按输出计费讲不通。
⚠️ 这些数字全部来自厂商自报,尚无大规模第三方独立复现。DataCamp 提醒 benchmark 为厂商自报;innFactory 认为它本质是分类器,原理不新,新在做成通用 schema 驱动 API。
三、架构怎么切:显式三层
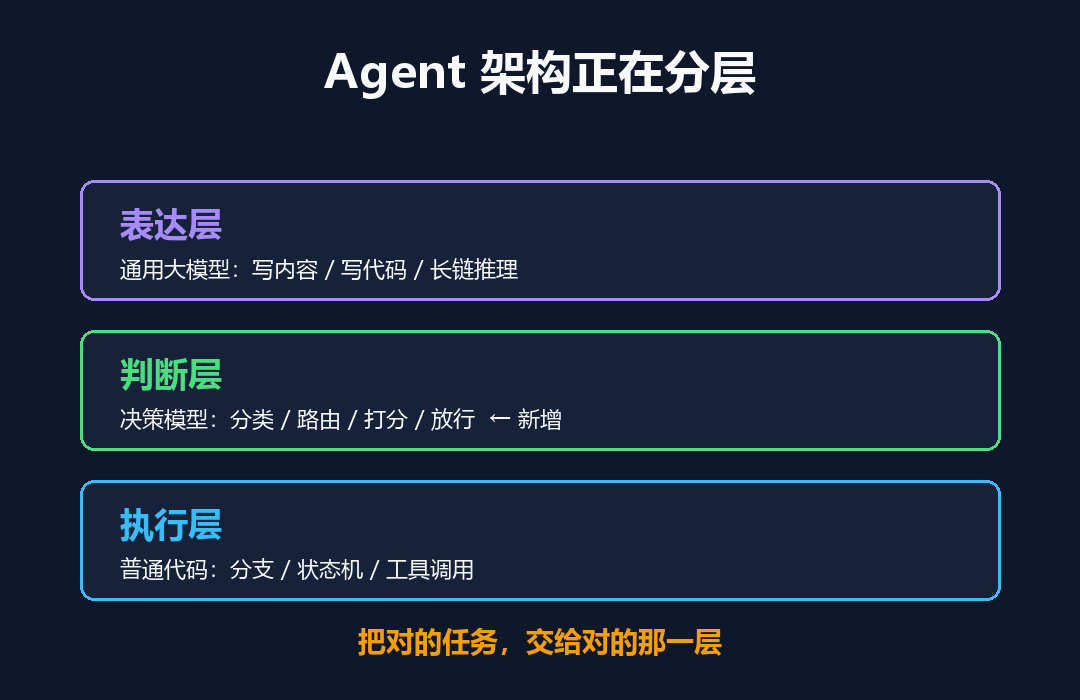
我的结论是,Agent 应该显式分成三层:
```
┌──────────────────────────────────────┐
│ 表达层 通用大模型 → 写内容 / 写代码 │
├──────────────────────────────────────┤
│ 判断层 决策模型 → 分类 / 路由 / 打分 │ ← 新增
├──────────────────────────────────────┤
│ 执行层 普通代码 → 分支 / 状态机 │
└──────────────────────────────────────┘
```
判断层的准入条件只有一个:答案能不能提前枚举。
成本模型要跟着改
别再比"每百万 token 单价",用单位任务成本:
```
单位任务成本 = 单价 × 平均调用轮次 × 成功率修正
```
模型 A 单价便宜 50% 但要 3 轮做对;模型 B 贵一点但一轮做对——总账 B 更省。决策模型的价值,就在于把"轮次"和"失败重试"压到接近 0。
四、什么时候不该用
- 答案列不出来 → 用大模型。硬凑选项只会让准确率崩;
- 调用量很小 → 直接 if/else 或调大模型更划算,不值得引入新依赖;
- 需要长链推理 → 它只做"一次判断",不解决多步规划;
- 需要保证判断正确 → 它保证结构正确,不保证答案正确,置信度是参考不是保证。
五、国内落地的现实路径
Jev 未对中国大陆开放,权重不开源,只能在官方 API 上调。 数据不能出网的团队,现实做法是开源复现 + 本地部署:用开源权重(如 Cloudflare 10-01 发布的 Clef/Clef-flash,Apache 2.0,且完全兼容 Jev API 格式)在自己机房起一个决策服务,业务系统 HTTP 调用。
值得一提:Cloudflare 直接抄了 Jev 的请求格式——这让 Jev 的接口成了品类事实标准,切换成本因此很低。
六、落地自检
1. 这些判断能不能提前枚举所有答案?
2. 一天发生多少次?(上万次才值得)
3. 对延迟敏感吗?
4. 现在的做法是不是"规则维护不动"或"大模型太贵太慢"?
5. 数据能不能出网?
答对三个,就值得花半天验证:拿真实的 20–30 个任务跑一遍完成率和总消耗,比看任何榜单都可靠。
三句话
判断不是写作,而是选择。
多轮试错的便宜,才是真的贵。
省钱的从来不是换个更便宜的模型,而是把对的任务交给对的那一层。
写在最后
大模型负责表达,决策模型负责判断——把作家从收发室的岗位上撤下来。
省钱的从来不是换个更便宜的模型,而是把对的任务交给对的那一层。
*这是《AI 成本账》系列第 4 篇。下一篇拆"Agent 的失败重试到底吃掉了多少预算"。*
*数据来源:TypeSafe 官方发布(2026-09-15);Cloudflare 开源公告(2026-10-01,Apache 2.0);葡萄城技术团队分析(博客园);Flavio Copes / Steve Kinney 技术解读;DataCamp、innFactory 第三方评述。性能与价格数字均为厂商自报口径。*

 浙公网安备 33010602011771号