【史】字符串科技 I
p话
做这个题单就行了(不是)
下面是正题。
Hash
就是将字符串转化为在模意义下的base进制数(称为哈希值),使得两两不相等(冲突)。如果单层哈希容易冲突可以考虑对一个字符串在多个模数下的不同的k进制数,一般两个就可以避免冲突。例如hash Lqs888,可以用 (19,998244353),(13331,2^64) 两个base&模数哈希。一般base和模数都要是质数,且较大可以较好保证不冲突。
code(手搓的没有编译过)
int hash(char *s,const int base,const int P)
//以base为进制,P为模数的s哈希值
{
    int n=strlen(s+1);
    int res=0;
    for(int i=1;i<=n;i++)
        res=(1ll*res*base+s[i])%P;
    return res;
}
KMP
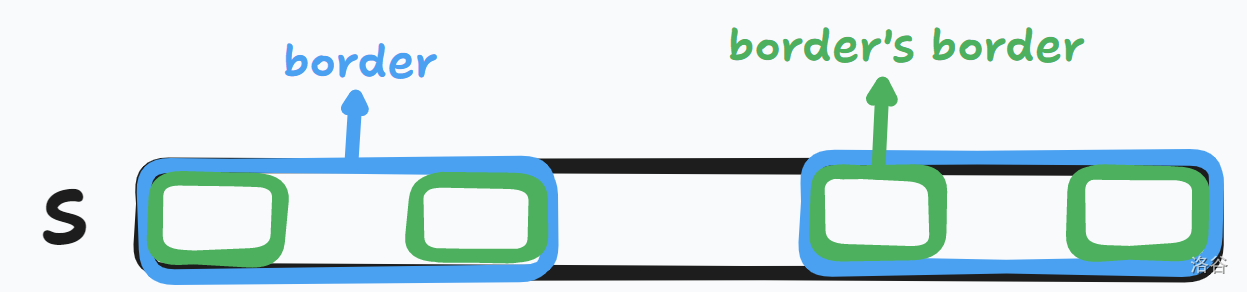
定义一个长度为 \(n\) 的字符串 \(s\) 的 border 为其满足 \(s_{1\sim i}=s_{n-i+1\sim n}\) 的 \(i\),这里 \(s_{l\sim r}\) 表示 \(s\) 的 \(l\sim r\) 的字符组成的子串。注意这里 \(i\not=n\)(但是可以为0),因为无意义(\(n\) 一定是 border)。
- 定理:\(s\) 的 border 的 border 是 \(s\) 的 border。
Proof:
那么KMP就是用来求一个长度为 \(n\) 的字符串 \(s\) 的所有前缀的最大的 border,其他的 border 可以通过跳 border 求出。
记 \(fail_i\) 为 \(s_{1\sim i}\) 的最大 border。考虑从左往右转移,就是在我们已经求出 \(1\sim i-1\) 的border 之后。发现可以从 \(i-1\) 的 border 转移,如果满足 \(s_{fail_{i-1}+1}=s_{i}\) ,那么 \(fail_i=fail_{i-1}+1\)(即 \(i-1\) 的 border 可以通过加上 \(s_i\) 变成 \(s_{1\sim i}\) 的 border)。但是如果不满足呢?那么就看看 \(i-1\) 的更短一点的 border 是否满足。如果不满足,就接着跳更小的 border,直到匹配为止。
时间复杂度为 \(O(N)\),但是我不会证。
code
void KMP(char *s)
{
    int n=strlen(s+1);
    for(int i=2;i<=n;i++)
    {
        int j=fail[i-1];
        while(j&&s[j+1]!=s[i]) j=fail[j];
        //由上面的定理可知一直跳border即可求出所有s[1~i-1] 的border
        //如果跳到0就没法跳了
        if(s[j+1]==s[i]) j++;
        fail[i]=j;
    }
}
那么求出 border 有什么用呢?可以进行字符串的匹配。如给出串 \(s\) 和 \(t\),求 \(t\) 在 \(s\) 中哪些位置出现。这里称 \(t\) 为匹配串,\(s\) 为模式串。
考虑现在已经匹配了 \(s\) 的前 \(i-1\) 个位置,\(t\) 匹配到了第 \(j\) 个字符。同样的,考虑 \(s_i\) 是否等于 \(t_{j+1}\),如果相等,那么就是匹配上了。否则,考虑将 \(j\) 跳到其最大的 border,因为这样子依然满足匹配(可以自己画图理解一下)。如果还是不满足就一直跳,直到满足为止。
时间复杂度:\(O(N)\),我还是不会证。
code
void solve(char *s)
{
    int m=strlen(s+1);
    //t为匹配串且长度为n
    for(int i=1,j=0;i<=m;i++)
    {
        while(j&&s[i]!=t[j+1]) j=fail[j];
        if(s[i]==t[j+1]) j++;
        if(j==n) pos.push_back(i);
        //t完全与s匹配
    }
}
失配树
就是对于KMP求出的 \(fail\),连 \(fail_i\rightarrow i\) 的边。
失配树性质:
- 是一棵有根树。
- 对于 \(i\),其祖先为 \(i\) 的所有 border。
- 对于 \(i,j\),其最长的公共 border 为 \(LCA(fail_i,fail_j)\)。
ExKMP
也称 \(z\) 函数,\(z_i\) 表示 \(s_{i\sim n}\) 与 \(s\) 的最长公共前缀长度。考虑现在已经求出了 \(z_{1\sim i-1}\),要求 \(z_i\),怎么求。
记 \(r=\max_{j<i}\{j+z_j-1\}\),即最大的覆盖到的右端点,满足 \(r=j+z_j-1\) 的那个 \(j\) 记为 \(x\)。
如果 \(i\le r\),就可以借助这个进行转移。先看图。
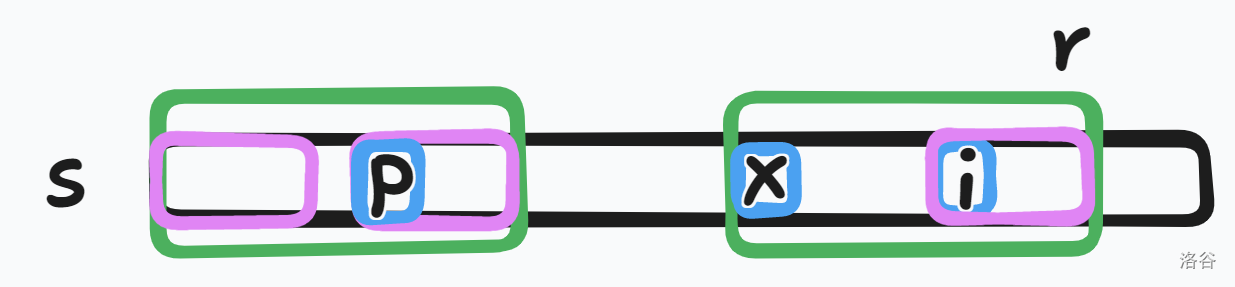
这里,因为 \(i\le r\) 且 绿色的段都一样,那么以 \(i\) 开头的串就等于以 \(p=i-x+1\) 开头的串,所以就可以从 \(z_p\) 转移。注意要与 \(r-i+1\) 取min,因为超过绿色的部分我们不能保证是一样的。
那么现在不管有没有 \(i\le r\) 都可以直接暴力拓展。
时间复杂度 \(O(N)\),反正我都不会证。
code
void ExKMP(char *s)
{
    int n=strlen(s+1); r=x=0;
    for(int i=2;i<=n;i++)
    {
        if(r>=i) z[i]=min(z[i-x+1],r-i+1);
        while(i+z[i]<=n&&s[i+z[i]]==s[1+z[i]]) z[i]++;
        if(i+z[i]-1>r) r=i+z[i]-1,x=i;
	}
	z[1]=n;//注意由于是真后缀,所以z[1]一开始是0,最后要设为n
}
假如询问 \(s\) 与 \(t\) 每个后缀的最长公共前缀长度,那么可以用exKMP求出。先对 \(s\) 求出其 \(z\) 函数,然后如下图:
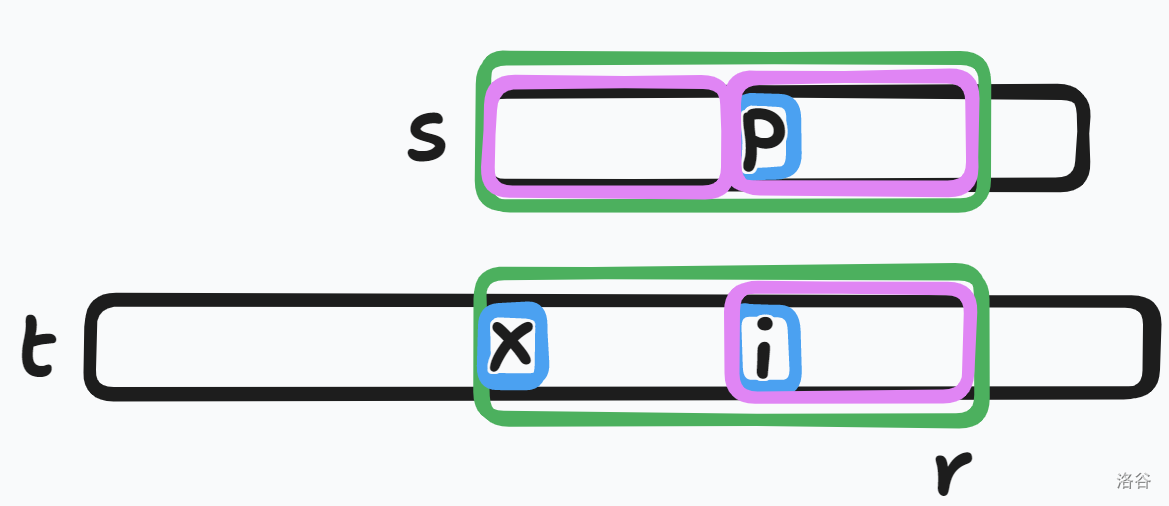
同求 \(z\) 函数的过程,假设现在在求 \(t_{i\sim n}\) 的答案,\(1\sim i-1\) 的答案已经求出。令 \(r=\max_{j<i}\{j+ans_j-1\}\),且满足 \(r=j+ans_j-1\) 的 \(j\) 记作 \(x\),则如果 \(i\le r\),那么 \(i\) 可以由 \(x\) 位置的匹配对应到 \(s\) 串上的 \(p=i-x+1\) 的位置,粉色部分的都是同样的串,然后就可以由 \(z_p\) 转移过来了。一样地,也要和 \(r-i+1\) 取min,因为超出部分不能保证相等。
code
void solve(char *t)
{
    int n=strlen(t+1); r=x=0;
    for(int i=1;i<=n;i++)
    {
        if(r>=i) p[i]=min(z[i-x+1],r-i+1);
        while(i+p[i]<=n&&t[i+p[i]]==s[1+p[i]]) p[i]++;
        if(i+p[i]-1>r) r=i+p[i]-1,x=i;
    }
}
周期
- 定义长度为 \(n\) 的串 \(s\) 有周期 \(p\) 当且仅当其满足 \(\forall 1\le i\le n-p+1,s_i=s_{i+p}\)。(也是由一个 \(s\) 的前缀重复若干次截取能得到 \(s\) 的叫做周期)。
- 定义整周期 \(p\) 为 \(p|n\) 的周期。
- 周期与 border 一一对应。
Proof:
设 \(s=a+b+a\),其中 \(a\) 为 border,显然 \(s\) 有周期 \(a+b\),且反射也是一一对应的。
- 弱周期定理:对于 \(s\) 的周期 \(p,q\),如果有 \(p+q\le n\),则 \(\gcd(p,q)\) 也是 \(s\) 的周期。
Proof:
不妨设 \(p>q\)。令 \(d=p-q\),考虑证明 \(d\) 是 \(n\) 的周期。
对于 \(q<i\),有 \(s_i=s_{i-q}=s_{i-q+p}=s_{i+d}\)。
对于 \(i<p\),有 \(s_i=s_{i+q}=s_{i+q-p}=s_{i-d}\)。
显然这两个范围是包含的,所以 \(d\) 是 \(s\) 的周期。
由辗转相除法得 \(\gcd(p,q)\) 为 \(s\) 的周期。
- 周期定理:对于 \(s\) 的周期 \(p,q\),如果有 \(p+q-\gcd(p,q)\le n\),则 \(\gcd(p,q)\) 也是 \(s\) 的周期。
Proof:不会证啊(逃。
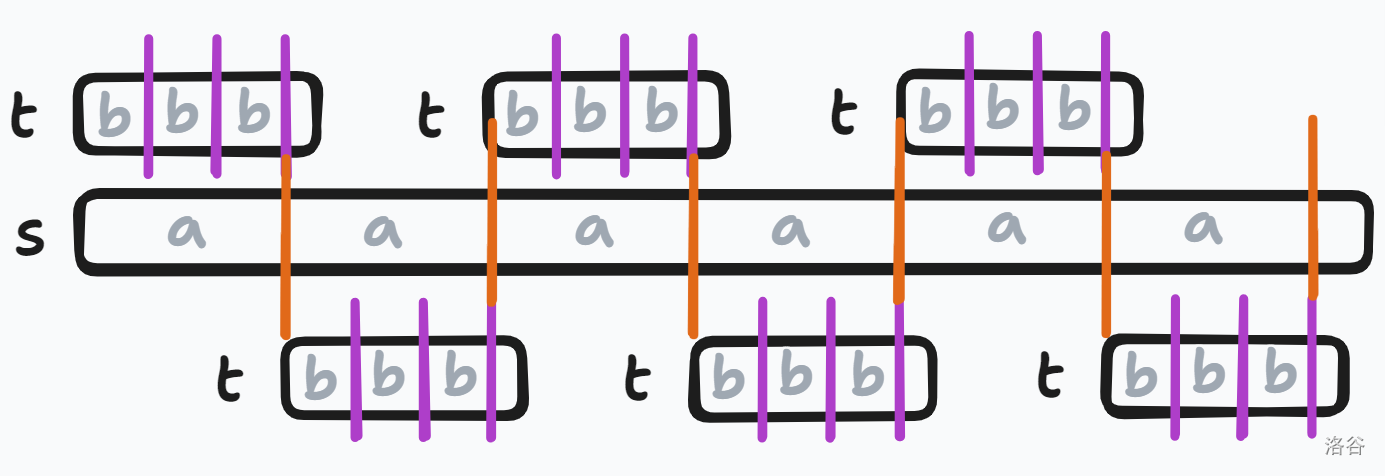
- 约束周期定理:对于一个串 \(s\) 和其前缀 \(t\),若 \(s\) 有周期 \(a\),\(t\) 有周期 \(b\),且 \(b|a\),则 \(s\) 也有周期 \(b\)。
Proof:
- 定理:长度为 \(n\) 的串 \(s\) 的所有长度不超过 \(\frac{n}{2}\) 的周期构成一个等差数列。
Proof:
由弱周期定理可知,对于周期 \(p,q\),\(\gcd(p,q)\) 也一定在这个数列中。考虑这个数列的最小值 \(m\),其一定是满足 \(\forall p,\gcd(m,p)=m\),否则一定存在更小的周期。然后由此可得所有的周期都是 \(m\) 的倍数,所以所有的周期都一定可以是 \(m\) 重复若干次得出。
所以这个数列一定是 \([m,2m,3m,4m,\ldots,km]\),即为等差数列。
- 定理:长度为 \(n\) 的串 \(s\) 的所有长度超过 \(\frac{n}{2}\) 的 border 构成一个等差数列。
Proof:
同上。
- 定理:长度为 \(n\) 的串 \(s\) 的 border(周期)可以划分为 \(O(\log n)\) 个等差数列。
Proof:
对于长度超过 \(\frac{n}{2}\) 的 border,可以直接划分。
对于剩下的 border,它们都是剩余最长 border 的 border,于是变成了子问题。
每次问题规模除以2,个数是 \(O(\log n)\) 的。
Trie
Trie 就是字典树。一个字典树为每个节点代表一个字符串的树。例如,令一棵字典树的每一个出边代表在字符串后面加上一个字符。下面是一个例子。
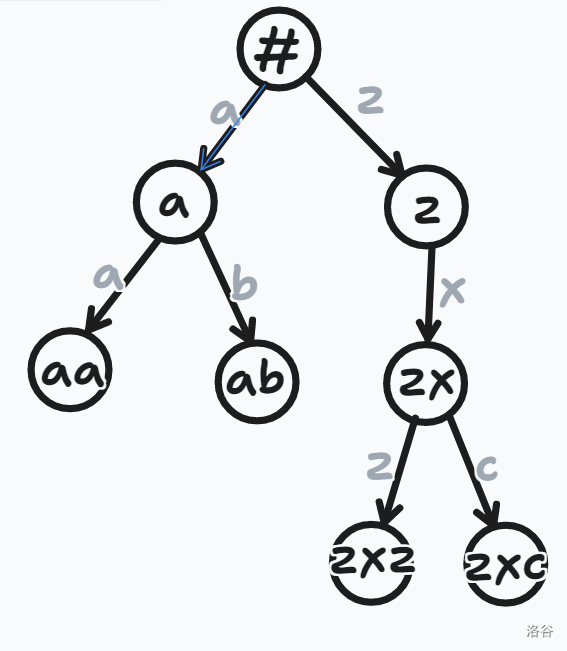
# 是根,代表空字符串。每个出边是一个字符,每个节点是从根到自己路径上的字符组成的字符串。这种字典树可以快速查询对于给定串的在字典树中的前缀的权值和。下面将讨论这种字典树如何实现。
如何将一个串插入字典树?考虑当前到了节点 \(u\),且目前要插入的串 \(s\) 插入到第 \(i\) 位,那么我们就应该走到 tr[u][s[i]] 节点。如果没有这个节点,那就新开一个。总共的节点个数为 \(O(\sum|s|)\)。
时间复杂度为 \(O(|s|)\)。
code
void insert(char *s)
{
    int n=strlen(s+1),u=0;//0为根
    for(int i=1;i<=n;i++)
    {
        int &v=tr[u][s[i]]; //引用可以少打一点字(
        if(!v) v=++tot;
        u=v;
    }
    tag[u]++;//标记这里是一个给出字符串,用++是因为有可能有同样的串
    val[u]=...;//表示u节点的权值
}
那么给出一个串 \(s\),如何查询作为 \(s\) 的前缀的已经插入字典树的串的权值呢?
同样地,类似插入的跳节点。但是要是没有要去的节点就直接return了。
时间复杂度是 \(O(|s|\times m)\),其中 \(m\) 为合并权值的时间复杂度。
code
int ask(char *s)
{
    int n=strlen(s+1),u=0,res;
    for(int i=1;i<=n;i++)
    {
        int v=tr[u][s[i]];
        if(!v) return res;//走不了就返回
        res=merge(res,val[v]);//合并权值
    }
    return res;
}
AC自动机
KMP因为一个匹配串的 border 预处理是 \(O(N)\) 的,所以可以快速处理多模式串的匹配。
但是如果给出多匹配串,求匹配一个模式串呢?那么KMP的复杂度就超时了。那么我们考虑新的算法。
AC自动机可以解决这一问题。AC自动机可以说是KMP+Trie。首先我们要把每个匹配串加入到Trie中,然后求出每个节点的 \(fail\),表示该节点表示的字符串在Trie中存在的最长真后缀的节点。这里,长度为 \(n\) 的串 \(s\) 的真后缀表示长度满足小于 \(n\) 的后缀。
那么怎么求呢?考虑现在已知 \(u\) 节点的 \(fail\),求其儿子 \(v=tr_{u,c}\) 的 \(fail\)。类似于KMP,看 \(fail_u\) 这个节点是否存在 \(c\) 这个出边。如果存在,则表示在Trie中存在对于 \(fail_u\) 这个节点代表的字符串接上 \(c\) 这个串。那么 \(fail_v=tr_{fail_u,c}\)。否则,因为 \(s\) 后缀的后缀是 \(s\) 的后缀,所以从 \(fail_u\) 跳到 \(fail_{fail_u}\),再看看是否有 \(c\) 这个出边。不然就一直跳,直到匹配为止。
code(求fail的过程)
void bfs()
{
	queue<LL> q;
	for(int i=0;i<26;i++)
		if(tr[0][i]) q.push(tr[0][i]);//根的儿子的fail为根
	while(q.size())
	{
		LL u=q.front(); q.pop();
		for(int i=0;i<26;i++)
		{
			LL v=tr[u][i];
			if(!v) continue;
			LL j=fail[u];
			while(j&&!tr[j][i]) j=fail[j];
			if(tr[j][i]) j=tr[j][i];
			fail[v]=j;
			q.push(v);
		}
	}
}
那么怎么匹配模式串呢?同KMP。如果当前这个匹配节点 \(u\) 没有 \(s_i\) 的出边,那么就跳后缀。
code
void solve(char *s)
{
    int u=0,n=strlen(s+1);
    for(int i=1;i<=n;i++)
    {
        while(!tr[u][s[i]]&&u) u=fail[u];
        if(tr[u][s[i]]) u=tr[u][s[i]];
        d[u]++;//只记录最长的匹配串,对于更短的匹配串用下面的性质求出。
    }
}
AC自动机的fail树
性质:
- 是一棵有根树。
- 对于 \(i\),其祖先为 \(i\) 的所有后缀。
- 对于 \(i\) 在 \(s\) 中的出现次数为以其为根的字数内的恰好匹配的次数之和。
求每个匹配串真实出现次数
int dfs(int u)
{
    for(auto v:e[u]) d[u]+=dfs(v);//e存的是fail树
    for(auto i:tag[u]) f[i]=d[u];//tag[u]存的是以u为结尾的模式串的id
    return d[u];
}
Manacher
给定字符串 \(s\),询问 \(s\) 的最长回文子串长度。
使用Manacher算法求出。Manacher可以求出以每一个 \(i\) 为中心的最长回文半径。为了方便,我们在每个字符中间插入一个不在 \(s\) 的字符集中的字符,这样就可以使得偶回文串也有回文中心。例如:Lqs314 插入之后变成 #L#q#s#3#1#4#,至于为什么在两边插入,在下面的实现有帮助。
记 \(d_i\) 为以 \(i\) 为中心的最长回文半径,这里是包括 \(i\) 的。例如 #a#a#a#b# 的第4个字符 a,\(d_4=4\)。
那么类似ExKMP,记录 \(r=\max_{j<i}\{j+d_j-1\}\),满足 \(r=j+d_j-1\) 的 \(j\) 记作 \(x\)。若 \(i\le r\),则有:
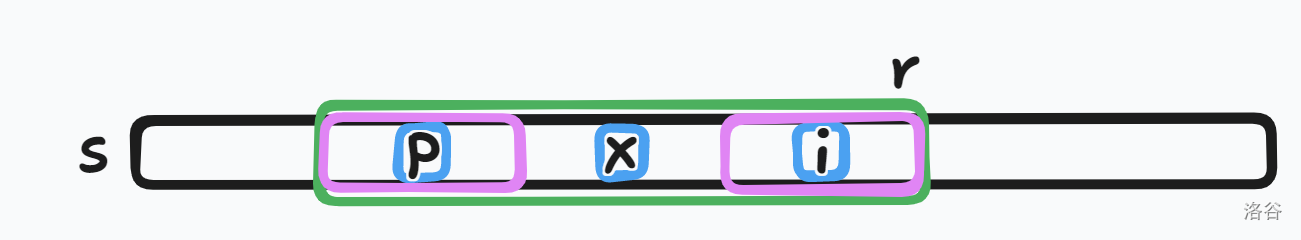
\(i\) 可以根据 \(x\) 对称到 \(p=2i-x\),然后粉色部分就是一样的,所以 \(d_i\) 就可以从 \(d_p\) 转移。但是超出绿色部分的我们不能保证是相同的,所以要对 \(r-i+1\) 取min。
之后就暴力拓展。复杂度 \(O(N)\),还是不会证。
code
int manacher(char *s)
{
    int n=strlen(s+1);
    int tot=2,mid=2,r=2,ans=1;
    t[1]='$'; t[2]='#';
    //最两边还要再插入两个不同的字符,防止一直拓展
    for(int i=1;i<=n;i++) t[++tot]=s[i],t[++tot]='#';
    t[++tot]='&';
    for(int i=2;i<tot;i++)
    {
        if(i<r) d[i]=min(r-i,d[mid*2-i]);
        //为了方便代码书写,这里记的r实际是上面说明算法过程的r+1,这样可以避免很多+1 -1
        else d[i]=1;
        while(t[i-d[i]]==t[i+d[i]]) d[i]++;
        if(i+d[i]>r) r=i+d[i],mid=i;
        ans=max(d[i]-1,ans);
        //这里回文串在原串中的长度就是回文半径-1
        //如果不在两边插入#,则匹配到原串两个端点的回文半径会少一,那么就不对了
    }
    return ans;
}
- 定理:manacher取min的那个函数的参数中,每一次min的较大者减去较小者的和是 \(O(N)\) 的。
Proof:
不会。用处是当你把manacher套到什么东西上时,区间的权值不好快速求但是单点能快速求,那么这个取min的过程就可以暴力跳。
例题: 逆にする関数
回文与border
- 回文串的回文后缀与 border 一一对应。
Proof:
对于一个回文后缀一定有一个同样的回文前缀,所以是 border。
- 回文串的 border 一定是个回文串。
Proof:
由上可证。
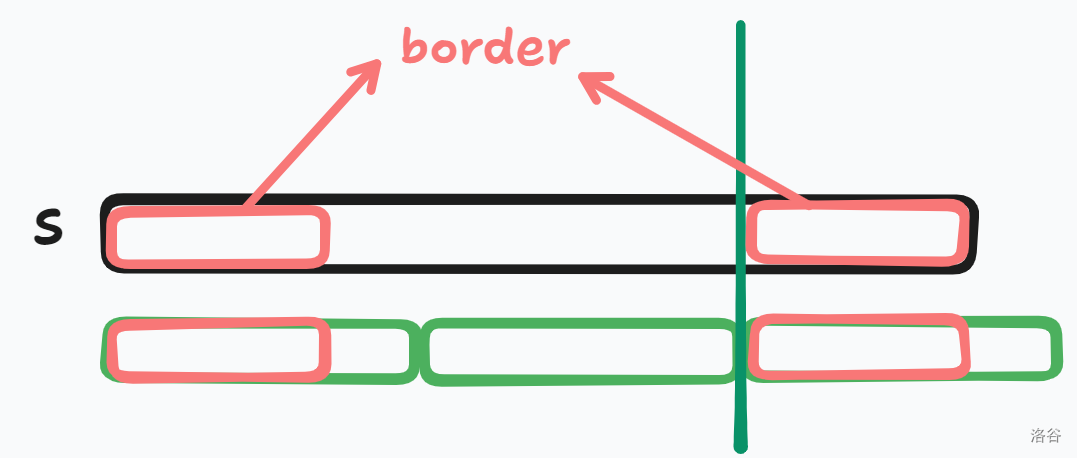
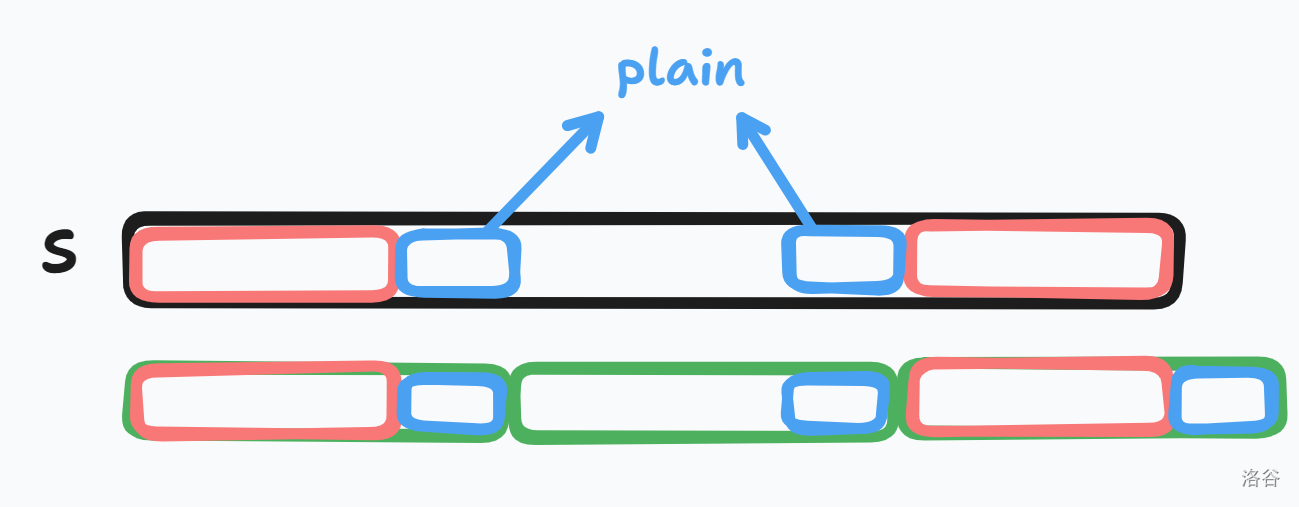
- 若回文串 \(s\) 有周期 \(p\),则一个循环节必然可以被拆成两个回文串,且长度为 \((|s|\mod p),p-(|s|\mod p)\)。
Proof:
图中绿色表示 \(s\) 的周期,则粉色表示上述定理中的长度为 \(|s\mod p|\) 的串,然后根据周期,得到这个是 \(s\) 的 border,所以它是回文串。
然后证长度为 \(p-(|s|\mod p)\) 的那个串为回文
(这里plain打错了,是palin,表示回文)
蓝色部分就是这个串,然后根据周期,可以将其放在粉色串的内侧,然后因为 \(s\) 是回文串,就易证是回文。
- 设 \(t\) 为回文串 \(s\) 的最长严格回文前(后)缀,若 \(2|t|\ge |s|\),那么 \(t\) 只会在 \(s\) 中恰好匹配两次,分别作为前缀和后缀。
Proof:
首先 \(t\) 至少会在 \(s\) 中出现两次,因为它是 border。
考虑证明 \(t\) 不会在 \(s\) 中出现超过两次。如果 \(t\) 出现超过两次,那他们的匹配位置构成一个等差数列(这一句话我不会证),那就可以根据回文构造出一个更长的回文前缀。
回文自动机(PAM)
回文自动机是trie,从节点 \(u\) 连向另一个节点 \(v\) 一条边权为 \(w\) 的边表示在 \(u\) 表示的串旁边加上 \(w\)。
例如,这是一个回文自动机中的trie。
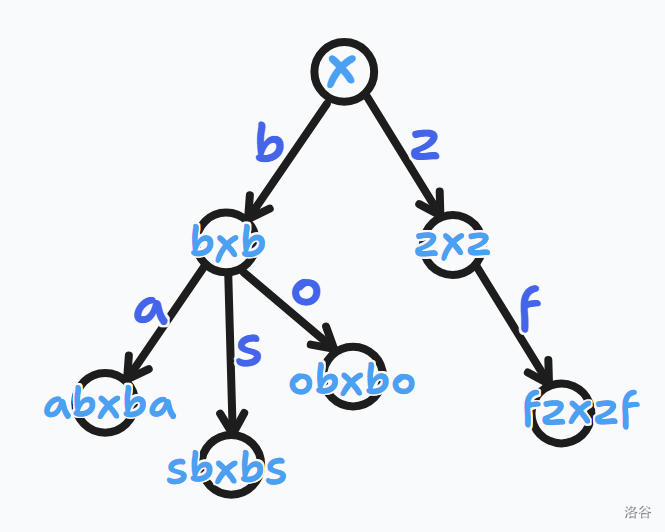
回文自动机中每个节点表示一个串 \(s\) 的一个回文的子串(每个节点表示的串互不相同)。因为通过上图中的方式,偶回文串只能变成偶回文串,奇回文串只能变成奇回文串。所以我们要维护两棵trie,一个是偶串,根表示的串长度为 \(0\);一个是奇串,根表示的串长度为 \(-1\)。
考虑如何去构造出回文自动机。使用增量法,从维护好 \(s_{1\sim i-1}\) 的回文自动机增加新的回文后缀变成 \(s_{1\sim i}\) 的回文自动机。
- 定理:每添加一个字符,至多新增一个新的本质不同的回文串,且是所有回文后缀中最长的。
Proof:
新增的回文后缀中,考虑最长的那个回文后缀,那么其他的回文后缀一定值那个最长的回文后缀的 border,故之前出现过。
- 推论:回文自动机的节点个数为 \(O(|s|)\) 个。
所以回文自动机的空间复杂度为 \(O(|s|)\)。
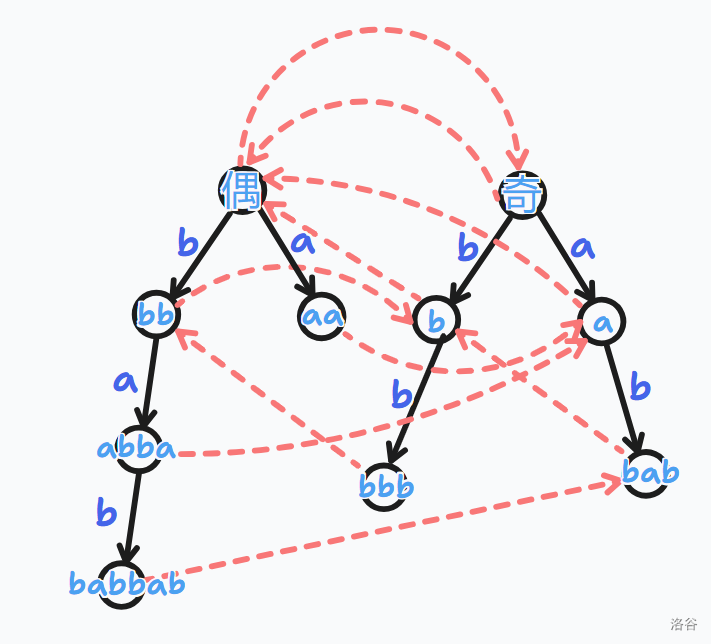
然后考虑如何找到这个最长的新增的回文后缀。考虑维护每个节点的 \(fail\),\(fail_u\) 表示 \(u\) 节点的最长回文真后缀是哪个节点。
这是一个例子。其中粉色虚线表示 \(fail_u\) 所指向的节点。
细节:
- 对于一个单个字符的串,其 \(fail\) 指向偶根。
- 对于偶根和奇根,他们是相互指的。
具体原因,在下面分析。
当你插入一个字符 \(s_i\) 的时候,考虑与 \(s_{1\sim i-1}\) 的最长回文后缀拼接。如果拼接不上就跳 \(fail\),直到该后缀的前一个字母等于 \(s_i\) 为止。在最终跳到的后缀两边加上 \(s_i\),就是我们所需要的最长的回文后缀。
好,那解释一下为什么要这样连 \(fail\)。当你插入一个字符的时候,你可能跳跳跳,最后发现只有 \(s_{i-1\sim i}\) 是最长的回文后缀,此时你跳到的后缀为偶根,即长度为 \(0\)。所以单个字符要指向偶根。也可能你跳跳跳,最后发现只有 \(s_i\) 自己单独成为一个回文串,此时你应该调到了奇根。所以偶根要指向奇根。
代码如下。
code
LL getfail(LL u,LL p)
{
	while(s[p-len[u]-1]!=s[p]) u=fail[u];//跳到匹配为止
	return u;
}
void ins(LL x) //插入s[x]
{
	LL u=getfail(z[x-1],x); //找到第一个匹配的位置
	int v=tr[u][s[x]-'a']; //指向新增最长后缀应该去的节点。
    //注意,这里不能用取地址符号偷懒&,原因在下面解释
	if(!v) //看看原本这个节点是否存在
	{
		v=++tot;
		len[v]=len[u]+2;
		fail[v]=tr[getfail(fail[u],x)][s[x]-'a'];
        //注意这里求fail不能是tr[getfail(u,x)][s[x]-'a'],否则会让v认为它的fail是自己
		dep[v]=dep[fail[v]]+1;
		tr[u][s[x]-'a']=v;
	}
	z[x]=v; //维护x结尾的最长回文后缀
}
void PAM()
{
	n=strlen(s+1);
	LL last=0;
	s[0]='#'; len[1]=-1; //1为奇根,0为偶根
    //注意给s[0]设成一个在字符集以外的字符,充当边界
	fail[0]=1; fail[1]=0; //相互连fail
	for(int i=1;i<=n;i++) ins(i); //插入每个字符
}
解释上面不能用&偷懒的原因:
考虑要建立奇根下的点时,\(fail_1\) 为 \(0\),然后发现偶根匹配不上,于是又跳到 \(1\)。如果此时建立了 \(v\),则 tr[getfail(fail[u],x)][s[x]-'a'] 就会指向 \(v\),就不对了。
常见应用
-
求本质不同回文串数。
即回文自动机的结点个数。
-
求在各个位置结尾的回文串数。
即那个点的对应位置的终止链上的点个数。
-
求公共回文串数。
回文自动机相同点个数。
最小回文划分
给定串 \(s\),将其划分成最少的回文串的个数。
容易想到设dp状态 \(f_i\) 表示前 \(i\) 个字符需要的最少的划分个数。
有转移 \(f_i=\min\limits_{j<i,s_{j+1\sim i}\ is\ plain}f_j+1\)
这样暴力做是 \(O(n^2)\) 的,我们考虑更快的做法。
考虑构造回文自动机,对于每个节点,记 \(dif_u=len_u-len_{fail_u}\)。\(slink_u\) 表示深度最大的满足 \(dif_x \not=dif_u\) 的 \(x\),其中 \(x\) 为 \(u\) 在fail树上的祖先。这些可以在构造回文自动机的时候顺便计算。
- \(u\) 到 \(slink_u\) 路径(这里指fail树,不包括 \(slink_u\))上的点构成了一个等差数列。
那考虑利用 border 可以被划分成 \(O(\log |s|)\) 个等差数列的性质,一次性处理一个等差数列的转移。
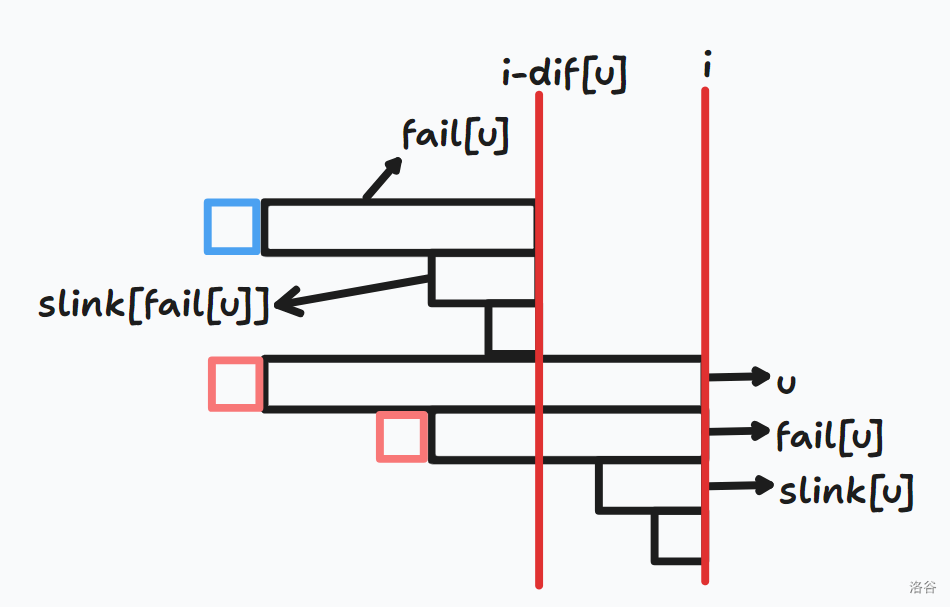
考虑维护 \(g_u\),表示 \(u\) 所在的的等差数列(不算 \(slink_u\))的 \(f\) 的值的并,这里指最小值。假设当前枚举到 \(i\),然后现在转移粉色代表的 \(f_j\) 组成的等差数列。每次对于一个等差数列,从蓝色加上一个新增的 \(f_{i-slink_u-dif_u}\) 转移过来就好了。然后跳下一个等差数列(\(slink_u\) 开头)。
为什么不能把 \(slink_u\) 的贡献算入当前等差数列?我也不是很明白,但是我现在大概推测是这样的:
对于当前枚举的 \(i\),然后PAM上的节点为 \(u\),如果把 \(slink_u\) 算入当前等差数列的话,则\(g_u=merge(g_{fail_u},f_{i-len_{slink_u}})\),如果 \(fail_u\) 最后的出现位置是作为某个节点的 \(slink\) 出现的话,那就会统计到旧的 \(fail_u\),答案就不对。
每次更新复杂度 \(O(\log)\),总时间复杂度为 \(O(|s|\log |s|)\)。
code
void solve()
{
	n=strlen(s+1);
	LL last=0;
	s[0]='#'; len[1]=-1;
	fail[0]=1; fail[1]=0;
	for(int i=1;i<=n;i++) ins(i);
	for(int i=0;i<=tot;i++) g[i]=1e16;
	for(int i=1;i<=n;i++)
	{
		f[i]=1e16;
		for(LL u=z[i];u>1;u=slink[u])
		{
			g[u]=f[i-len[slink[u]]-dif[u]]+1;
			if(slink[u]!=fail[u]) g[u]=min(g[u],g[fail[u]]);
			f[i]=min(f[i],g[u]);
		}
	}
}
由于这种做法把所有的转移都转移到了,所以也可以用于计数什么的。
例题
这个题考验你的洞察力。考虑构造字符串 \(t=s_1s_ns_2s_{n-1}s_3s_{n-2}...\),然后答案转化为将 \(t\) 划分成偶回文串的方案数。
[2017 山东一轮集训 Day4] 基因
题意是给定一个字符串 \(s\),\(q\) 次询问区间本质不同子回文串个数。强制在线。
先考虑离线做法,类似于 HH的项链,右端点扫描线,然后处理以 \(r\) 结尾的最长回文后缀的子回文串。在上一次出现的位置减 1,在这一次的出现位置加 1。
注意:这里说的出现位置是指回文串开头所在的位置。
然后同样地,利用最长回文划分的方法,将新增的回文串划分为 \(O(\log)\) 个等差数列,然后一次性处理这些贡献。因为是等差数列,所以很多位置都被+1-1,最后不变,只有开头和结尾有变化。于是可以在 \(O(\log^2)\) 的复杂度完成更新。
在线就用可持久化线段树维护即可。
后缀数组
对于长度为 \(n\) 的一个串 \(s\),记后缀数组 \(SA_i\) 在所有后缀中,排名为 \(i\) 的后缀为 \(s_{SA_i\sim n}\)。记 \(rk_i\) 表示后缀 \(s_{i\sim n}\) 的排名。
如何快速求出 \(SA\) 数组?考虑倍增法,假设现在已经处理好了每个以 \(s_i\) 开始的长度为 \(len\) 的串的 \(SA\),则我们可以通过将两个这样的串拼在一起,然后根据两个串现在的 \(rk\) 求出长度为 \(2len\) 的 \(SA\)。考虑基数排序,以第一个串的ranking为第一关键字,第二个串的ranking为第二关键字,因为字符串题一般字符集都很小。
过程大概是这样的:
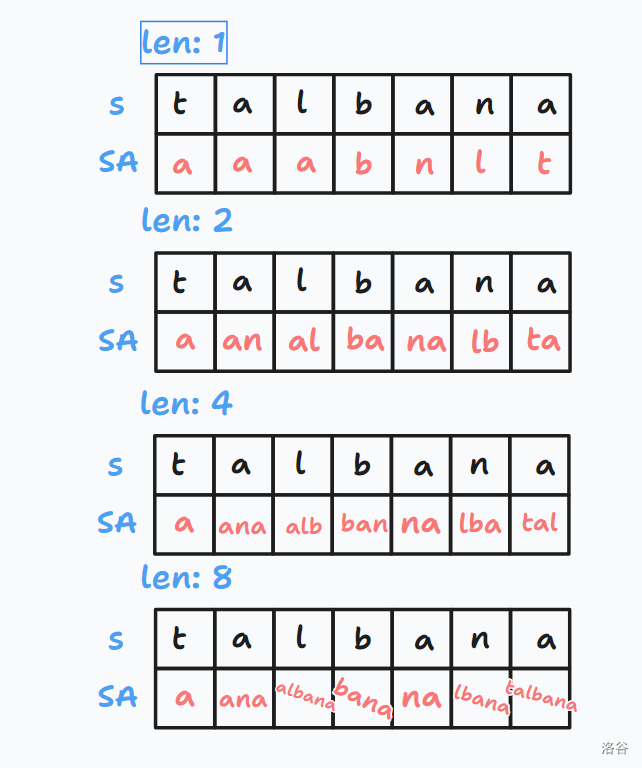
实际这个过程 SA 中存的是下标。
code
char s[N];
LL sa[N],o[N],rk[N],rk2[N],sb[N];
void SA(char *s)
{
	LL n=strlen(s+1),W=128; //W为字符集大小
	for(int i=0;i<W;i++) o[i]=0;
	for(int i=1;i<=n;i++) rk[i]=s[i],o[s[i]]++; //rk可以重复
	for(int i=1;i<W;i++) o[i]+=o[i-1];
	for(int i=n;i>=1;i--) sa[o[s[i]]--]=i; //基数排序,先做一遍前缀和,然后倒着把东西一个一个放进去
	for(int len=1;len<=n;len<<=1) //枚举当前合并的串的长度
	{
        //先以第二关键字排序
		LL T=0;
		for(int i=n-len+1;i<=n;i++) sb[++T]=i; //把没有第二关键字的后缀拎出来,他们的第二关键字最小
		for(int i=1;i<=n;i++) if(sa[i]>len) sb[++T]=sa[i]-len; //按照第二关键字排名从小到大加入后缀
        //sa[i>len] 判断s[sa[i]~sa[i+len-1]]是否是某个串的第二关键字
		for(int i=0;i<W;i++) o[i]=0;
		for(int i=1;i<=n;i++) o[rk[i]]++;
		for(int i=1;i<W;i++) o[i]+=o[i-1];
		for(int i=n;i>=1;i--) sa[o[rk[sb[i]]]--]=sb[i]; //再按照第一关键字排序
		swap(rk,rk2); //交换两个rk数组
		rk[sa[1]]=1; //处理当前的rk数组
		for(int i=2;i<=n;i++)
			rk[sa[i]]=rk[sa[i-1]]+(rk2[sa[i]]!=rk2[sa[i-1]]||rk2[sa[i]+len]!=rk2[sa[i-1]+len]);
            //两个关键字不同就说明排名是比上一者加一的
		if(rk[sa[n]]==n) break; //如果已经能够使得所有的排名都不一样,那就是排好了
		W=rk[sa[n]]+1; //优化,每次更新值域
	}
}
其实我在写这个代码的注释的时候才第一次看懂这份代码。
最长公共前缀
后缀数组就排个序,没什么用。很多时候用到 LCP 来辅助做题。
记 \(lcp(i,j)\) 为 \(suf(sa_i)\) 和 \(suf(sa_j)\) 的最长公共前缀。其中 \(suf(i)=s_{i\sim n}\)。
- \(lcp(i,j)=lcp(j,i)\)
- \(lcp(i,j)=n-sa_i+1\)
- \(\forall i\le k \le j,lcp(i,j)=\min(lcp(i,k),lcp(k,j))\)
Proof:
随着 \(j\) 增大,\(lcp(i,j)\) 一定是递减的。
- \(lcp(i,j)=\min\limits_{i<k\le j}\{lcp(k-1,k)\}\)
Proof:
由上面的定理拆开可得。
于是我们可以设 \(h_i=lcp(i-1,i)\)。所以我们可以很快地通过 RMQ 求出 \(lcp(i,j)\)。那么考虑求出 \(h\) 数组。
- \(h_{rk_i}\ge h_{rk_{i-1}}-1\)
于是我们可以通过按照 rk 的顺序,递推地求出。
for(int i=1,k=0;i<=n;i++)
{
    if(rk[i]==1) continue;
    if(k) k--;
  	while(s[i+k]==s[sa[rk[i]-1]+k]) k++;
    h[rk[i]]=k;
}
后缀自动机(SAM)
\(s\) 的 SAM 是一个自动机,满足:
- 转移边是字符
- 根节点到每个点的一条路径与 \(s\) 的一个子串一一对应
定义 \(endpos(t)\) 表示子串 \(t\) 在 \(s\) 中的所有的结束位置所组成的集合。SAM 的每个节点代表一个 \(endpos\) 等价类,即从节点 \(u\) 到根的所有路径所表示的子串由 \(u\) 管辖,且他们的 \(endpos\) 一样。
一些定理:
- 定理1:对于任意两个子串 \(u\) 和 \(v\)(不妨设 \(|u|<=|v|\))。若 \(u\) 是 \(v\) 的后缀,则 \(endpos(v)\subseteq endpos(u)\);否则,\(endpos(u)\cap endpos(v)=\varnothing\)。
Proof:
对于第一种情况,发现是显然的,考虑 \(v\) 出现的一个位置 \(i\),则 \(u\) 一定也在 \(i\) 出现;对于第二种情况,发现 \(u\) 一定不会在 \(i\) 出现,自然不交。
- 定理2:SAM 上的节点 \(u\) 管辖的子串,满足他们的长度连续,且都是他们中的最长的串的后缀。
Proof:
对于后半部分,由 定理1 可证。
对于前半部分,若存在 \(p\) 和 \(q\) 两个子串同属一个节点 \(u\),不妨设 \(|p|+1<|q|\),则你发现长度夹在 \(|p|,|q|\) 中间的且是 \(q\) 的后缀的串,他的 \(endpos\) 也是和 \(p,q\) 是一样的。
那么我们可以定义 \(u.len\) 表示 \(u\) 节点管辖的最大的子串的长度。
定义 \(u.last\) 指向 \(v\),满足 \(v.len\) 最大且满足 \(v\) 的串都是 \(u\) 的串的后缀。根据这个定义,则 \(minlen(u)=v.len+1\)。
我们把 \((u.last,u)\) 的边组成的树称作Parent Tree。
Parent Tree根据深度可以视作 \(endpos\) 集合的划分树。Parent Tree是构造 SAM 最关键的一部分。
- 定理3:在Parent Tree上从 \(u\) 到根的所有的节点的串的长度恰好组成 \([0,u.len]\) 的区间,且没有相同长度的串。
Proof:
对于 \(s\) 的一个前缀 \(i\),以 \(i\) 为右端点,左端点是一段区间的串共同组成了一个节点 \(v\)。根据定义,\(u.last\) 实际上相当于是这些相邻的区间左边的指向右边的。由此不难看出一定是一段区间。
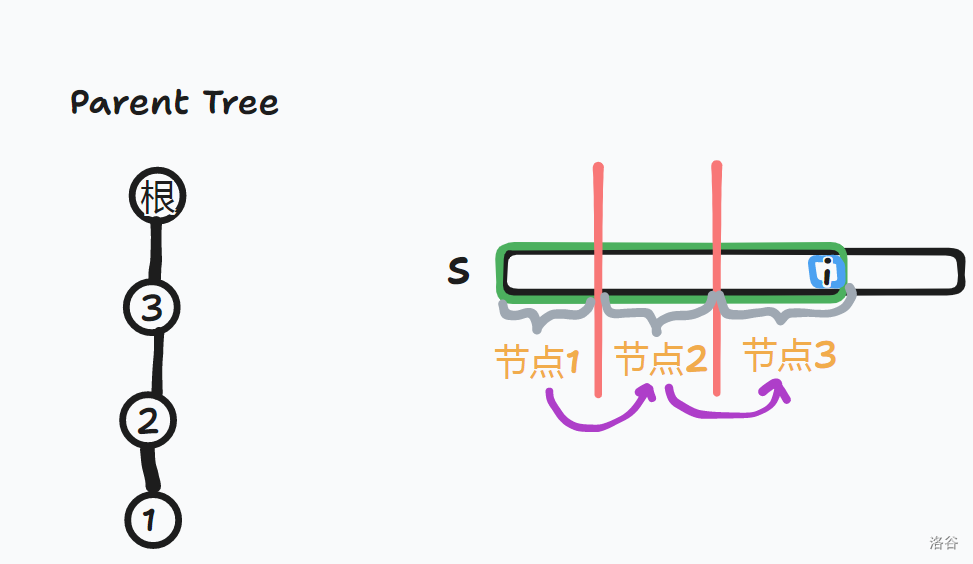
- 定理4:若在 SAM 上节点 \(u\) 有 \(u\rightarrow v\) 的转移边,且边上的字符是 \(c\),则 \(u\) 中的串加上一个字符 \(c\) 是 \(v\) 中的串。
Proof:
根据 SAM 的定义可知。
- 定理5:对于一个 \(v\) 节点,不存在 SAM 上的边 \(u\rightarrow v\) 满足 \(u.len+1>v.len\),且唯一存在状态 \(u\rightarrow v\) 满足 \(u.len+1=v.len\)。
Proof:
由 定理4 可证。
- 定理6:考虑节点 \(v\),对于其所有的 \(u\) 满足有边 \(u\rightarrow v\),则这些 \(u\) 在Parent Tree上构成一条链。
Proof:
还是考虑这张图:
由 定理4 可知,考虑将 \(v\) 中的串都去掉最后一个字符,就是 \(u\rightarrow v\) 的所有 \(u\) 的左端点的区间的并。自然,在Parent Tree上构成一段链。
现在,我们可以构造 SAM 了。如果你还不能熟知上述定理,请反复阅读。SAM 的构造其实很简单。
考虑增量法,先构造出 \(s_{1\sim i-1}\) 的 SAM \(A_{i-1}\),然后修改得到 \(s_{1\sim i}\) 的SAM \(A_i\)。
设管辖 \(s_{1\sim i-1}\) 的节点为 \(now\),且 \(s_i=c\),SAM 的根是 \(T\)。
步骤如下:
- 新建一个节点 \(v\),让 \(v\) 管辖串 \(s_{1\sim i}\),则有 \(v.len=now.len+1\)。
- 令 \(p=now\),考虑所有 SAM 上的到 \(v\) 的转移边。由 定理6 可知,他们在 Parent Tree 上构成一条链。所以我们可以先让 \(p\) 连一条到 \(c\) 的边,然后令 \(p=p.last\)。重复这个过程直到 \(p\) 已经有了 \(c\) 的出边。
- 先考虑特殊情况,如果没有 \(p\) 有 \(c\) 的出边,那么发现 \(c\) 在 \(s_{1\sim i-1}\) 没有出现过。那么 \(v.last=T\)。
- 那么如果存在 \(p\rightarrow q\) 且边权为 \(c\),满足 \(p.len+1=q.len\)
发现 \(q\) 就是 \(v.last\)。至于原因,还是考虑这张图:![]()
第一,\(v.last\) 的串一定满足是 \(v\) 的串后缀,所以一定是跳Parent Tree上的链。但是你 \(v\) 现在还没有 \(last\),所以只能通过跳 \(now\) 所在的 \(last\),然后走 \(c\) 的边走到 \(v\) 所在的Parent Tree上的链
第二,\(p\) 如果有 \(c\) 的出边话,那么一定不会再跳 \(p.last\),那样 \(v.last.len\) 就会更小。
第三,发现 \(p\) 中的串加上一个字符 \(c\) 最大能到达的串的长度为 \(p.len+1\)。所以 \(q\) 恰好满足条件。 - 最后一种情况,如果存在 \(p\rightarrow q\) 且边权为 \(c\),满足 \(p.len+1\not= q.len\)
根据上面的讨论,发现 \(q.len=p.len+1\) 时才是 \(v.last\),那么我们考虑将 \(q\) 拆成两个节点,其中一个的 \(len\) 是 \(p.len+1\) 就好。 - 最后一步,把 \(now\) 设置为 \(v\) 就好了
code
struct SAM
{
	LL len,lst;
	int son[26];
}t[N*2];
void ins(int c) //插入的是 c
{
	LL v=++tot,p=now;
	t[v].len=t[p].len+1;
	now=v;
	while(p!=-1&&!t[p].son[c]) //跳parent tree的链
	{
		t[p].son[c]=v;
		p=t[p].lst;
	}
	if(p==-1) t[v].lst=0; //0是根
	else
	{
		LL q=t[p].son[c];
		if(t[p].len+1==t[q].len) t[v].lst=q;
		else
		{
			LL cp=++tot;
			t[cp].len=t[p].len+1;
			t[cp].lst=t[q].lst;
			for(int i=0;i<26;i++) t[cp].son[i]=t[q].son[i];
			while(p!=-1&&t[p].son[c]==q)
			{
				t[p].son[c]=cp;
				p=t[p].lst;
			}
			t[q].lst=t[v].lst=cp;
		}
	}
}
void init()
{
	for(int i=0;i<=tot;i++)
		for(int j=0;j<26;j++) t[i].son[j]=0;
	t[0].lst=-1; tot=0; now=0;
}
一份压行的 code
int tot,now;
struct SAM
{
	LL len,lst;
	int son[26];
}t[N*2];
void ins(int c)
{
	LL v=++tot,p=now;
	t[v].len=t[p].len+1;
	now=v;
	while(~p&&!t[p].son[c]) t[p].son[c]=v,p=t[p].lst;
	if(p==-1) t[v].lst=0;
	else
	{
		LL q=t[p].son[c];
		if(t[p].len+1==t[q].len) t[v].lst=q;
		else
		{
			LL cp=++tot; t[cp].len=t[p].len+1; t[cp].lst=t[q].lst;
			for(int i=0;i<26;i++) t[cp].son[i]=t[q].son[i];
			while(~p&&t[p].son[c]==q) t[p].son[c]=cp,p=t[p].lst;
			t[q].lst=t[v].lst=cp;
		}
	}
}
void init()
{
	for(int i=0;i<=tot;i++)
		for(int j=0;j<26;j++) t[i].son[j]=0;
	t[0].lst=-1; tot=0; now=0;
}

 浙公网安备 33010602011771号