
Java容器
容器简单来说,就像是我们生活中用来容纳东西的物体,他可以容纳和管理数据,数组也是一种容器,他的优势可以快速的访问元素,效率高,但是他也有他的不足,他有固定的长度,不灵活,不会随着需求的变化而进行扩容操作,不能满足管理和组织的需求,所以引进了一种可以扩容更加灵活的容器,也成为集合(Collection)
容器的结构
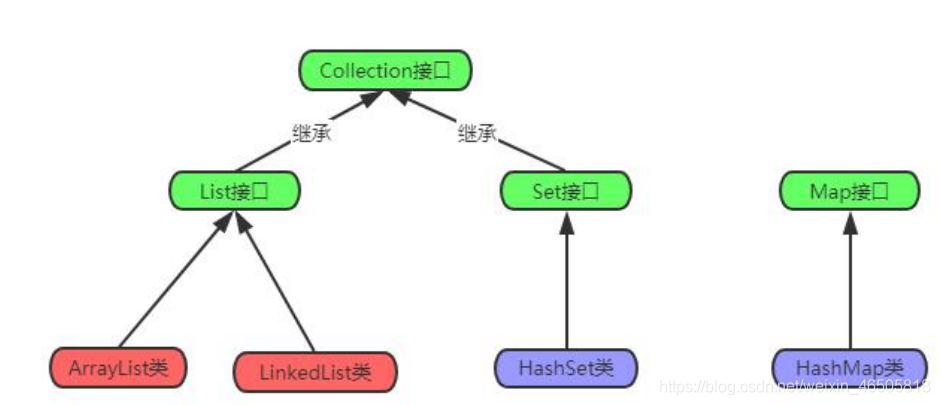
单例集合:将数据一个一个进行存储
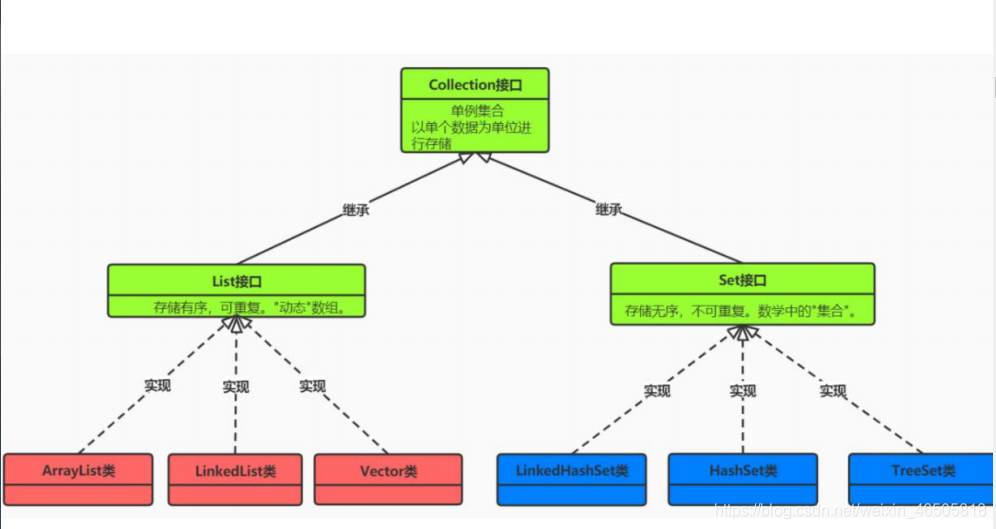
下面就分析单例集合的具体实现
单例集合的整体框架分析
总的单例集合的接口Collection,他有两个子接口,分别是List接口和Set接口
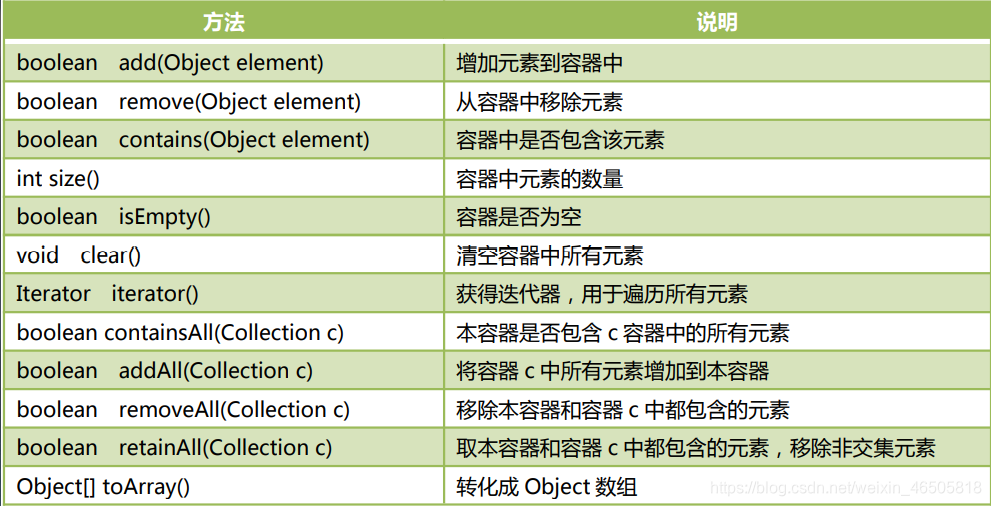
Collection接口中定义的抽象方法
List接口分析
List接口具体一下几个特点:
- 有序:存入集合的顺序和取出集合的顺序一致
- 可重复:允许添加重复的元素
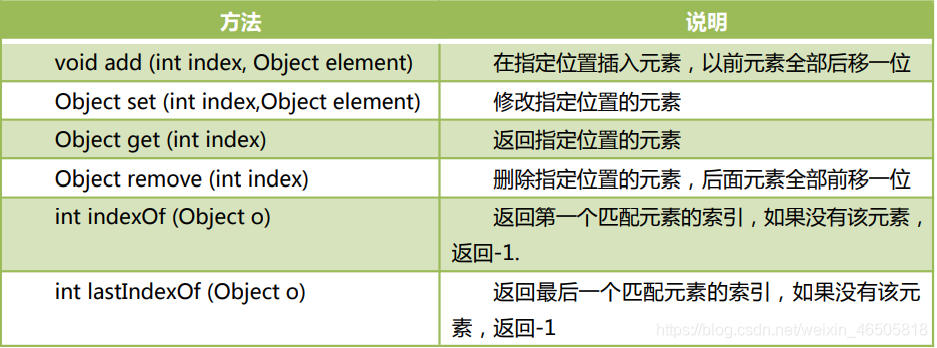
List接口中在Collection基础上定义的抽象方法(List多了一些跟顺序也就是索引有关的方法)
List接口的具体实现类
- ArrayList(ArrayList底层是用数组实现的存储,查询效率高,增删效率低,线程不安全)
ArrayList类的使用
public class ArrayListTest {

    public static void main(String[] args) {
        //实例化一个容器
        //在实例化一个对象的时候,对象引用应该用其接口类型,
        //如果用接口定义对象的引用,之后发生改变对代码的改变较小
        //下面使用的show方法是自定义遍历集合的方法,在最下面
        List<String> list=new ArrayList<>();

        //添加元素
        //这个是Collection接口中定义的add方法,返回一个布尔类型
        boolean flag=list.add("bjsxt");
        boolean flag2=list.add("itbaizhan");
        list.add("java全系列");
        //这个是List接口中的add方法,在给定的索引位置插入指定的元素,索引的数值不可以超过现在集合中元素的个数
        list.add(2,"wujunhong");

        //获取元素  size() 方法,返回集合中元素的个数和get() 方法,获得集合中指定位置的元素的使用
        for(int i=0;i<list.size();i++){
            System.out.println(list.get(i));
        }

        //替换指定位置的元素,返回被替换掉的元素
        String str=list.set(0,"北京尚学堂");
        System.out.println(str);
        show(list,"替换指定位置的元素");

        //删除元素:根据索引删除元素,返回删除的元素,之后的元素都会向前移位
        list.remove(0);
        show(list,"根据索引删除元素");
        //删除指定元素,返回布尔类型的值,如果删除成功就返回true
        list.remove("java全系列");
        show(list,"删除指定元素");

        //清空集合中所有元素
        list.clear();
        show(list,"清空集合中所有元素");

        //判断该集合是否为空,如果为true,则是空集合
        System.out.println(list.isEmpty());
        list.add("武俊宏");
        list.add("苏青旭");
        list.add("朱九思");
        list.add("苏青旭");
        show(list,"添加了四个元素");
        //判断该集合中是否含有指定元素
        System.out.println(list.contains("武俊宏"));

        //查找元素在容器中的位置、、只可以找到第一次出现和最后一次出现的位置,中间的位置找不到
        //如果元素查找不到 则返回-1
        System.out.println(list.indexOf("苏青旭"));//该元素在容器中第一次出现的位置
        System.out.println(list.lastIndexOf("苏青旭"));//该元素在容器中最后一次出现的位置

        //将一个单例集合转化成数组
        System.out.println("----------将单例集合转换成数组-----------");
        Object[]arr=list.toArray();
        for (int i=0;i<arr.length;i++){
            System.out.println(arr[i]);
        }

        System.out.println("----------将单例集合转换成指定泛型的数组---------");
        String[] str2=list.toArray(new String[list.size()]);
        for (int i=0;i<str2.length;i++){
            System.out.println(str2[i]);
        }

        System.out.println("-------集合的并集操作--------- ");
        List<String> a=new ArrayList<>();
        a.add("a");
        a.add("b");
        a.add("c");
        List<String> b=new ArrayList<>();
        b.add("b");
        b.add("c");
        b.add("d");
        //a并b 并好的元素在a中
        boolean flag7=a.addAll(b);
        show(a,"集合并集操作");
        //集合的交集操作
        List<String> a1=new ArrayList<>();
        a1.add("a");
        a1.add("b");
        a1.add("c");
        List<String> b1=new ArrayList<>();
        b1.add("b");
        b1.add("c");
        b1.add("d");
        boolean flag8=a1.retainAll(b);
        show(a1,"集合交集操作");

        a.removeAll(a1);
        show(a,"容器的差值操作");

    }
    public static void show(List list,String operation){
        System.out.println("----------"+operation+"------------");
        //获取元素  size() 方法,返回集合中元素的个数和get() 方法,获得集合中指定位置的元素的使用
        for(int i=0;i<list.size();i++){
            System.out.println(list.get(i));
        }
    }
}
2、LinkedList容器(LinkedList容器底层采用的是双向链表的存储,他查询效率低,增删效率高,线程不安全)
public class LinkedListTest {

    public static void forEach(LinkedList<String> list){
        System.out.println("-----------------------");
        for (String str:list) {
            System.out.println(str);
        }
    }

    public static void main(String[] args) {
       //非List标准,如果使用List标准,对象的引用使用List就可以,方法使用List接口中定义的方法
        LinkedList<String> list=new LinkedList<>();
        list.addFirst("a");
        list.addFirst("b");
        list.addFirst("c");
        //返回列表中第一个元素
        System.out.println(list.getFirst());
        //返回此列表中最后一个元素
        System.out.println(list.getLast());
        forEach(list);
        LinkedList<String> list1=new LinkedList<>();
        list1.addLast("a");
        list1.addLast("b");
        list1.addLast("c");
        forEach(list1);
        //移除此列表中第一个元素
        System.out.println(list1.removeFirst());
        //移除此列表中最后一个元素
        System.out.println(list1.removeLast());
        //等效于removeFirst()
        System.out.println(list1.pop());
        //等效于addFirst
        list1.push("f");
        forEach(list1);
        //判断是否包含元素,返回一个Boolean类型的值
        System.out.println( list1.isEmpty());
    }
}
3、Vector容器
和ArrayList的区别和联系
- Vector底层也是数组实现的,和ArrayList的所有操作都是一样的,但是Vector是单线程,串行的,加了同步检查,所以线程安全,效率低,而ArrayList是并行的,所以线程不安全
- 操作和ArrayList都一样
- ArrayList底层采用的是延迟初始化,在扩容的时候是1.5倍扩容
Vector底层采用的是立即初始化,在扩容的是时候是2倍扩容
4、Stack容器
Stack栈容器,是Vector的一个子类,他实现了标准的先进后出原则
Stack容器的使用以及案例
public class StackTest {

    public static void main(String[] args) {
        //实例化一个栈对象,对象的引用只能用Stack 因为list接口中没有操作栈的方法
        Stack<String> s=new Stack<>();
        //在栈中添加元素
        s.push("a");
        s.push("b");
        s.push("c");
        //查看栈顶元素
        System.out.println(s.peek());
        //判断栈是否为空
        System.out.println(s.empty());
        //返回元素在栈当中的位置
        System.out.println(s.search("b"));
        //获取栈容器中的元素,从栈顶移除元素
        String str1=s.pop();
        String str2=s.pop();
        String str3=s.pop();
        System.out.println(str1);
        System.out.println(str2);
        System.out.println(str3);
        //再次判断栈是否为空
        System.out.println(s.empty());
        System.out.println("---------------------");
        symmetry();

    }
    public static void symmetry(){
        //Stack使用案例,判断元素的对称性
        String str="...[...(...{......}...).....].....(....).....[...]..(.";
        //创建一个Stack实例
        Stack<String> stack=new Stack<>();
        //假设修正法
        boolean flag=true;
        //拆分字符串,获取字符
        for (int i=0;i<str.length();i++){
            char c=str.charAt(i);
            if (c=='{'){
                stack.push("}");
            }
            if (c=='['){
                stack.push("]");
            }
            if (c=='('){
                stack.push(")");
            }
            if (c=='}'||c==']'||c==')'){
                if (stack.empty()){
                    flag=false;
                    break;
                }
                String x=stack.pop();
                if(x.charAt(0)!=c){
                    flag=false;
                    break;
                }
            }
        }
        if (!stack.empty()){
            flag=false;
        }
        System.out.println(flag);
    }
}
Set接口分析
特点:无序、不可重复。无序是指Set中的元素没有索引,我们只可以遍历查找,不可重复是指,新元素如果和Set中某个元素通过equals()方法对比为true,只能保留一个。
Set接口具体实现类
- HashSet
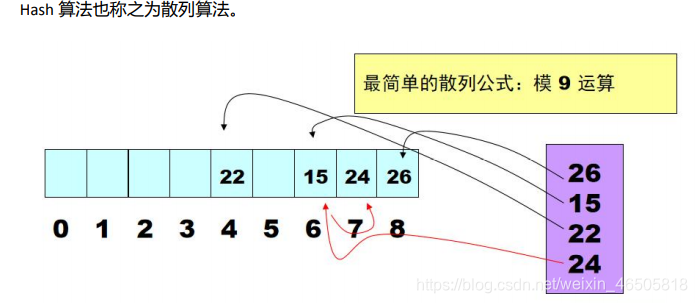
HashSet是一个没有重复元素的集合,不保证元素的顺序,HashSet允许有null元素,HashSet 是采用哈希算法实现的,底层是用HashMap实现的,下来介绍一下Hash原理:![哈希算法也是散列算法]()
存储的数据通过进行模9运算,然后存储到对应的位置,如果这个位置上有元素了,会调用对应的equals方法,判断两个元素是否相同,如果相同则不会添加,如果不相同,则会使用单向链表保存该元素。
HashSet类的使用
public class HashSetTest {

    public static void main(String[] args) {
        //实例化Hashset对象
        HashSet<String> hashSet=new HashSet<>();
        //添加元素,不能保证存放元素的顺序,以及不可以有元素重复
        //线程不安全,可以有null
        //无序:对元素的哈希值进行运算,来决定元素到底存放在哪里
        hashSet.add("a1");
        hashSet.add("c2");
        hashSet.add("d3");
        hashSet.add("a");
        //删除元素
        hashSet.remove("a1");
        System.out.println(hashSet.size());

        //从Hashset中获取元素,在set容器中没有索引,没有对应的get方法
        for(String str:hashSet){
            System.out.println(str);
        }

        System.out.println("***********HashSet存储自定义对象,User类在下面*************");
        /**
         * 如果想要识别存储对象属性的比较,是他们有互异性
         * 需要在JavaBean中重写HashCode以及equals方法
         */
        Set<Users> u=new HashSet<>();
        Users u1=new Users("武俊宏",18);
        Users u2=new Users("武俊宏",18);
        System.out.println(u1.hashCode());
        System.out.println(u2.hashCode());
        u.add(u1);
        u.add(u2);
        for (Users users:u){
            System.out.println(users);
        }

    }
}
public class Users implements Comparable<Users>{
    private String userName;
    private int userAge;

    @Override
    public boolean equals(Object o) {
        System.out.println("程序执行到这里了");
        if (this == o) {
            return true;
        }
        if (o == null || getClass() != o.getClass()) {
            return false;
        }
        Users users = (Users) o;
        return userAge == users.userAge && Objects.equals(userName, users.userName);
    }

    @Override
    public int hashCode() {
        return Objects.hash(userName, userAge);
    }

    public Users() {
    }

    public Users(String userName, int userAge) {
        this.userName = userName;
        this.userAge = userAge;
    }

    public String getUserName() {
        return userName;
    }

    public void setUserName(String userName) {
        this.userName = userName;
    }

    public int getUserAge() {
        return userAge;
    }

    public void setUserAge(int userAge) {
        this.userAge = userAge;
    }

    @Override
    public String toString() {
        return "Users{" +
                "userName='" + userName + '\'' +
                ", userAge=" + userAge +
                '}';
    }
}
TreeSet(TreeSet是一个可以对元素进行排序的容器,底层实际是用TreeMap实现的,通过Key来存储Set元素,因为他要排序,所以我们要给定排序规则)
排序规则1:通过元素自身实现比较规则,需要实现Comparable接口中的compareTo方法,该方法用来定义比较规则,TreeSet通过调用该方法来完成对元素的排序处理
public class Users implements Comparable<Users>{
    private String userName;
    private int userAge;

    @Override
    public boolean equals(Object o) {
        System.out.println("程序执行到这里了");
        if (this == o) {
            return true;
        }
        if (o == null || getClass() != o.getClass()) {
            return false;
        }
        Users users = (Users) o;
        return userAge == users.userAge && Objects.equals(userName, users.userName);
    }

    @Override
    public int hashCode() {
        return Objects.hash(userName, userAge);
    }

    public Users() {
    }

    public Users(String userName, int userAge) {
        this.userName = userName;
        this.userAge = userAge;
    }

    public String getUserName() {
        return userName;
    }

    public void setUserName(String userName) {
        this.userName = userName;
    }

    public int getUserAge() {
        return userAge;
    }

    public void setUserAge(int userAge) {
        this.userAge = userAge;
    }

    @Override
    public String toString() {
        return "Users{" +
                "userName='" + userName + '\'' +
                ", userAge=" + userAge +
                '}';
    }
    //定义比较规则
    @Override
    public int compareTo(Users o) {
        if (this.userAge<o.getUserAge()){
            return 1;
        }
        if (this.userAge==o.getUserAge()){
            return this.userName.compareTo(o.userName);
        }
        return -1;
    }
}
public class TreeSetTest {

    public static void main(String[] args) {
        //实例化一个TreeSet对象
        Set<String> treeSet=new TreeSet<>();
        treeSet.add("c");
        treeSet.add("f");
        treeSet.add("d");
        treeSet.add("d");
        treeSet.add("a");
        for (String str: treeSet) {
            System.out.println(str);
        }
        System.out.println("******************");
        Set<Users> set=new TreeSet<>();
        Users u1=new Users("wujunhong",15);

        Users u5=new Users("oi",2);
        Users u6=new Users("pi",2);
        set.add(u1);
        set.add(u5);
        set.add(u6);
        for (Users users:set){
            System.out.println(users);
        }
    }
}
排序规则2:通过比较器实现比较排序规则,通过比较器定义比较规则时,我们需要单独创建一个比较器,比较器需要实现Comparator接口中的compare方法来定义比较规则,在实例化TreeSet时将比较器对象交给TreeSet来完成元素的排序处理,元素此时就不需要实现比较规则了
//定义一个Student类,方便后面的测试
public class Student {
    private String name;
    private int age;

    public Student() {
    }

    public Student(String name, int age) {
        this.name = name;
        this.age = age;
    }

    public String getName() {
        return name;
    }

    public void setName(String name) {
        this.name = name;
    }

    public int getAge() {
        return age;
    }

    public void setAge(int age) {
        this.age = age;
    }

    @Override
    public boolean equals(Object o) {
        if (this == o) {
            return true;
        }
        if (o == null || getClass() != o.getClass()) {
            return false;
        }
        Student student = (Student) o;
        return age == student.age && Objects.equals(name, student.name);
    }

    @Override
    public int hashCode() {
        return Objects.hash(name, age);
    }

    @Override
    public String toString() {
        return "Student{" +
                "name='" + name + '\'' +
                ", age=" + age +
                '}';
    }
}
//定义比较器
public class StudentComparator implements Comparator<Student> {

    @Override
    public int compare(Student o1, Student o2) {
        if (o1.getAge()>o2.getAge()){
            return 1;
        }
        if (o1.getAge()==o2.getAge()){
            return o1.getName().compareTo(o2.getName());
        }
        return -1;
    }
}
public class TreeSetTest {
//必须把比较器对象交给创建好的对象
        Set<Student> s=new TreeSet<>(new StudentComparator());
        Student student=new Student("wu",123);
        Student student1=new Student("jun",15);
        Student student2=new Student("hong",14);
        Student student3=new Student("qong",14);
        s.add(student);
        s.add(student1);
        s.add(student2);
        s.add(student3);

        for (Student stu:s){
            System.out.println(stu);
        }
    }
}
双例集合:基于Key和Value的结构存储数据
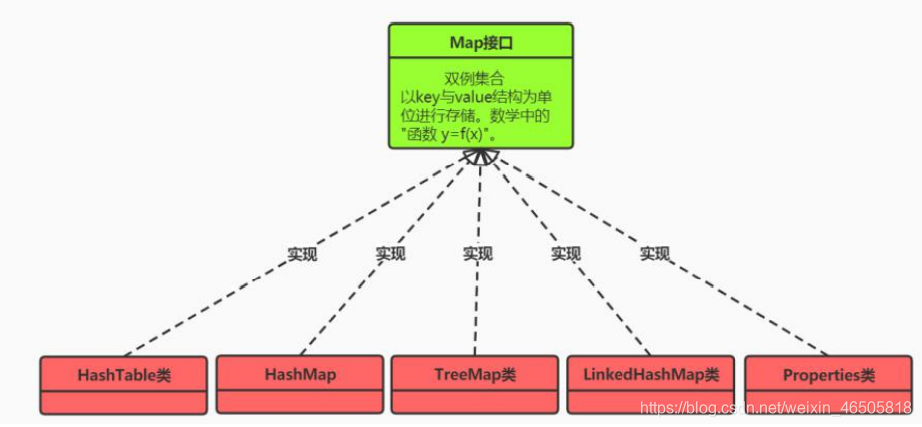
下面就分析双例集合的具体实现
双例集合的整体框架分析(底层实现比较难描述,这里不具体展开描述)
总的双例集合的接口Map,整个框架中只有他一个接口,其他的都是接口的具体实现类
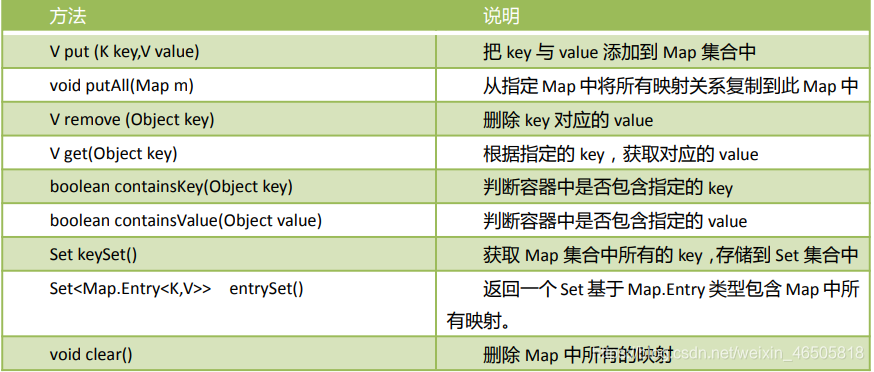
Map接口中定义的抽象方法
HashMap容器类
HashMap是Map接口的实现类,他采用哈希算法实现。由于底层采用哈希表存储数据,所以要求键不能重复,如果发生重复,新的值会替换旧的值。HashMap在查找、删除、修改方面都有非常高的效率,代码和之前的代码相似,但是具体如何遍历元素的三个方式是非常有意思的
public class HashMapTest {

    public static void main(String[] args) {
        //实例化一个hashMap容器
        Map<String,String> map=new HashMap<>();
        //添加元素,put方法,只有在容器中有重复的key时,他才会返回原来没有被覆盖的值
        map.put("a","A");
        String value=map.put("a","B");
        System.out.println(value);
        //获取元素,
        //方法一:元素多,需要调用很多次get方法;而且需要提前知道key的值
        System.out.println(map.get("a"));
        System.out.println("---------------");
        map.put("c","C");
        map.put("d","D");
        map.put("e","E");
        map.put("f","F");
        //方法二:获取HashMap容器中所有元素,可以使用keySet方法和get方法进行实现
        Set<String>keys=map.keySet();
        for (String str:keys){
            String values=map.get(str);
            System.out.println(str+"---"+values);
        }
        //方法三:通过entrySet方法获取Map.Entry类型(k-v映射出来的键值对)获取元素
        System.out.println("**************");
        Set<Map.Entry<String,String>> entrySet=map.entrySet();
        for (Map.Entry<String,String> entry:entrySet){
            String k=entry.getKey();
            String v=entry.getValue();
            System.out.println(k+"-----"+v);
        }
        System.out.println("-------HashMap的并集操作--------");
        Map<String,String> map1=new HashMap<>();
        map1.put("l","L");
        map1.put("c","ccc");    // 这个会覆盖掉
        map1.putAll(map);
        Set<String> sets=map1.keySet();
        for (String str:sets){
            String values=map1.get(str);
            System.out.println(str+"---"+values);
        }
        System.out.println("-----HashMap删除元素");
        String v=map.remove("e");
        System.out.println("删除的元素是:"+v);
        Set<String> dele=map.keySet();
        for (String str:dele){
            String values=map.get(str);
            System.out.println(str+"-----"+values);
        }
        System.out.println("------判断k和v是否存在");
        boolean flag=map.containsKey("aaa");
        boolean flag1=map.containsKey("a");
        boolean flag2=map.containsValue("B");
        boolean flag3=map.containsValue("BB");
    }
}
Tree Map容器类
TreeMap和HashMap同样实现了Map接口,HashMap效率高于Tree Map,TreeMap是可以对键进行排序的一种容器,在需要排序的时候可以使用Tree Map,他的底层是基于红黑树实现的。同样需要给定排序规则
- 元素自身实现比较规则
public class TreeMapTest {

    public static void main(String[] args) {
        System.out.println("*********通过自身比较规则实现排序***********");
        System.out.println("------存放普通字符类型对象--------");
        //实例化一个terrMap对象
        Map<String,String> treeMap=new TreeMap<>();
        //添加元素
        treeMap.put("a","A");
        treeMap.put("d","D");
        treeMap.put("f","F");
        treeMap.put("b","B");
        //对元素进行遍历
        Set<String> strings=treeMap.keySet();
        for (String str:strings){
            String k=str;
            String v=treeMap.get(k);
            System.out.println(k+"------"+v);
        }
        System.out.println("------存放users对象--------");
        Map<Users,String> map=new TreeMap<>();
        Users u1=new Users("武俊宏",19);
        Users u2=new Users("主机四",12);
        Users u3=new Users("苏青旭",14);
        Users u4=new Users("贾凯奇",33);
        map.put(u1,"武俊宏");
        map.put(u2,"主机四");
        map.put(u3,"苏青旭");
        map.put(u4,"贾凯奇");
        Set<Users>set=map.keySet();
        for (Users users:set){
            System.out.println(users+"---"+map.get(users));
        }

    }
}
通过比较器实现比较规则
public class TreeMapTest {

    public static void main(String[] args) {
//这里必须把比较器给了TreeMap,和TreeSet一样,因为Student没有实现Comparator接口
        Map<Student,String> stringMap=new TreeMap<>(new StudentComparator());
        Student student1=new Student("武俊宏",18);
        Student student2=new Student("主机四",14);
        Student student3=new Student("苏青旭",18);
        Student student4=new Student("贾凯奇",55);
        stringMap.put(student1,"武俊宏");
        stringMap.put(student2,"主机四");
        stringMap.put(student3,"苏青旭");
        stringMap.put(student4,"贾凯奇");
        Set<Student>students=stringMap.keySet();
        for (Student student:students){
            System.out.println(student+"----------"+stringMap.get(student));
        }
    }
}
到这里差不多就可以结束了,还有迭代器和Collections工具类的使用在这里就不一一描述了,容器这里的底层还是很有意思的,多看几遍可以对容器有更深的认识!
本文来自博客园,作者:(HelloWorld!),转载请注明原文链接:https://www.cnblogs.com/Simon-s/articles/15652078.html --有志者,事竟成

 浙公网安备 33010602011771号