
Apache Doris 高性能 Open Lake Variant 读写技术解析(含对比数据)
导读:Apache Doris 5.0 多模湖仓预告(5)|技术解读篇:面对日志、事件、AI 调用等不断变化的半结构化数据,如何既保留灵活结构,又实现高效查询?从 Doris 4.2 开始,Iceberg、Paimon 中的 Variant 数据可以直接高效读写,并通过按需读取、拆列优化和向量化计算提升查询效率。本轮测试中,相比 Spark,Doris 冷跑综合加速 15.10×、热跑 19.14×;拆列场景热跑综合加速达 58.64×,部分 Paimon 测试超过 106×。本文将介绍这些性能提升背后的关键技术。
作者:李文强,SelectDB 多模湖仓负责人
一、Variant:让变化的数据保留类型
一张事件表,今天多了设备属性,明天增加模型调用信息;同一个 amount,有的记录是数字,有的却是字符串。这类数据既要保留不断变化的结构,又要接受 SQL 过滤、聚合和关联。Variant 正是为这样的半结构化数据提供类型化表达。
从 Doris 4.2 开始,Iceberg 与 Paimon 的 Variant 高效读写成为 Doris 湖仓能力的一部分。用户可以直接查询湖表中的半结构化数据,按嵌套字段进行过滤、聚合和关联,并将 Variant 值写回湖表。下文将介绍这些能力背后的类型表示、读取优化与计算机制。
理解 Variant,需要沿着三个层次往下看:它能表达什么值,文件怎样保存这些值,Doris 怎样把这些值交给计算算子。
Variant 适合保存日志上下文、业务事件扩展属性、设备参数,以及 AI 应用中的调用信息、评测属性等半结构化内容。不同记录可以具有不同字段,同一路径也可以保存不同类型的值。
先把表结构与值的结构分开看。假设有一张 events 事件表,包含 id BIGINT 和 payload VARIANT 两列:id 保存事件编号,payload 保存事件的扩展内容。payload 只是本文示例中用户自定义的列名,VARIANT 才是这一列的数据类型;这个列名也可以换成 attributes 或其他名称。
一行的 payload 对应一个 Variant 值。这个值可以是数字、字符串等标量,也可以是由“字段名 → 子值”组成的对象,或者由多个元素组成的数组;对象和数组还可以继续嵌套。为便于阅读,下方示例用 JSON 写法展示逻辑内容,每行代码对应一条记录中的 payload 值;实际存储使用二进制编码,第二章会进一步展开。
例如,下列两个逻辑值可以出现在同一列中:
{"region":"west","amount":120,"device":{"os":"linux"}}
{"region":"east","amount":"unknown","tags":["new","app"]}
第一行的根值是一个对象:region 对应字符串 "west",amount 对应数字 120,device 对应一个嵌套对象,其中的 os 对应字符串 "linux"。第二行则没有 device,增加了数组字段 tags,并把 amount 保存为字符串。这些差异都发生在同一列的不同值内部。
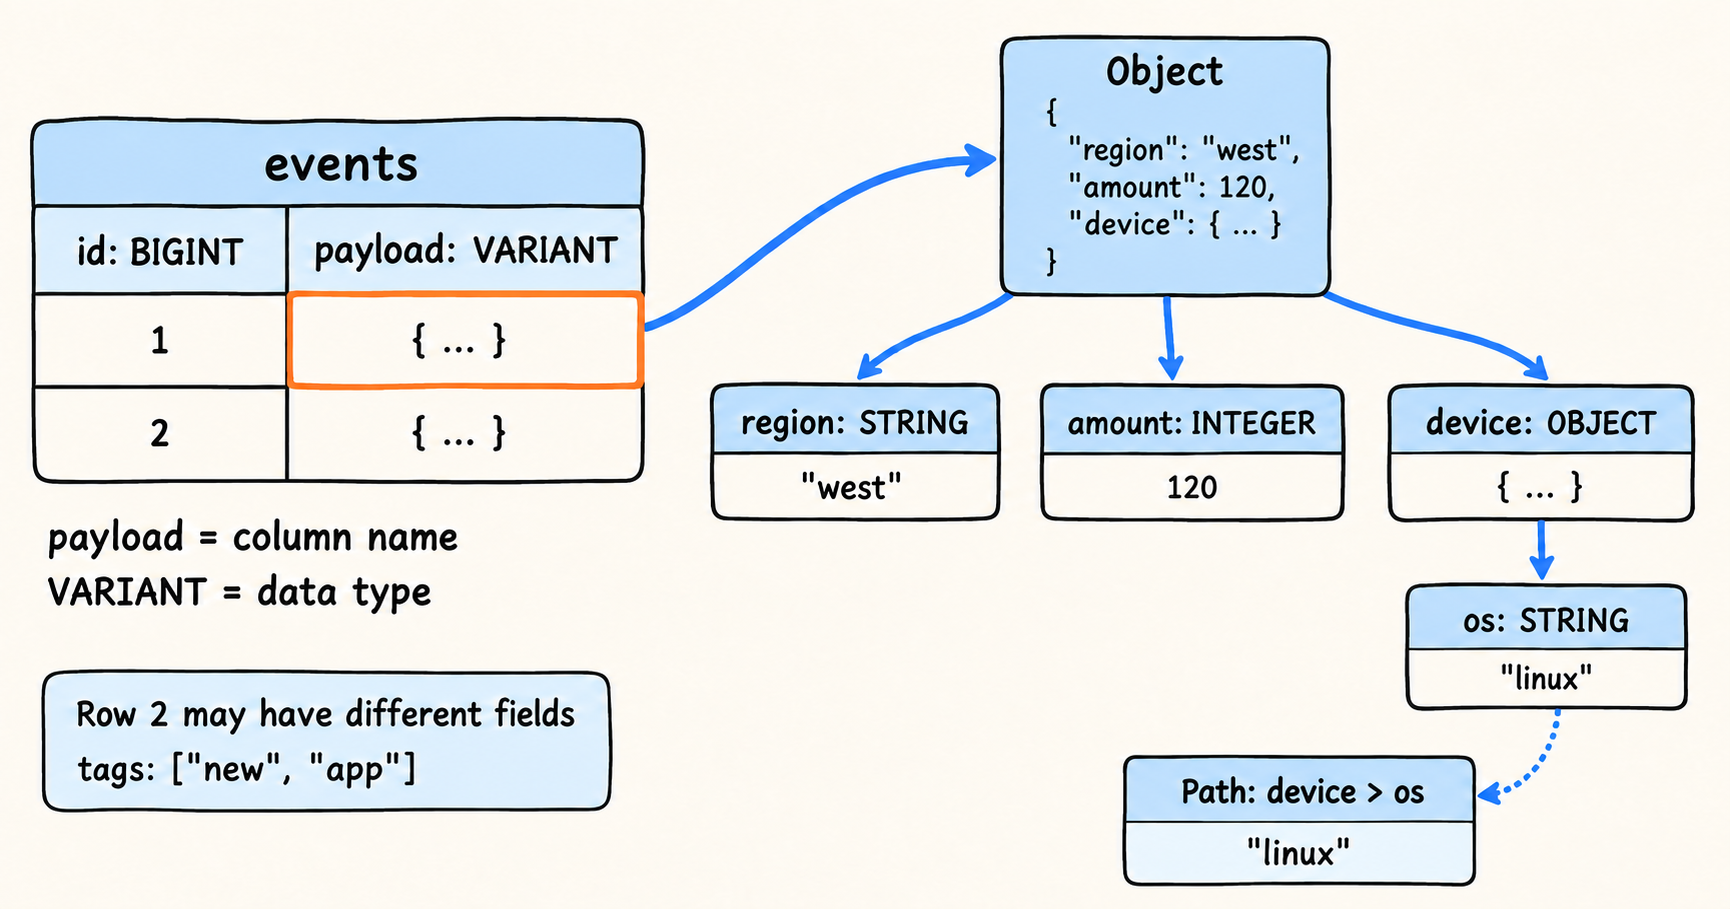
图 1|从 events 表中的 payload 列,展开到一个 Variant 值的嵌套字段。图示表达逻辑结构;第二章再介绍实际的二进制编码。
后文的 payload['region'] 表示从这一列的值中取出 region 字段,payload['device']['os'] 则沿 device → os 逐层取值。例如,对第一行执行 CAST(payload['device']['os'] AS STRING),结果是字符串 linux。列名、字段路径和目标类型分别回答“从哪一列取、取哪个值、按什么类型计算”。
表结构不必为每次新增属性执行一次变更。但灵活性并不意味着类型消失:数字 120 和字符串 "120" 仍然是不同的值,查询时需要明确预期的类型和异常值处理方式。
实践中,可以把业务主键、事件时间、分区字段等稳定属性放在普通列中,将持续变化的扩展属性放入 Variant。这样,稳定字段仍便于分区和关联,扩展字段则保留演进空间。
二、Variant 的存储与编码
2.1 metadata 与 value:把结构和类型保存在二进制里
未拆列的 Variant,通常由 metadata 和 value 两部分共同表达:
| 组成 | 保存什么 | 为什么有用 |
|---|---|---|
| metadata | 编码头、字段名字典及相关偏移 | 对象可以引用字段名编号,读取时可复用字典解析结果 |
| value | 类型标记、标量内容、对象或数组结构及偏移 | 保留类型,并定位嵌套值的二进制片段 |
这里的 metadata 是值编码的一部分,与 Catalog 中的表元数据不是同一个概念。对象通过字段名编号、偏移和子值组织内容;数组通过元素偏移定位内容;标量则按自身类型编码。Doris 可以在二进制表示上取字段,无须先还原为 JSON 字符串。
不过,二进制里能够快速定位一个字段,不等于对象存储只需读取这个字段的字节。 如果多个字段仍位于同一个二进制载荷中,实际 I/O 还受 Parquet 页与列块布局影响。要进一步利用列式读取,需要看拆列。
2.2 Shredding:把选定路径变成有类型的物理列
Shredding 可以理解为按路径拆列:例如把 region 拆成字符串列,把 amount 拆成整数列。它们随后可以使用 Parquet 的列式编码、压缩和统计信息。
未拆出的字段,以及与选定物理类型不匹配的值,可以保留在 residual,即残余二进制值中。例如某条记录的 amount 是字符串 "unknown",不能仅因为其他记录的该字段拆成整数列,就丢弃这个值。
沿用前面的 amount 字段,假设文件 writer 选择将它按整数拆列。下面只展示这个对象字段的两类物理槽位,不是完整 Parquet schema:
| 对象中的 amount | 类型子列 typed_value | 二进制 fallback:value |
|---|---|---|
| 数字 120 | 120 | 无 |
| 字符串 "unknown" | 无 | 字符串的 Variant 编码 |
| 显式 null | 无 | Variant null 的编码 |
| 字段不存在 | 无 | 无 |
表中的“无”表示该物理槽位未存值;Variant null 则由实际存在的二进制编码表达。这个例子假设 payload 本身是对象,讨论的是对象内部的字段。拆列不等于强制类型转换,类型子列为空也不等于逻辑值就是 null。reader 必须结合 fallback 和字段存在性恢复语义。
residual 是残余二进制内容的统称,fallback 强调某条路径不能由类型子列承载时的取值来源。它们可以出现在不同嵌套层级,并非都汇总到根级的一个大对象中。写入时由 writer 按拆列 schema 组织这些物理列,表中对用户暴露的逻辑列仍然是 payload VARIANT。
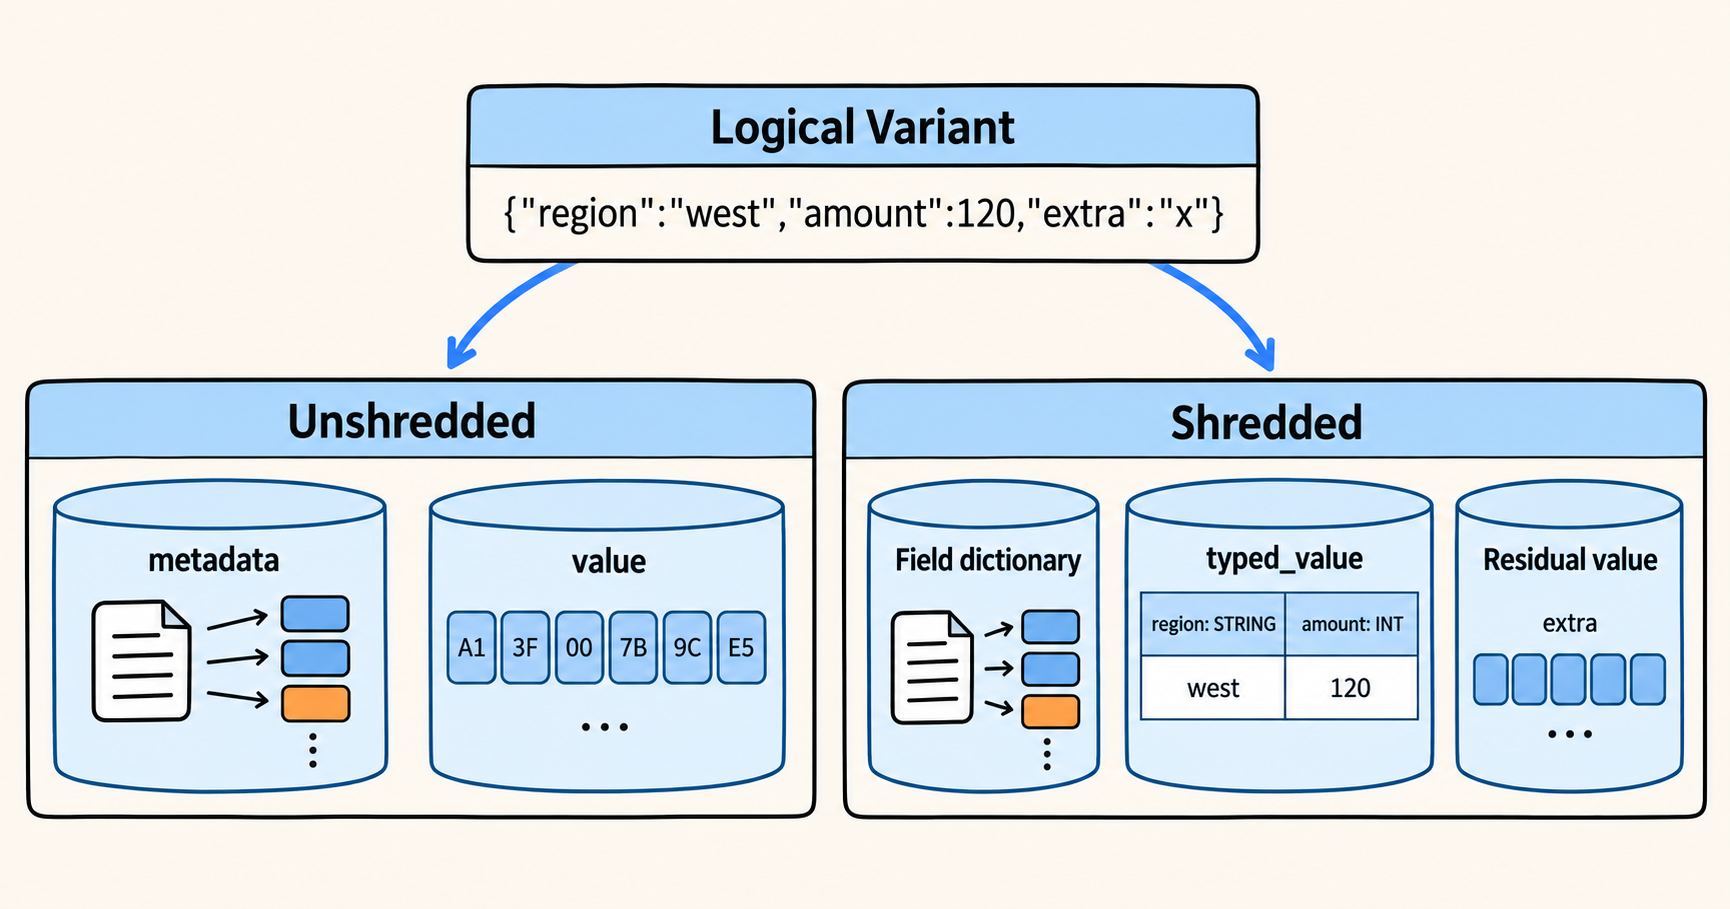
图 2|Variant 的两种物理布局:未拆列时保留二进制文档;拆列后,类型子列与残余值共同表达逻辑内容。图中字节仅作编码示意。
同一张表的不同文件,可以拆出不同路径,也可以同时存在拆列与未拆列文件。因此,reader 必须识别每个文件的实际布局,再决定读取哪些列、是否需要残余值,以及何时重建对象。
2.3 与 JSON 的区别:重点在类型、布局与执行方式
Doris 的 JSON 类型采用二进制 JSONB 表示。下面比较的是这种二进制 JSON 表示与湖上 Variant,而不是把 JSON 查询都视为从文本重新解析。
| 维度 | Doris JSONB | 本文讨论的湖上 Variant |
|---|---|---|
| 主要表示 | 二进制 JSON 文档 | 带类型的二进制值,可结合拆列布局 |
| 类型表达 | 面向 JSON 语义的二进制表示 | 可表达 decimal、日期时间、二进制等更多类型 |
| 字段访问 | 在二进制文档上访问路径 | 二进制路径定位,或直接访问类型子列 |
| 子列优化 | 使用 JSONB 不会自然产生 Parquet Variant 子列 | 已拆出的路径可以参与列裁剪与统计裁剪 |
| 互操作重点 | JSONB 的理解或转换 | Variant 编码、表格式与各引擎的共同支持 |
因此,Variant 的价值不只是“把 JSON 换一种编码”。它把类型信息、可选的列式布局和执行引擎的计算能力连接起来。原样交换、低频取值可以使用 JSON;频繁进行路径过滤、聚合和湖上跨引擎读写时,Variant 提供了更多优化空间。
日期时间、二进制等值转成 JSON 文本后,还可能丢失原来的类型身份。文本中转适合受控的 JSON 数据转换,不应默认视为所有 Variant 值的无损交换方式。
三、一条 Variant 查询在 Doris 中怎样执行
3.1 FE 规划:识别类型、路径与扫描任务
用户提交 SQL 后,FE 负责解析、分析与生成执行计划。Catalog 适配层将 Iceberg、Paimon 中的 Variant 映射为 Doris 能识别的逻辑类型;优化器分析查询需要的列、可识别的嵌套路径和过滤条件,形成扫描任务,再将执行计划分发给 BE。
这里有两类相关但不同的优化:普通列裁剪决定是否需要 payload;嵌套路径裁剪进一步表达只需要 payload['region']、payload['amount']。FE 从表达式中收集可识别的常量路径,并区分过滤与投影需求。这些需求传到 reader 后,才能结合实际文件布局转化为物理列读取。路径请求本身并不保证每个文件都能只读叶子列。
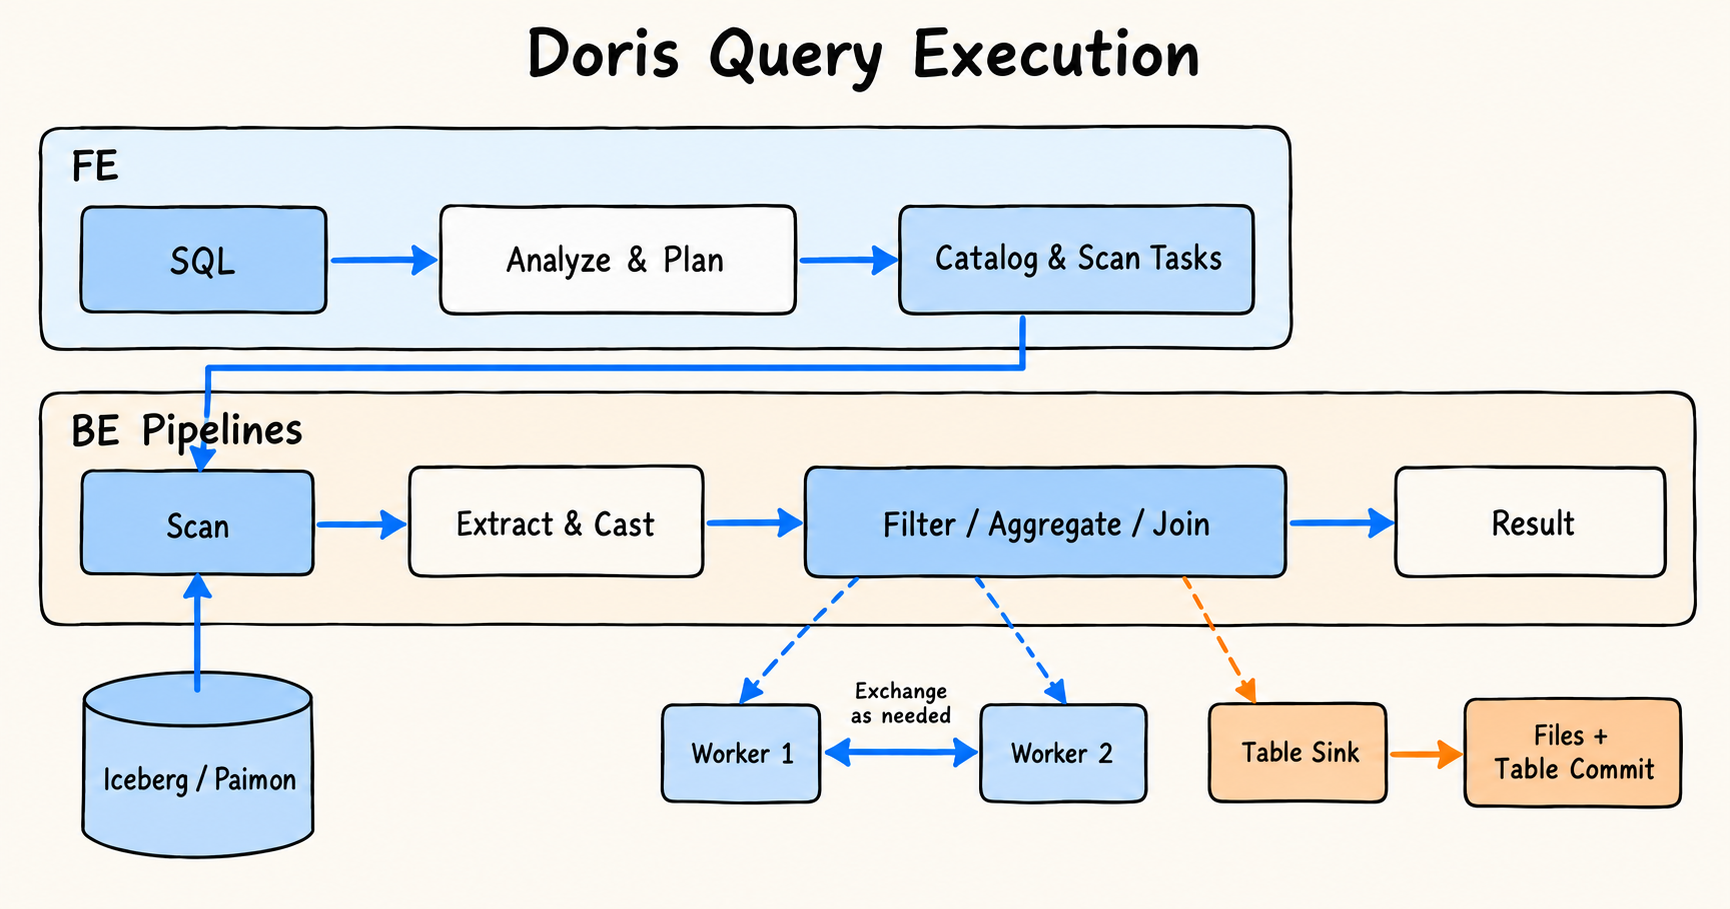
图 3|Doris 的总体执行流程。FE 规划扫描与执行任务,BE 以批次执行算子;查询返回结果,写入则进入目标表 sink 和提交链路。图中的算子为示意,具体次序与分布由执行计划决定。
3.2 BE 执行:扫描、表达式与分布式计算
BE 从湖上扫描数据,组织为包含多列数据的 Block 批次。路径提取、类型转换、过滤、聚合和关联等工作在执行计划安排的算子中完成;需要跨节点交换数据时,由 Exchange 衔接不同执行阶段。过滤可能下推,聚合也可能分布在 Exchange 两侧,不能把概念流程理解为每条查询固定的串行次序。
对 Variant 而言,关键不是让所有算子都理解完整嵌套对象,而是让需要的路径尽早变成可计算的列,同时尽量延后无用的整对象重建。若最终只需要 SUM(amount),大量未参与计算的扩展字段就没有必要反复转换成对象或文本。
四、高效读取:少读无关列,少构造中间对象
4.1 按文件和 Row Group 决定投影范围
以按地区统计金额为例,查询主要需要 region 和 amount 两条路径。Parquet scanner 会根据当前 Row Group 的物理布局与 residual 情况决定:
-
可以证明叶子列足够:读取所需类型子列。
-
叶子列还不足以表达结果:保留必要的残余值并参与恢复。
-
无法证明局部投影完整:回退到完整 Variant 投影。
这使优化能够适应不同文件的布局,同时保证字段不因裁剪而丢失。动态路径、整对象输出和混合类型都会影响实际读取范围。
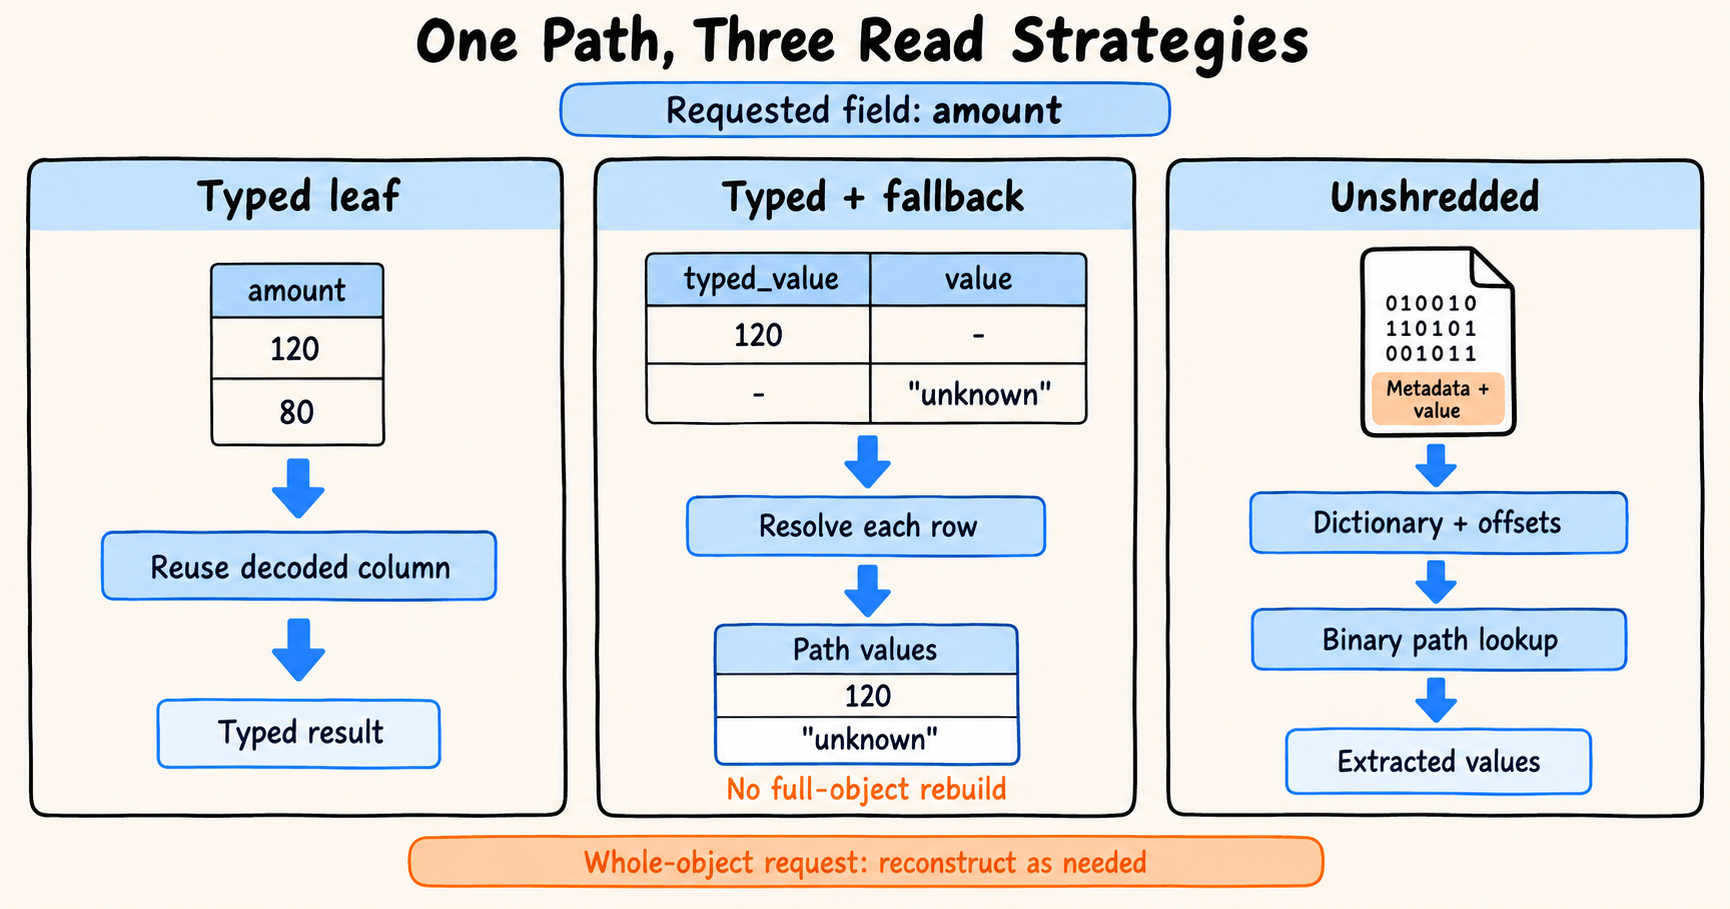
图 4|同一条 amount 路径的三种读取方式:直接复用类型叶子、按行组合类型值与 fallback、沿未拆列二进制定位。图中展示可走快速路径的情况;整对象或复杂结构按实际需求恢复。
4.2 拆列路径:复用叶子、补齐残余值,再安全裁剪
情况一:目标路径完全由兼容的类型叶子提供。reader 会沿文件中的物理结构找到目标路径,检查相关层级的有效性与残余值需求。若该路径无需 residual 补充,并且物理类型适合直接使用,就保留已经解码的叶子列,交给后续 CAST 和计算,省去“重新编码为完整对象,再提取同一个字段”的往返。部分需要保留特殊物理语义的类型会转换为精确的 Variant 值,同样可以避免完整对象重建。
情况二:同一路径的不同记录分别由类型列和 fallback 提供值。例如,第一条记录的 amount=120 位于整数子列,第二条记录的 amount="unknown" 位于该字段的二进制 fallback。Doris 会逐行沿路径检查类型值是否存在:类型路径完整时取叶子;在某层需要残余值时,则进入该层的二进制内容,继续定位剩余路径。最终组合的是 amount 这一条路径的结果,保留各行原来的值与类型。
如果目标字段根本没有被拆出,Doris 也可以在对应对象层级的 residual 中查找。字段名到字典编号的解析可以按不同 metadata 复用,只有确实需要解释残余编码时才构建相关索引。因此,“存在 residual”并不意味着“必须重建整个 Variant”。这条优化主要针对能够直接解析的对象键路径;数组或复杂子树不满足快速路径条件时,仍需按实际需求恢复相应值。
这也解释了列裁剪和统计裁剪的区别:前者减少不需要的物理列,后者跳过不匹配的数据范围。当 fallback 中仍有需要参与判断的值时,只看类型子列的统计信息并不足以证明可以跳过。
例如过滤 CAST(payload['amount'] AS BIGINT) > 1000。如果对应类型列在某个 Row Group 的最大值为 900,且转换与残余值条件允许,该 Row Group 就可能被跳过。实现会检查对象键路径、常量比较、类型与排序语义、转换安全性,以及该路径末端是否还存在 fallback 值。Page Index 裁剪也需要相应校验。
4.3 未拆列路径:直接定位与复用解析结果
情况三:文件没有拆出类型子列,目标值保存在 metadata/value 编码中。Doris 会解析 metadata 的字段名字典,建立可复用的索引;访问对象路径时,先把字段名映射为编号,再结合对象中的字段编号与偏移定位子值,沿嵌套层级继续查找,无须先生成 JSON 文本。
同一份字典可以被多行共享使用,路径解析也可以复用已经定位的前缀。例如访问 device.os 与 device.version 时,可以减少重复定位 device 的工作。对于已定位的标量,reader 可以组织为适合后续计算的列;对于尚需继续访问的子树,则可以保留路径状态,延后构造完整内容。这些优化减少了重复字典解析、字段查找和中间值构造。
这些优化主要减少字段访问的 CPU 和中间对象开销,与“读取独立 Parquet 子列减少 I/O”属于不同机制。即使文件没有拆列,也无须先把每一行变成 JSON 文本。
五、高效计算:让提取结果尽快进入类型列计算
5.1 同一个 Variant 列,可以保留三种执行形态
文件中的物理布局与内存中的计算表示不是同一件事。为了衔接不同输入和操作,Doris 的 Variant 列支持三种执行形态:
| 形态 | 保留的内容 | 适合的处理 |
|---|---|---|
| Encoded | 编码字节与 metadata 引用 | 保留二进制值,进行路径定位与序列化 |
| Typed | 可空的强类型标量列 | 对提取出的标量执行类型转换和后续计算 |
| Shredded | reader 提供的物理树、路径与子列 | 直接利用叶子列,按需恢复逻辑值 |
这些形态是执行层的表示方式,用户看到的逻辑类型仍是 Variant。筛选、截取和行选择可以继续保留拆列形态;reader 能直接提供合适的类型叶子时,就不必先重建完整文档。
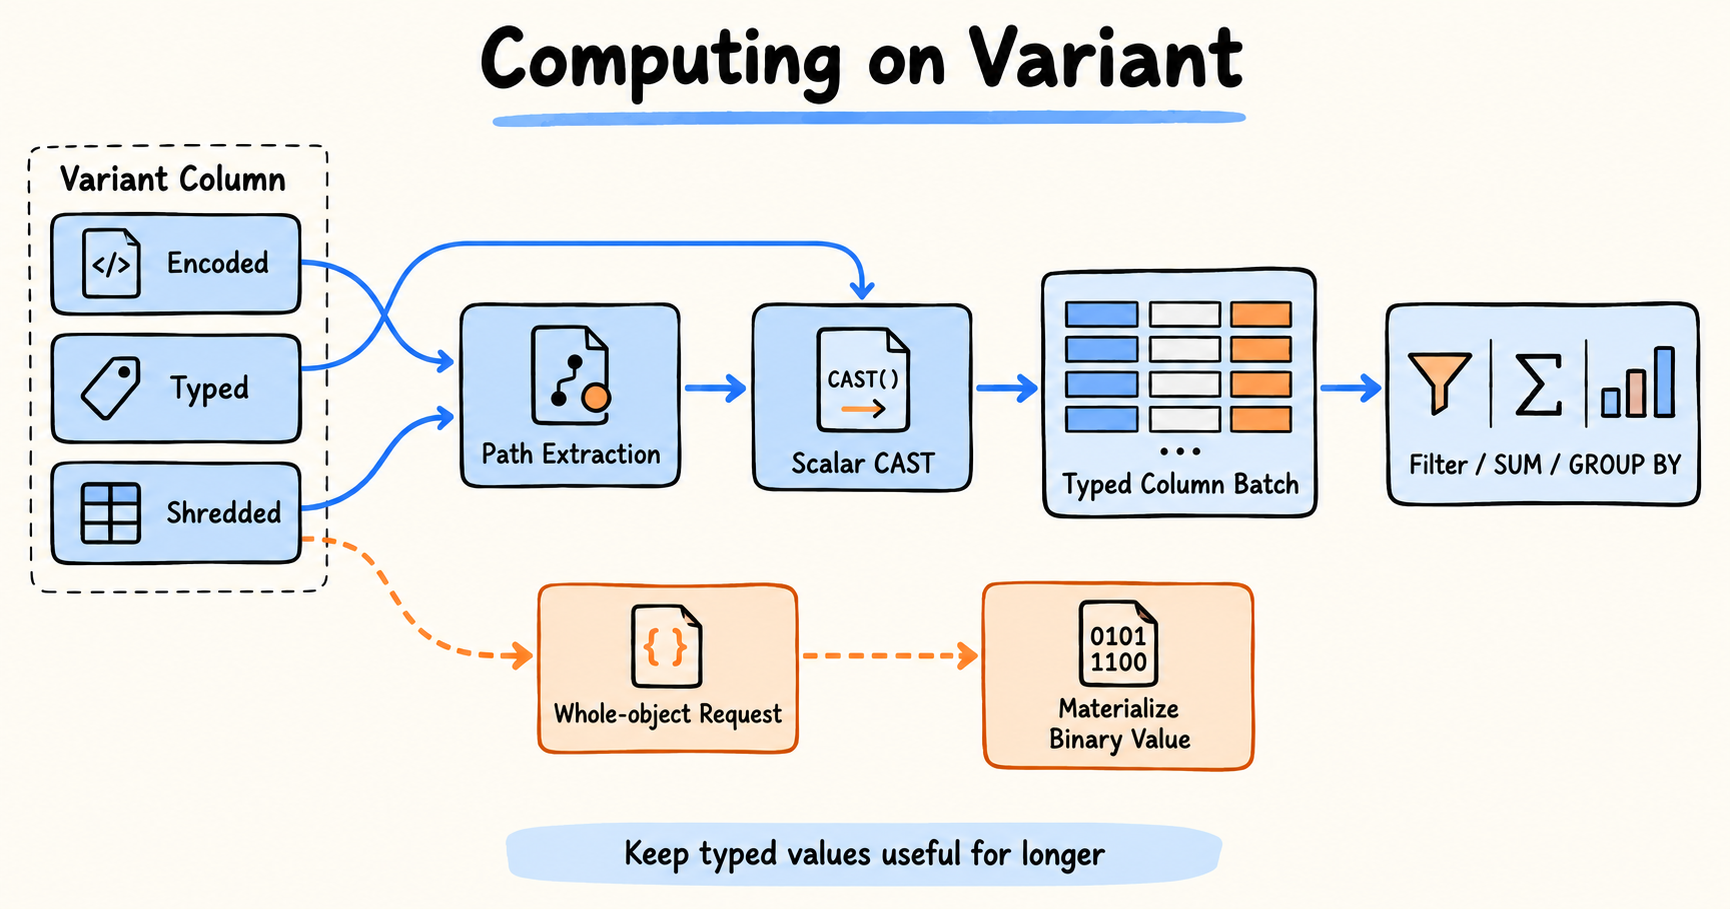
图 5|Variant 计算流程:路径提取连接不同执行形态,类型转换输出标量列,供过滤和聚合使用;整对象请求触发必要物化。图中省略了跨节点传输等序列化边界。
5.2 从路径提取到 CAST,再到向量化算子
看下面这条查询:
SELECT
    CAST(payload['region'] AS STRING) AS region,
    SUM(CAST(payload['amount'] AS BIGINT)) AS total_amount
FROM iceberg_catalog.demo.events
WHERE CAST(payload['amount'] AS BIGINT) >= 100
GROUP BY CAST(payload['region'] AS STRING);
它可以拆成三个容易理解的步骤:
-
取路径:从 Variant 中提取
region与amount。如果已有类型叶子,尽量复用;否则沿二进制结构定位相应值。 -
定类型:
CAST将结果转换为 SQL 所需的STRING、BIGINT列。标量转换中存在直接处理 typed 表示的分支,避免绕回完整文档编码。 -
按列计算:比较、筛选、分组和求和处理转换后的批次列,接入 Doris 的向量化执行链路。
对于编码形态的标量,转换实现还会按实际类型分组,批量完成转换后恢复原来的行顺序。这让混合类型数据也能衔接批量计算。
5.3 延迟物化:在真正需要时构造值
这里需要区分三个概念:shredding 是写文件时按路径拆列的过程;unshredded 描述未拆列的物理布局;重建或物化 则是在读取与执行时,将需要的子列和残余编码恢复为具体的逻辑值。读取未拆列文件,并不等于先执行一次“反向拆列”。
重建范围取决于请求内容和实际执行路径。只取 amount 且命中路径优化时,可以仅组织该路径的结果;请求 device 子对象,需要得到该子树的完整逻辑内容;请求完整 payload,则必须保留并恢复整个值。复杂子树、数组或未命中快速路径的情况,也可能回退为先重建完整值,再提取所需部分。对于拆列对象,恢复过程按嵌套结构组合类型子字段与未拆出的残余字段,同时保留字段缺失、显式 null 和原始类型的区别,而不是把几段 JSON 文本简单拼接起来。
这种按需恢复要求规划与执行配合:如果下游需要完整对象,扫描就必须保留恢复它所需的信息;只读取了投影叶子的状态不能凭空补回已省略字段。Doris 因此把“直接使用子列”和“生成规范值”的边界显式保留到执行过程中。
跨节点 Exchange 尤其需要注意:reader 持有的内存状态不能原封不动传到另一台 BE。若传输时仍保留拆列表示,序列化会将需要的内容转为可独立传输的表示;这个表示可以只包含规划确认仍需使用的投影,不必总是恢复原始完整对象。如果路径已经转成普通标量列,传输的就是这些列。因此,延迟物化不等于整条分布式查询全程都不物化,也不等于没有数据复制。
对用户来说,最直接的做法是:只选择需要的路径,并明确用于计算的目标类型。若只需地区汇总,就避免把整个 payload 一起放进下游结果;整对象需求可能增加读取、编码和传输工作。
六、高效写回:沿二进制与批次传递数据
本文所分析的实现中,Doris 向 Iceberg 写出未拆列 Variant,目标使用支持 Variant 的表格式版本与 Parquet 数据文件;Paimon 则通过原生 writer 衔接拆列能力。能够读取拆列文件,与能够写出拆列文件,是两项独立能力。因此,Iceberg 读取可以利用已有文件的拆列布局,而当前 Doris 写回链路不会自动生成同样的类型子列。
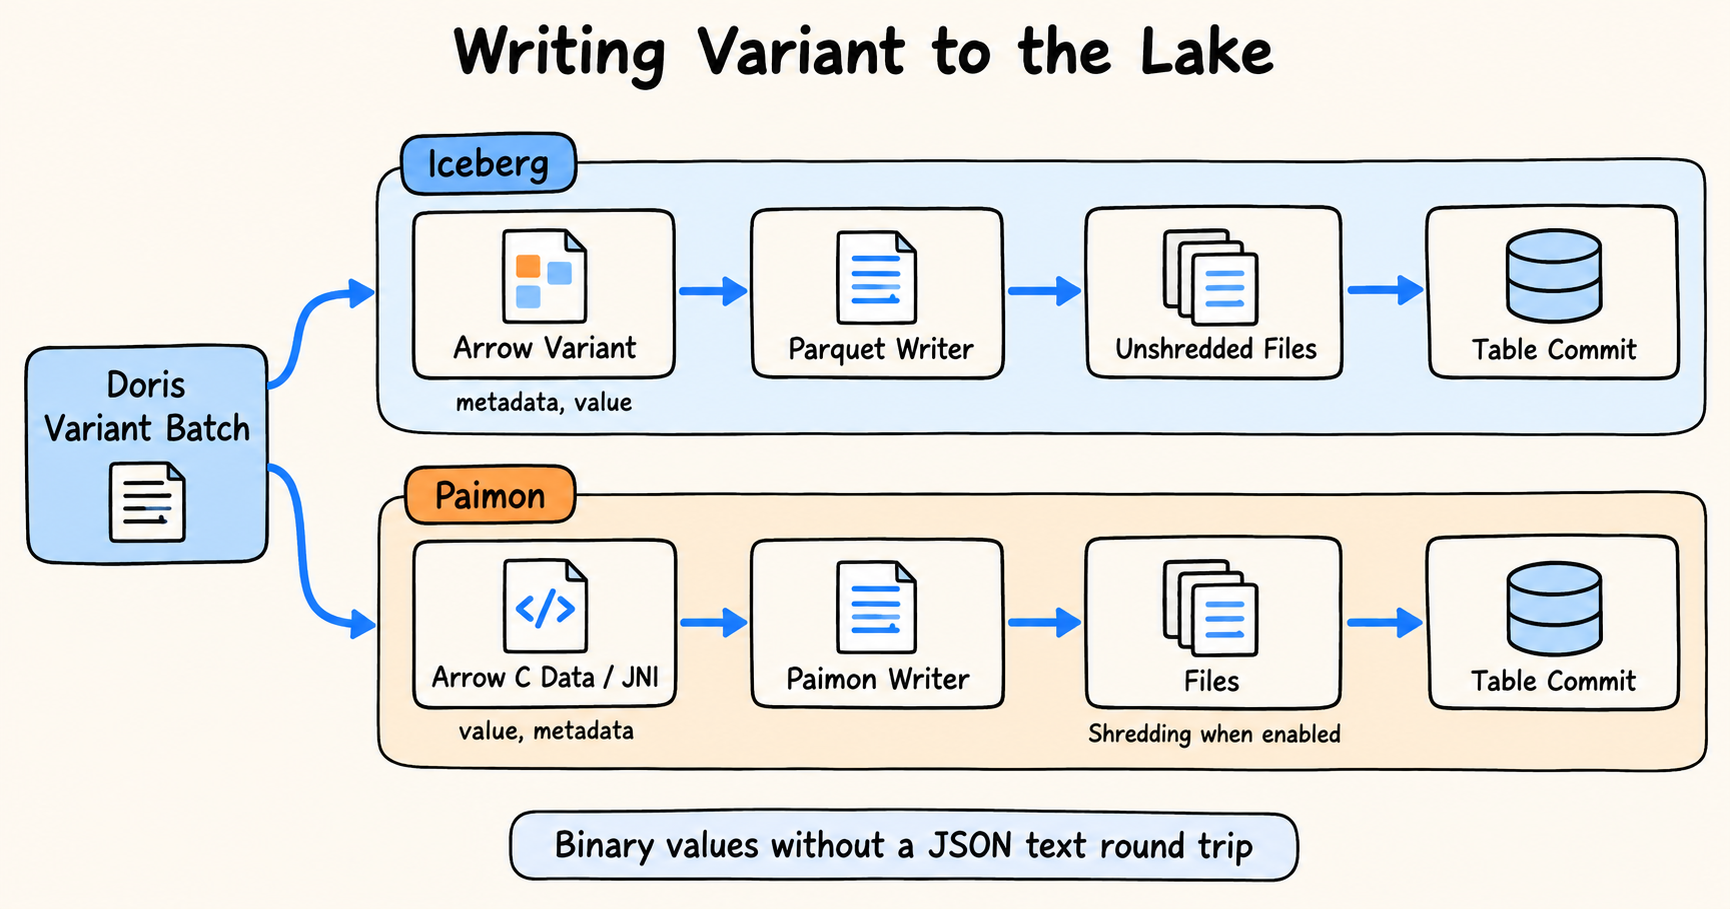
图 6|Variant 写入流程:Iceberg 通过 Arrow Variant 写出 Parquet;Paimon 通过 Arrow C Data 与 JNI 交给原生 writer。两条路径都在生成文件后进入各自的表提交机制。
6.1 Iceberg:Variant → Arrow → Parquet → 表提交
Iceberg 的 Variant 映射为 Arrow Variant extension,底层结构是 struct<metadata: binary, value: binary>。Doris 的序列化层将二进制值交给相应 builder,再由 Parquet writer 生成文件。
这避免了先输出 JSON 文本、再由另一侧解析并猜测类型的中间过程。
6.2 Paimon:Variant → Arrow 批次 → JNI → 原生 writer
Paimon 写入将 Doris Block 转为 Arrow RecordBatch,经 Arrow C Data 接口送入 Java。Variant 按 Paimon 的 struct<value: binary, metadata: binary> 组织,Java 侧以列式行视图适配 Arrow 数据,并复用行游标交给 writer。
这里利用批次传递减少逐字段跨语言交互,省去为整个批次构造逐单元格 Java 对象矩阵的中间步骤。
Paimon 原生 writer 可以采用显式拆列 schema,也可以推断拆列 schema。Doris 通过该 writer 衔接这些能力;仓库用例覆盖拆列写入和混合文件布局。不同文件拆出不同路径是正常情况,reader 需要按文件解释实际结构。
七、如何使用并验证这些优化
7.1 从正确的值开始
以下示例假设 Catalog 和支持 Variant 的目标表已经准备好,表包含 id BIGINT 与 payload VARIANT。示例依据分支实现整理,本次未连接集群执行。
INSERT INTO iceberg_catalog.demo.events VALUES
    (1, PARSE_TO_VARIANT('{"region":"west","amount":120}')),
    (2, PARSE_TO_VARIANT('{"region":"east","amount":80,"channel":"app"}'));

INSERT INTO paimon_catalog.demo.events
SELECT id, payload
FROM iceberg_catalog.demo.events;
PARSE_TO_VARIANT 表达的是将 JSON 文本解析为 Variant 内容。CAST('text' AS VARIANT) 表达的是将字符串值转换为 Variant;即使字符串长得像 JSON 对象,也不应把这两种写法混为一谈。
如果来源已经具有 decimal、日期时间等明确类型,应尽量保留类型,不要先把所有值转成字符串再入湖。跨引擎验证时,重点检查数值精度、时间语义、缺失值与 null,以及嵌套数组等边界。
7.2 用 Profile 判断优化发生在哪里
判断 Variant 是否读得高效,可以把整对象查询与单路径查询作为观察入口,但二者输出量不同,不能仅凭端到端耗时宣称加速倍数。应同时看读取字节、算子耗时和物化工作量。
| Profile 指标 | 观察重点 |
|---|---|
VariantLeafProjectionRowGroupColumns |
Row Group 中采用叶子投影的情况 |
VariantResidualProjectionRowGroupColumns |
局部投影仍需残余值的情况 |
VariantFullProjectionRowGroupColumns |
完整投影的情况 |
VariantDirectLeafRows |
直接取得叶子值的行数 |
VariantReconstructedRows / VariantReconstructionTime |
完整 Variant 重建的工作量与耗时 |
VariantUnshreddedDirectSeekRows |
未拆列数据按路径直接定位的情况 |
VariantUnshreddedPrefixReuseRows |
嵌套路径前缀复用的情况 |
7.3 评估性能时,把数据与查询一起看
-
数据:字段数、嵌套深度、混合类型和缺失值比例。
-
文件:拆列覆盖了哪些查询路径、残余值比例,以及文件和 Row Group 大小。
-
查询:单路径还是整对象、过滤选择性、转换目标类型,以及聚合和关联方式。
-
执行:冷暖缓存、并发度、实际读取字节、跨节点传输,以及 Paimon 的读取路径分布。
Doris 内表的子列与索引属于另一条存储链路,直接查询 Iceberg、Paimon 文件不会自动获得内表索引。对湖上 Variant,应围绕文件布局、读取路径和实际执行计划解释收益。
八、性能测试
前文介绍了 Variant 的读取与计算机制,下面看它们在湖上查询中的实际表现。测试先由 Spark 将 Variant 数据写入湖表,再分别使用 Doris 和 Spark 执行查询,覆盖拆列(shredded)与未拆列(unshredded)两种布局。
在本轮 Spark 写入数据的 6 组测试中,按相同查询耗时求和,Doris 的冷跑综合加速比为 15.10×,热跑为 19.14×。这里比较的是导入完成后的查询耗时,不包含数据导入耗时。
8.1 测试环境
测试采用某客户场景复刻的 10 个查询 query01–query10,数据存储在 OSS 上,文件格式为 Parquet;湖表包括 Iceberg、Paimon Append 与 Paimon PK。每种表类型分别测试拆列、未拆列两种布局,共 6 个组合;每个引擎在每种冷热状态下均覆盖 60 条次查询。测试环境为 3 台机器,每台 16 核、64 GB 内存;查询引擎为 Doris 4.2 与 Spark 4.0.1。
8.2 整体表现:拆列与未拆列布局均有收益
| 查询状态 | 查询条次/引擎 | Doris 合计(秒) | Spark 合计(秒) | 综合加速比 |
|---|---|---|---|---|
| 冷跑 | 60 | 640.610 | 9,671.722 | 15.10× |
| 热跑 | 60 | 481.396 | 9,215.467 | 19.14× |
进一步按布局汇总,拆列数据的冷跑、热跑综合加速比分别为 55.24×、58.64×;未拆列数据分别为 7.06×、9.08×。这些结果说明,在本轮查询与部署配置下,两种布局均表现出 Doris 的查询优势,拆列组合的差距更大。
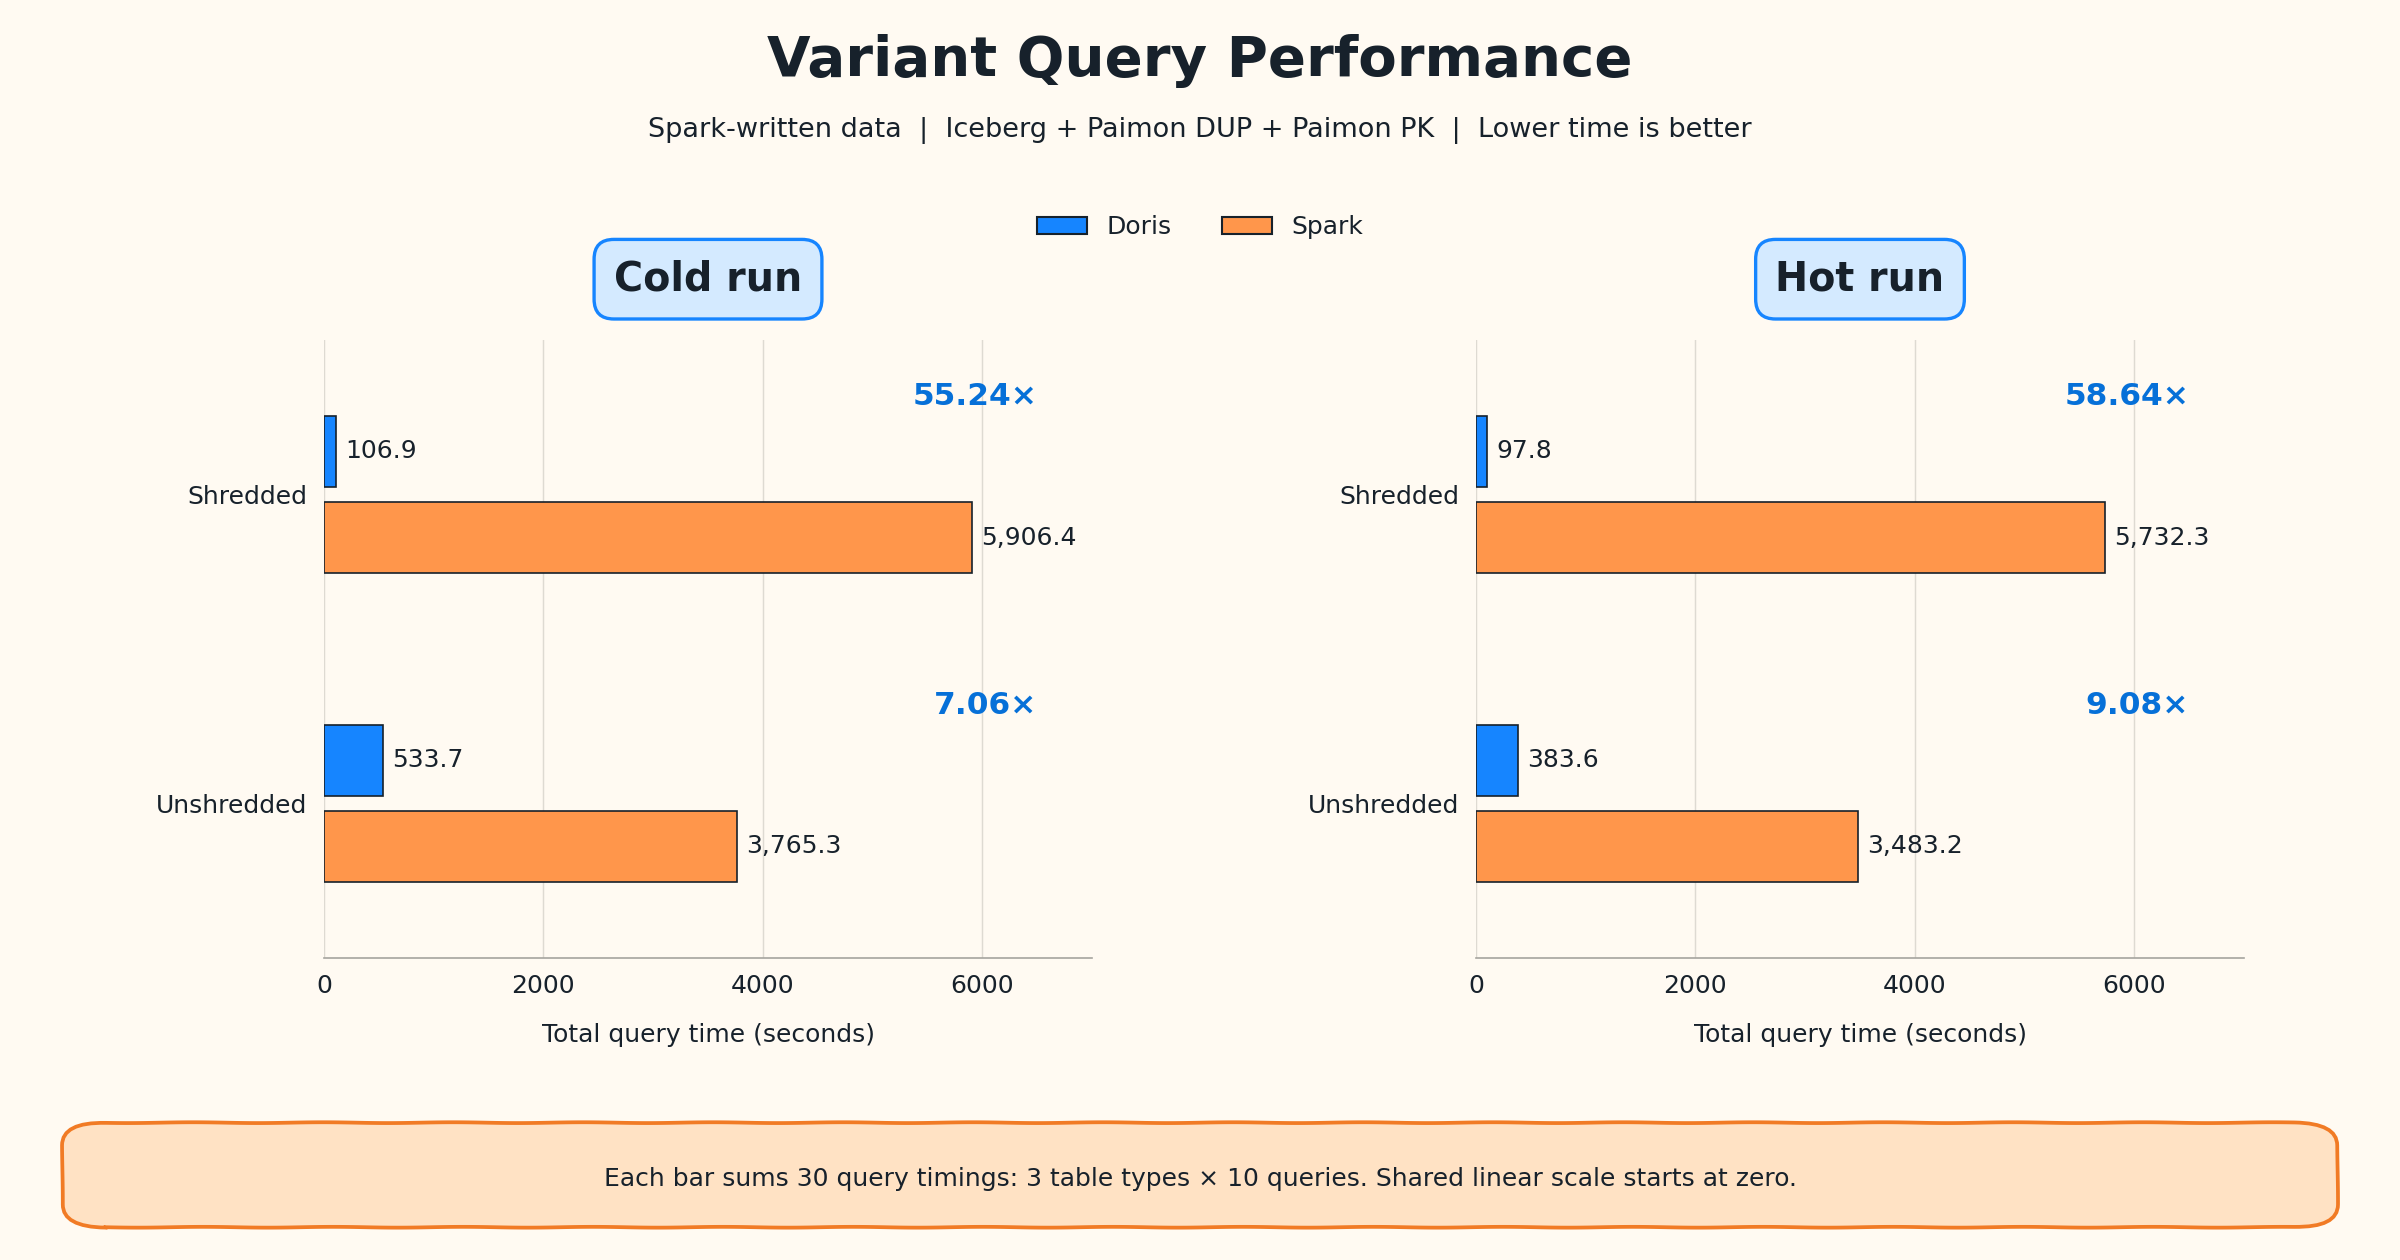
图 7|Spark 写入 Variant 数据后的查询总耗时。每根柱汇总一种布局下三种表类型的 30 条查询;冷跑与热跑使用从零开始的相同线性刻度,耗时越低越好。
8.3 分组结果:Paimon 拆列数据的差距最明显
下表每行均为同一组合 query01–query10 的耗时合计,单位为秒。
冷跑
| 数据布局 | 表类型 | Doris 耗时(秒) | Spark 耗时(秒) | 加速比 |
|---|---|---|---|---|
| 拆列 | Iceberg | 65.608 | 1,903.720 | 29.02× |
| 拆列 | Paimon DUP | 20.692 | 2,030.473 | 98.13× |
| 拆列 | Paimon PK | 20.617 | 1,972.225 | 95.66× |
| 未拆列 | Iceberg | 186.875 | 1,299.066 | 6.95× |
| 未拆列 | Paimon DUP | 172.981 | 1,255.808 | 7.26× |
| 未拆列 | Paimon PK | 173.837 | 1,210.430 | 6.96× |
热跑
| 数据布局 | 表类型 | Doris 耗时(秒) | Spark 耗时(秒) | 加速比 |
|---|---|---|---|---|
| 拆列 | Iceberg | 61.760 | 1,893.542 | 30.66× |
| 拆列 | Paimon DUP | 17.953 | 1,920.502 | 106.97× |
| 拆列 | Paimon PK | 18.048 | 1,918.227 | 106.28× |
| 未拆列 | Iceberg | 126.834 | 1,141.699 | 9.00× |
| 未拆列 | Paimon DUP | 131.740 | 1,103.885 | 8.38× |
| 未拆列 | Paimon PK | 125.061 | 1,237.612 | 9.90× |
拆列数据中,Iceberg 的热跑加速比为 30.66×,Paimon DUP 与 Paimon PK 分别为 106.97×、106.28×。未拆列数据的热跑加速比为 8.38×–9.90×。这里的百倍差距来自对应组合的 10 条查询总耗时之比。
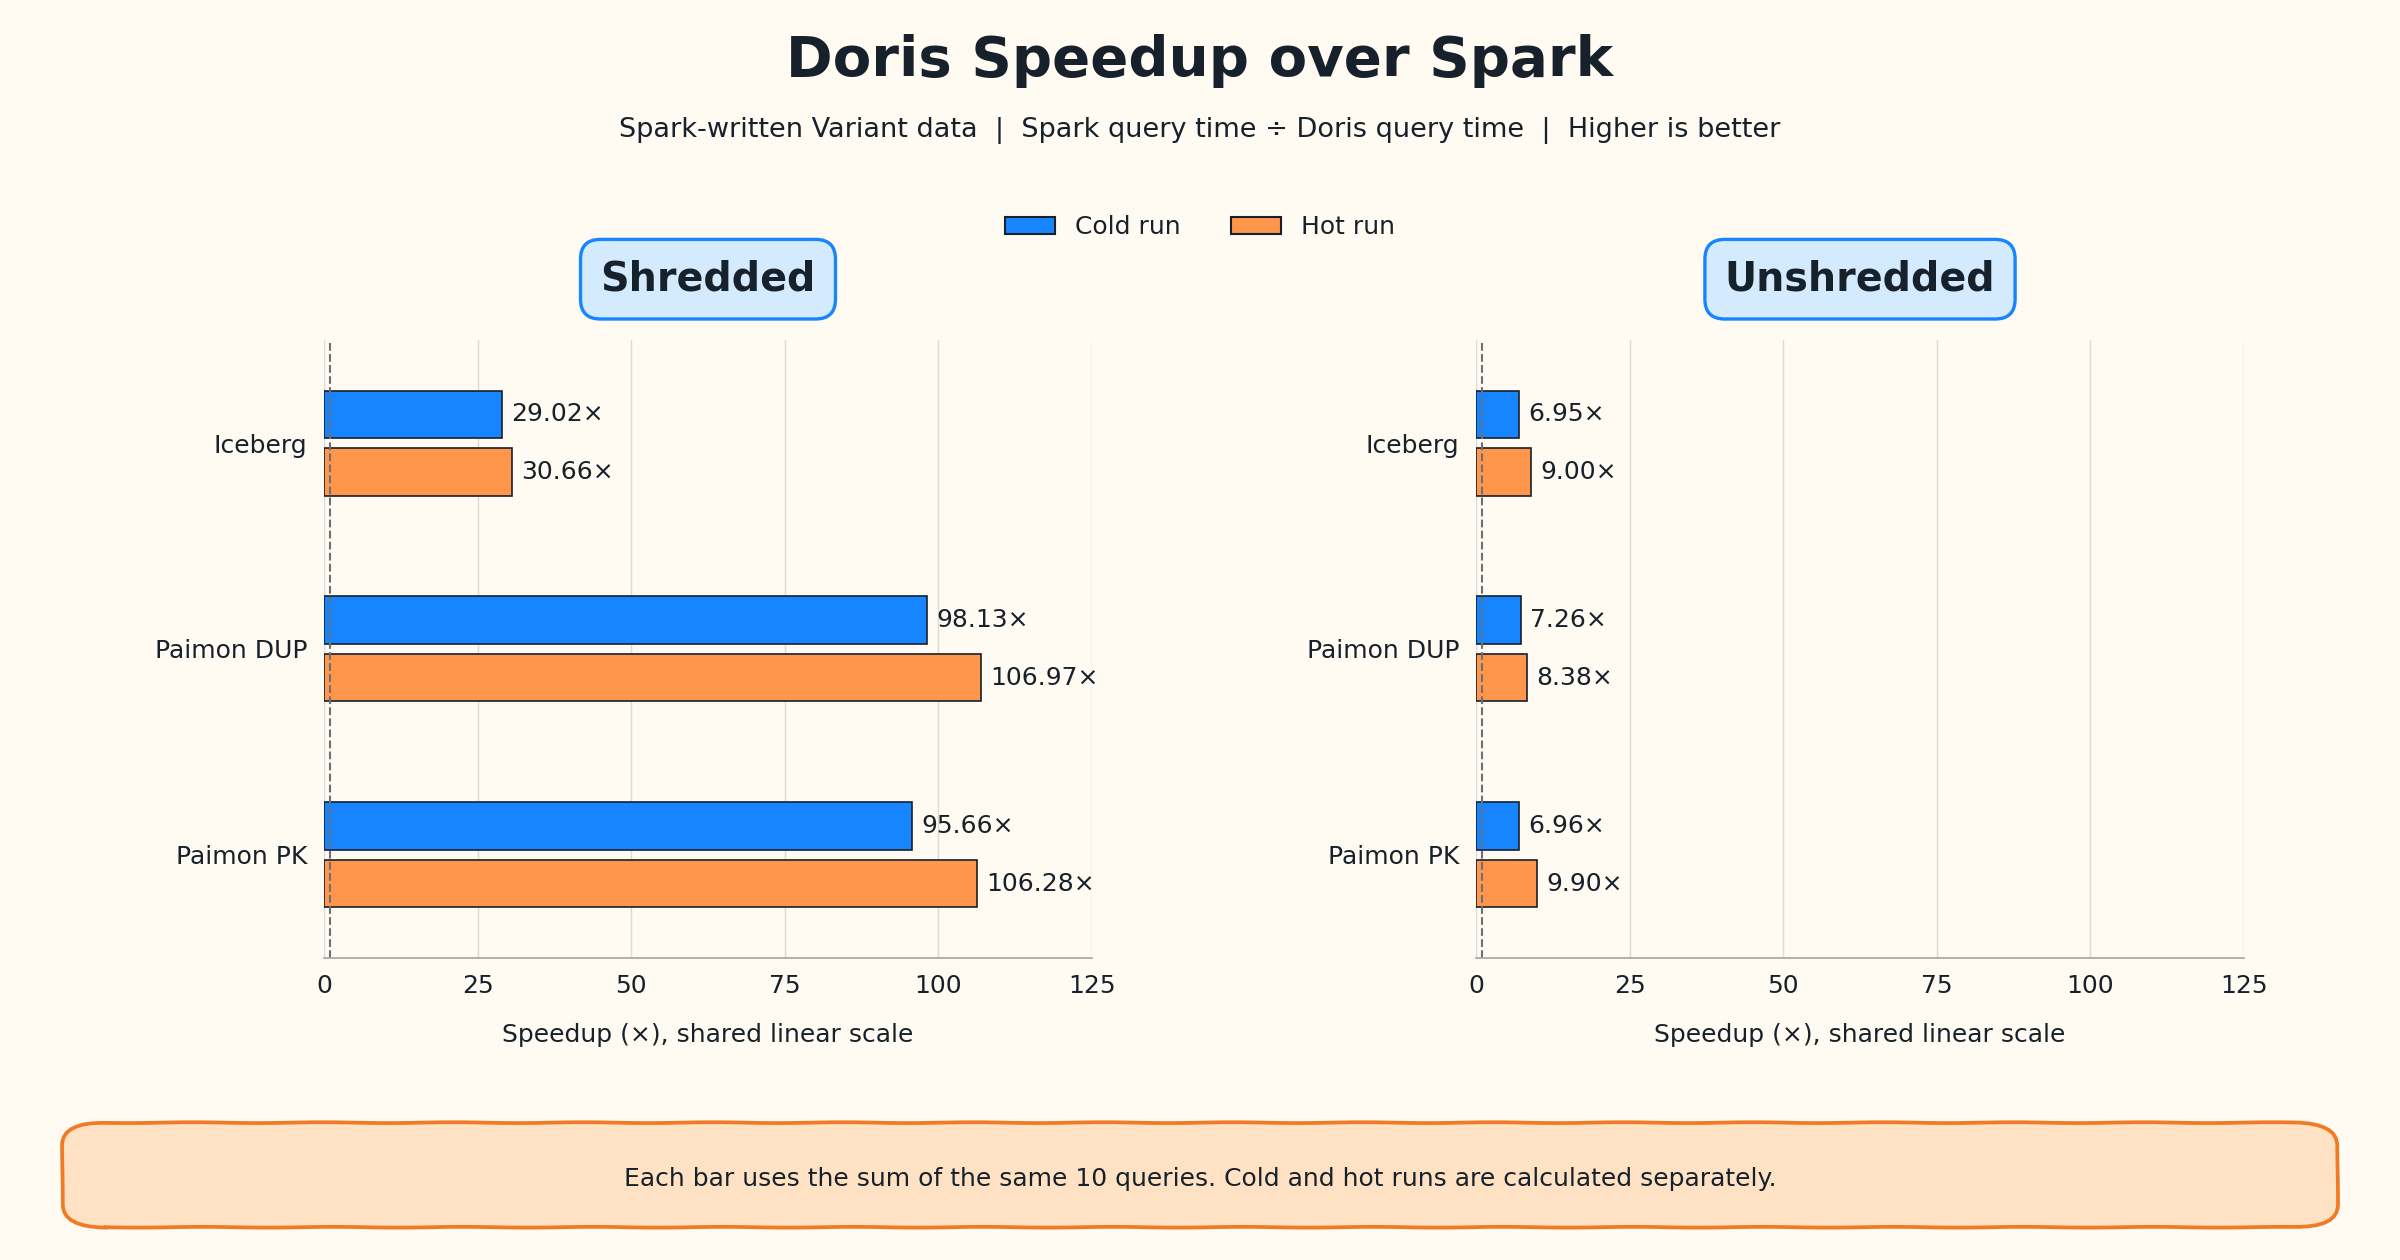
图 8|六个 Spark 写入组合的查询加速比。每根柱为 Spark 与 Doris 的 10 条查询总耗时之比;两种布局使用相同线性刻度,1× 虚线表示耗时相同。
结语:让灵活结构进入高效的列式计算
Variant 把不断变化的数据保留为带类型的值;二进制编码减少文本转换,拆列布局为列裁剪和统计裁剪创造条件。Doris 再通过路径投影、叶子列复用、标量转换、批次计算与延迟物化,将这些条件转化为实际执行收益。
对社区湖仓用户,最值得抓住的是这条主线:保存时保留类型,读取时按需取路径,计算时尽量利用类型列,写回时保留二进制语义。 Iceberg 与 Paimon 的适配细节有所不同,但都可以沿着这条主线理解和验证。
目前,Variant 以及 Iceberg、Paimon、Lance 等多模湖仓能力已合入 Doris 4.2 发版分支,将随 4.2 版本正式发布。如果你正在评估实时湖仓、多模数据分析等场景,可以前往官网了解更多。

 浙公网安备 33010602011771号