
构造,交互,Ad-hoc 专题
P16325 【MX-J29-T4】XOR and Swap(构造,Ad-hoc)
令 \(n\leftarrow 2^n\)。\(P\leadsto Q\) 太丑陋了,由于操作次数 \(2.1\times 10^6 > 2n\) 比较宽松,令 \(A=[0,1,\dots,n-1]\),考虑先做 \(P\leadsto A, Q\leadsto A\),后面一段倒着接即可。现在需要考虑对排列 \(\pi\) 进行归位。
从置换环的角度考虑。考虑直接尝试把位置 \(\color{red}x\) 归位,也就是将值 \(\color{blue}x\) 换到 \(\color{red}x\) 处。找到 \(\color{blue} x\) 现在所处的位置 \(\pi_{y}=x\),并执行操作 \(\mathrm{swap}(\pi_{x},\pi_{y})\),能进行这步操作的条件就是 \((\pi_x\oplus \pi_{y})\le (x\oplus y)\)。惊人的注意力:由于 \(\pi_y=x,\)用 \(x\) 替换 \(\pi_y\),用 \(\pi_y\) 替换 \(x\),得到 \((\pi_x\oplus {x})\le ({\pi_y}\oplus y)\),这个形式非常的整齐,令 \(w_x=(\pi_x\oplus x)\) 为权值,每次找到 \(w_x\) 最小的 \(x\) 进行归位一定是可行的。使用堆维护结合懒惰删除即可。
CF1882E1 Two Permutations(构造,Ad-hoc)
不会。想了一个很蠢的做法,假设数 \([1,x)\) 的相对位置关系已经搞定,现在要加入数 \(x\),然后发现两个递增序列不能 \(O(1)\) 次操作归并成一个递增序列,于是倒闭了。
构造题要考虑找基础结构,对排序而言最基本的操作就是交换,考虑如何交换 \(x,y\),我们发现可以:
于是我们可以做到 \(3\) 次操作交换 \(x,y\),对排列直接在置换环上交换即可,这样可以做到不超过 \((3n)\) 次操作还原一个排列。令 \(K_a,K_b\) 分别表示将排列 \(a,b\) 归位所需的最小代价。如果 \(K_a\equiv K_b{\pmod 2}\) 那么直接添加 \((1,n)\) 操作即可补齐。如果 \(K_a\not\equiv K_b{\pmod 2}\),需要想办法凑齐奇偶性。注意到我们其实还剩下 \(n\) 次操作可以用,如果 \(n\) 为奇数,可以在 \(1\) 位置进行 \(n\) 次操作,这样正好轮换一圈,并且反转了 \(K\) 的奇偶性,\(m\) 为奇数同理。如果 \(K_a\not\equiv K_b{\pmod 2}\wedge n\bmod 2=0\wedge m\bmod 2=0\),我们宣称一定无解。
从逆序对的角度考虑这个问题,任意一次交换操作 AiB 变到 BiA, 推到一下逆序对的变化,发现每次操作一定会翻转逆序对的奇偶性,因此在操作次数相同时必定会导致最终逆序对奇偶性不同,而终止序列相同,导出矛盾,因此此时必定无解。
bonus: 其实是可以增量构造的,假设我们已经将 \([1,x-1]\) 归位,序列变成 \([1,x-1][A][x][B]\),操作 \(A\) 的第一个位置,变成 \([A][x][B][1,x-1]\),再操作 \(x\) 变成 \([B][1,x][A]\),操作 \(B\) 的最后一个位置变成 \([1,x][A][B]\),因此这样可以做到 \(3\) 次操作归位,总操作数可以做到 \((4n)\),但其实还可以更优,考虑将 \([1,x-1]\) 归位定义为归位到后缀,序列为 \([A][x][B][1,x-1]\),直接操作 \(x\) 就是 \([B][1,x][A]\),进而换成 \([A][B][1,x]\),这样只需要 \((3n)\) 次操作。
CF1270G Subset with Zero Sum(Ad-hoc,图论建模)
猎奇。看条件 \(a_i\in [i-n,i-1]\),考虑转化成 \(i-a_i\in [1,n]\),然后连边 \(i\to i-a_i\),出度为 \(1\) 这样一定会连出一个基环树森林,考虑其中的一个环,设其点集为 \(S\),我们声称 \(S\) 是一组合法的解。因为环意味着可以轮换,得到 \(\sum\limits_{i\in S}i=\sum\limits_{i\in S}to_i=\sum\limits_{i\in S}(i-a_i)=\sum\limits_{i\in S}i-\sum\limits_{i\in S}a_i\)。这意味着 \(\sum\limits_{i\in S}a_i=0\),因此 \(S\) 就是一组合法的解。
CF1720E Misha and Paintings(Ad-hoc)
做了一半,死在了 Ad-hoc。设原矩阵颜色数为 \(c\)。
-
若 \(c<k\),我们需要让颜色数增加,不难发现最优的就是一个个单元格的改,操作次数就是 \(k-c\)。
-
若 \(c\ge k\),发现覆盖的贡献就是覆盖区域中完全包含的颜色数量。宣称:答案一定不超过 \(2\),我们给出一种一定可以在 \(2\) 次操作内复原的方法。考虑直接取第一个矩阵为矩阵左上角,假设覆盖完剩下的颜色数为 \(c^\prime\),约定找到最大的矩阵使得 \(c^\prime\ge k\),再往外扩展一层就有 \(c^\prime<k\)。考虑以 \((x+1,x+1)\) 为右下角往外扩展,这样每扩展一层,减少的颜色数一定是 \([0,2]\) 中的一个数。这样停下之后的颜色数一定是 \(k-1\) 或者 \(k\),如果颜色数为 \(k-1\) 把外层染成另外一种颜色即可。
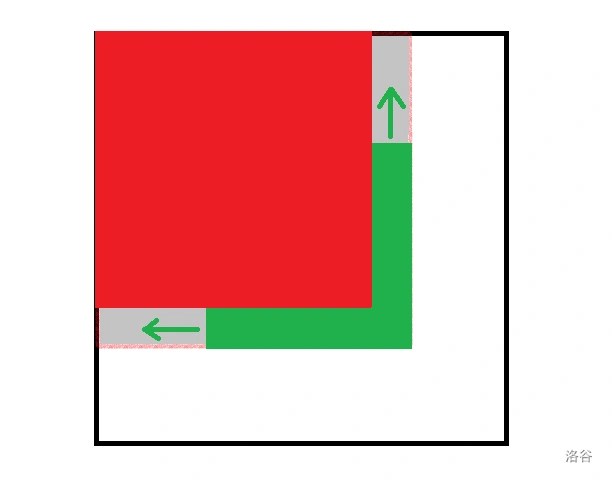
因此我们只需要判答案能不能是 \(1\) 即可。直接做即可。
CF1364E X-OR(交互,随机化)
显然知道 \(0\) 的位置就赢了,需要用不超过 \(n+C\) 次操作确定 \(0\)。由于 \(0\) 与任意数 \(x\) 询问都得 \(x\),考虑先确定任意一个位置的值 \(\pi_p=v\),尝试用其他数 \(\pi_i\) 来更新,如果 \((\pi_p\vee \pi_i)=\pi_i\) 则更新 \(p\leftarrow i\)。因为 \(0\) 可以更新任何数却不会被任何数更新,所以这样一定可以找到 \(\pi_p=0\) 的位置,因为每次一定会让 \(\mathrm{popcount}\) 单调减,更新的操作次数为 \(O(\log n)\)。现在我们需要快速确定某个位置 \(\pi_i\) 的具体值,因为交互库不自适应序列等价于随机的,考虑随机化,直接随任意 \(x\ne i\) 并询问 \((\pi_i\vee \pi_x)\),考虑这些值的按位与 \((\pi_i\vee\pi_{x_1})\wedge(\pi_i\vee\pi_{x_2})\wedge\dots\wedge (\pi_i\vee \pi_{x_k})\),我们宣称在 \(k\) 足够大时这个结果可以近似为 \(\pi_i\),考虑 \(\pi_i\) 的每一位,发现这个算法会错当且仅当 \(\pi_i\) 这一位应该是 \(0\),但是选择的所有 \(\pi_x\) 在这一位都是 \(1\),出错概率为 \(2^{-k}\), 直接取 \(k=20\) 就可以近似为正确。因此可以做到在 \(n+k\log n\) 找到 \(0\),因此总操作次数为 \(2n+k\log n\),可以通过。
CF804E The same permutation(增量构造)
考虑有解的条件。经典结论:对于排列,交换两数一定会改变排列逆序对数的奇偶性。共 \(\frac{n(n-1)}{2}\),逆序对数从 \(0\) 回到了 \(0\),因此 \(\frac{n(n-1)}{2}\) 一定是偶数,换言之,\(n\bmod 4=2,3\) 的情况无解。
然后考虑增量构造,无解的判定启发我们考虑拓展 \(n\to n+4\),\(n=0,1\) 的初始情况不用交换。
首先将 \(1\sim n\) 内部的交换都做完,然后考虑 \(1\sim n\) 和 \(n+1,n+2,n+3,n+4\) 之间的交换:
最后需要将 \(b,a,d,c\) 复原成 \(a,b,c,d\),暴搜一组合法的即可。
P17121 [ICPC 2025 Shanghai R] Menji, we miss you!(交互,树的重心)
我们可以先通过二分 \(\log_2 n\) 次问到 \(dep_x\),然后考虑从上到下确定 \(x\) 在哪一边的子树内,可以发现 \(x\) 在 \(u\) 的子树内等价于 \(\mathrm{query}(u,dep_x-dep_u)\) 为 \(1\),否则如果在其他子树内距离一定更大,但是直接这样问会退化。考虑找已确定点集的带权重心 \(u\),由于二叉树的特性,设已确定点集大小为 \(m\),那么切掉 \(u\) 之后连通块大小一定在 \([\frac{m}{3},\frac{m}{2}]\) 中,因此最劣的情况就是 \(u\) 分出的子树大小为 \(\frac{m}{3},\frac{m}{3},\frac{m}{3}\),这样每次会抛掉 \(\frac{1}{3}\) 的点,最后询问次数是 \(\log_{1.5}n\) 的,因此询问次数为 \(\log_2 n+\log_{1.5}n\),可以通过,并且显然远远跑不满。
P14227 [ICPC 2024 Kunming I] 排列(交互,分治,随机化)
诡异。操作次数大概是 \(n\log n\) 量级,比较常见的就是二分和分治。对于此题,考虑分治。
一个比较自然的想法就是确定某个区间 \([l,r]\) 内的数集为 \(S\),然后对分治中心 \(mid\),考察构成 \([l,mid],[mid+1,r]\) 的新数集 \(S_l,S_r\)。考虑如何利用这个询问,如果只含一种数显然是没用的,因此询问的序列至少要含两种数,考虑询问:
如果询问的结果为 \(0\) 或 \(2\),我们可以直接确定 \(x,y\) 所处的半边。考虑直接随机 \(x,y\in S\) 并进行这样的询问,这样有 \(50\%\) 的概率可以直接区分 \(x,y\) 并让待确定集合大小缩减 \(2\),因此每次期望可以减少 \(1\) 个数,分析一下,这样的询问次数是 \(n\log n\),超了一点。注意到我们只关注了结果为 \(0,2\) 的询问,浪费了结果为 \(1\) 的,可以发现结果为 \(1\) 意味着 \(x,y\) 一定属于同一半边,那么确定其中之一即可确定另外一个,因此我们直接将 \(x,y\) 合并为同一个数。这样一来,每次有 \(\frac{1}{2}\) 的概率减少 \(2\) 个数,有 \(\frac{1}{2}\) 的概率减少 \(1\) 个数,每次期望减少 \(1.5\) 个数,询问次数直接减少到了 \(\frac{2}{3}n\log n\),可以通过。
CF2150E2 Hidden Single(交互,分治,随机化)
考虑分治。\((l,r,S)\) 表示区间 \([l,r]\) 内部的可选答案集合为 \(S\),每次找到跨过 \(mid\) 出现的数并抛弃掉,其思想是出现了两次的数一定会在两次出现位置的中间被某个 \(mid\) 区分。具体来说,枚举 \(x\in S\),并做询问 \(\mathrm{ask}([l,mid],x)\) 和 \(\mathrm{ask}([mid+1,r],x)\),如果两个答案都是 \(1\) 那么抛弃 \(x\),如果左侧为 \(1\) 就扔到左边递归下去,如果右侧为 \(1\) 就扔到右边。但是最坏情况下每一层要做出 \(2(r-l+1)\) 次询问,这样到最后的询问次数会达到 \(n\log n\) 级别,无法接受。
注意到交互库是不自适应的,那么我们直接对位置分配一个随机的映射,也就是打乱整个排列,这样所有结果都可以在期望意义下分析。对于一个数 \(x\),其只在左、右边出现的概率都是 \(\frac{1}{4}\),因此对于值域规模为 \(n\) 的问题,其划分的子问题其实是两个 \(\frac{1}{4}n\) 规模的问题。更近一步的,我们可以加入剪枝:如果左边已经搜出答案就直接返回,左边有解的概率只有 \(\frac{1}{2}\)。并且可以发现,询问也是没必要问满的,具体来说:
- 若 \(\mathrm{ask}([l,mid],x)=0\),那么 \(x\) 一定归属在右半边。概率为 \(\frac{1}{4}\),询问次数为 \(1\)。
- 若 \(\mathrm{ask}([l,mid],x)=1\),需要再问一次,询问次数为 \(2\):
- 若 \(\mathrm{ask}([mid+1,r],x)=1\),直接抛弃 \(x\)。概率为 \(\frac{1}{2}\)。
- 若 \(\mathrm{ask}([mid+1,r],x)=0\),\(x\) 归属在左半区间,概率为 \(\frac{1}{4}\)。
由此观之,每一层判断需要的询问次数期望为 \(\frac{7}{4}n\),因此询问次数为:
解出 \(T(n)=\frac{14}{5}n\)。看似对完了,但这是期望,实际 E1,E2 都无法通过。
考虑进一步优化,我们发现如果只考虑区间中尚未被抛弃的数,那么区间长度为偶数时一定无解,因为此时区间中的数一定形如 \(x_1,x_1,x_2,x_2,\dots,x_k,x_k\),不可能出现两个落单的。我们尝试对每一层都加上这个优化,但其实是不行的,因为我们无法确定每个数的具体出现位置,因而无法确定上面所有层带来的贡献。但是这个优化对 \([1,2n-1]\),也就是对最高的区间是有用的,记在这一层跨 \(mid\) 的点有 \(c\) 个,那么对于往下走的区间 \([1,mid]\) 和 \([mid+1,2n-1]\),如果区间长度减 \(c\) 是偶数一定不合法,同时由于 \(2n-1\) 是奇数,两个区间中必定只有一个合法,只需要递归一边。加上这个优化就可以过了。
CF715D Create a Maze(构造)
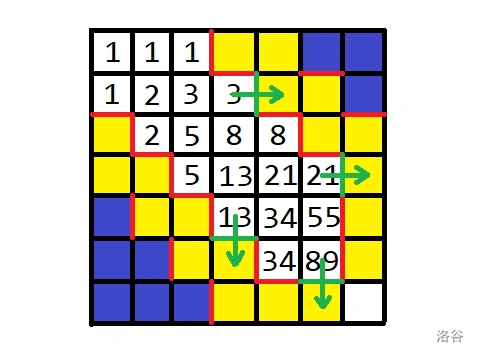
对于这种路径数量的构造,可以考虑斐波那契数列,因为任意正整数都可以用斐波那契数列的和构造出来。
CF1764G3 Doremy's Perfect DS Class(交互,二分,Ad-hoc)
考虑怎样询问对题设要求而言最有用。我们发现选取 \(Q(l,r,2)\) 是一个比较优秀的策略,按除二下取整进行配对,可以分成若干组 \((1)(2,3)(4,5)\dots\),因此 \(Q(l,r,2)\) 就是这个区间中覆盖的组的个数。发现 \(1\) 的特殊性在于 \(1\) 是唯一一个单独成组的数,但 \(n\) 为偶数时 \(n\) 也是单独成组的,不妨先考虑 \(n\) 为奇数的情况怎么做。我们其实比较关注一个区间中落单的数,而用 \(Q(l,r,2)\) 计算出这个东西其实是容易的,令 \(f(l,r)\) 表示区间 \([l,r]\) 中落单数的个数,则有 \(f(l,r)=2Q(l,r,2)-(r-l+1)\)。然后考虑怎么找 \(1\),数据范围提示我们考虑二分,如何判断 \(1\) 在 \(mid\) 的那一侧?一个比较 ad-hoc 的想法是考虑 \([1,mid]\) 和 \([mid+1,n]\) 这两个区间,令 \(L=f(1,mid),R=f(mid+1,r)\)。只问一边的问题就在于其他落单的数会干扰我们对 \(1\) 的判断,但不难发现,任意一个在左边落单的且不是 \(1\) 的数,在右边一定有落单的数与之匹配,于是两边的落单数就对消了,只有 \(1\) 是无论如何都落单的,因此结论就是 \(L,R\) 相差一定恰好为 \(1\),找结果大的那一侧二分下去,因此这部分二分可以做到 \(2\log_2 n\) 次询问。
重点在于 \(n\) 为偶数的情况,不难发现用 \(k=n\) 找到 \(n\) 是简单的,若 \(l<r\wedge Q(l,r,n)=2\) 则 \([l,r]\) 中有 \(n\),那么直接二分即可,这样需要 \(\log_2 n\) 次找到 \(n\),总询问数是 \(3\log_2 n\),可以通过 G1。考虑优化掉寻找 \(n\) 的过程,一个思想是我们并不关注 \(n\) 的具体位置,而只在二分时关注其与 \(mid\) 的关系,因此尝试不在开始时直接问出 \(n\),而是在二分必要时一次确定 \(n\)。分讨一下:
- 若 \(L=R+2\),说明 \(1\) 和 \(n\) 都在左侧,此时什么都不用问直接向左侧二分。
- 若 \(R=L+2\),说明 \(1\) 和 \(n\) 都在右侧,同理直接向右侧二分。
- 若 \(L=R\),说明 \(1\) 和 \(n\) 分居 \(mid\) 两侧,此时必须确定 \(n\) 在哪一侧并向反方向二分。
确定 \(n\) 的方位是简单的,直接询问左侧 \(Q(1,mid,n)\) 即可(注意 \(mid=1\) 时要用右侧判断)。并且由于确定 \(n\) 的方位后之后的二分都向反方向进行,那么可以直接记录 \(n\) 在当前二分区间的左侧还是右侧即可,这样整个二分过程只需要问 \(1\) 次,询问次数被优化到了 \(2\log_2n+1=21\) 次,可以通过 G2。对 G3 而言还是多了恰好一次操作。还能蒸?
将目光放到最后一次二分的位置,此时 \(r=l+1\),区间长度只有 \(2\),但是我们还是做了 \(2\) 次询问才确定 \(1\) 在哪里,尝试优化掉,通过 \(1\) 次询问找到 \(1\) 在 \(l,l+1\) 中的哪个位置,这样可以凹掉一次询问。还是分讨一下:
- 若此时没有确定 \(n\) 在哪个方位,那么 \(n\) 一定在 \(l,l+1\) 中的某个位置,直接问一下 \(n\) 在不在 \(l\) 即可。
- 若此时已经确定了 \(n\) 的方位,那么区间中只有两个数 \(1,x\),其中 \(x\) 与外界的某个落单数进行匹配。
进一步挖掘,由于询问查询的特性,此时 \(L=f(1,l-1)\) 和 \(R=f(r+1,n)\) 的结果一定已经得到了。若 \(x\) 与 \([1,l-1]\) 中的某个数匹配,那么 \(L\) 会比 \(R\) 恰好大 \(1\);反之如果 \(x\) 与 \([r+1,n]\) 匹配,\(R\) 会比 \(L\) 恰好大 \(1\)。由此可以分讨:
- 若 \(L>R\),\(x\) 一定与 \([1,l-1]\) 中的某个数匹配,考虑询问 \(L^\prime=f(1,l)\),如果 \(L^\prime<L\) 说明位置 \(l\) 贡献了匹配,此时 \(p_l=x\),答案为 \(l+1\),否则答案为 \(l\)。
- 若 \(L<R\),\(x\) 一定与 \([r+1,n]\) 中的某个数匹配,考虑询问 \(R^\prime=f(l+1,n)\),如果 \(R^\prime<R\) 说明位置 \(l+1\) 贡献了匹配,此时 \(p_{l+1}=x\),答案为 \(l\),否则答案为 \(l+1\)。
因此我们将长度为 \(2\) 的区间凹到了一次询问搞定,总询问次数为 \(2\log_2n=20\),恰好满足限制,可以通过 G3。

 浙公网安备 33010602011771号