【修仙】第一卷 初出茅庐 第二十五章 模块5
前情提要
正则表达式简介
独立的学科 用于数据的查找和校验
正则表达式之字符组
没有量词默认匹配1个字符
[0-9]表示匹配数字
[a-z]表示匹配小写字母
[A-Z]表示匹配大写字母
正则表达式之特殊符号
没有量词默认匹配1个字符
| 特殊符号 | 作用 |
|---|---|
| . | 匹配除了下划线的字符 |
| \d | 匹配数字 |
| \w | 匹配字母数字下划线 |
| \W | 匹配非(字母数字下划线) |
| ^ | 匹配字符串开头 |
| $ | 匹配字符串结尾 |
| | | 表示或关系 |
| () | 给表达式分组 |
| [] | 匹配字符组内的字符 |
| [^] | 匹配非字符组内的字符 |
正则表达式之量词
量词需跟在表达时候后面
| 量词 | 作用 |
|---|---|
| ? | 匹配0个或1个字符 |
| * | 匹配0个或多个字符 |
| + | 匹配1个或多个字符 |
| 匹配n个字符 | |
| 匹配n到m个字符 |
量词默认为贪婪匹配 使用?可以取消贪婪匹配 只获取一个
取消转义
正则表达式: \
python: r''
今日内容
re模块
re模块是python中处理正则的一种模块 并不是唯一
import re  # 导入模块

# findall()  通过正则表达式筛选出文本中所有符合的数据 返回值为列表
res = re.findall('abc', 'abcabcabcabc')
print(res)  # ['abc', 'abc', 'abc', 'abc']

# finditer() 通过正则表达式筛选出文本中所有符合的数据 返回值为迭代器对象
res = re.finditer('abc', 'abcabcabcabc')
print(res)  # <callable_iterator object at 0x000001BF27557220>
print(res.__next__())  # <re.Match object; span=(0, 3), match='abc'>
print(res.__next__().group())  # abc

# search()  通过正则表达式筛选文本中第一个符合条件的数据
res = re.search('abc', 'abcabcabcabc')
print(res)  # <re.Match object; span=(0, 3), match='abc'>
print(res.group())  # abc

# match()  从头开始匹配正则表达式 若头部都不符合 则直接退出  类似^
res = re.match('abc', 'abcabcabcabc')
print(res)  # <re.Match object; span=(0, 3), match='abc'>
print(res.group())  # abc

res = re.match('abc', 'bcabcabcabc')
print(res)  # None

# compile()  提前准备好正则 方便使用 减少代码冗余
obj = re.compile('abc')
print(re.findall(obj, 'abcabc'))  # ['abc', 'abc']
print(re.findall(obj, 'abcabcabc'))  # ['abc', 'abc', 'abc']
print(re.findall(obj, 'abcabcccabcabc'))  # ['abc', 'abc', 'abc', 'abc']

# findall针对分组的正则表达式匹配到的结果 优先展示
res = re.findall('a(b)c', 'abcabcabcabc')
print(res)  # ['b', 'b', 'b', 'b']
res = re.findall('a(bc)', 'abcabcabcabc')
print(res)  # ['bc', 'bc', 'bc', 'bc']

# 可以使用:?取消优先展示
res = re.findall('a(?:b)c', 'abcabcabcabc')
print(res)  # ['abc', 'abc', 'abc', 'abc']
res = re.findall('a(?:bc)', 'abcabcabcabc')
print(res)  # ['abc', 'abc', 'abc', 'abc']
网络爬虫简介
什么是互联网
将计算机连接在一起的网络
互联网发明的目的
数据分享
上网的本质
访问他人计算机内的资源(一般有专门用来供他人访问的计算机 这种计算机称之为服务器)
网络爬虫的本质
模拟计算机浏览器想目标网站发送请求获取数据并筛选
只要是浏览器可以访问的数据 网络爬虫一般来说都可以
实操
有点危险 怕chicken brother讲不了课
import requets  # 导入模块

# 朝目标地址发送网络请求获取响应数据(相当于在浏览器地址栏中输入网址并回车)
res = requests.get(xxx)  # 访问网站
print(res.content)  # 获取bytes类型的数据
print(res.text)  # 获取解码后的数据

# 可以通过正则表达式与()的组合优先展示数据 来获取网页标签内的内容
res = re.findall('<h>(.*)</h>')  # 就能获取h标签内的数据
第三方模块的下载
方式1:pip install 模块名==版本号
方式2:pycharm内在settings里下载
下载速度慢
pip 工具默认使用国外的源
可以手动添加源
清华大学 :https://pypi.tuna.tsinghua.edu.cn/simple/
阿里云:http://mirrors.aliyun.com/pypi/simple/
中国科学技术大学 :http://pypi.mirrors.ustc.edu.cn/simple/
华中科技大学:http://pypi.hustunique.com/
豆瓣源:http://pypi.douban.com/simple/
腾讯源:http://mirrors.cloud.tencent.com/pypi/simple
华为镜像源:https://repo.huaweicloud.com/repository/pypi/simple/
pip3.8 install 模块名 -i 源地址
下载报错
1.pip工具版本过低 直接拷贝提示信息里面的更新命令即可
python38 -m pip install --upgrade pip
2.网络波动 关键字是Read timed out
只需要重新下载几次即可 或者切换一个网络稳定一点的
3.有些模块在下载使用之前需要提前配置指定的环境
结合具体情况 百度搜索
openpyxl模块
用于操作excel表格
python中操作excel表格的模块
1.openpyxl
属于近几年比较流行的模块
对03版excel之前的版本不太兼容
2.xlwt、xlrd
同样可以操作excel表
对03版以前的excel兼容性要好与openpyxl 但使用方式较复杂
excel版本的变更
03版之前 excel文件后缀为 .xls
03版之后 excel文件后缀为 .xlsx
如果是苹果本 excel文件后缀为 .csv
openpyxl模块实操
pip install openpyxl
# 创建文件
from openpyxl import Workbook  # 导入模块
wb = Wookbook()  # 创建excel文件对象

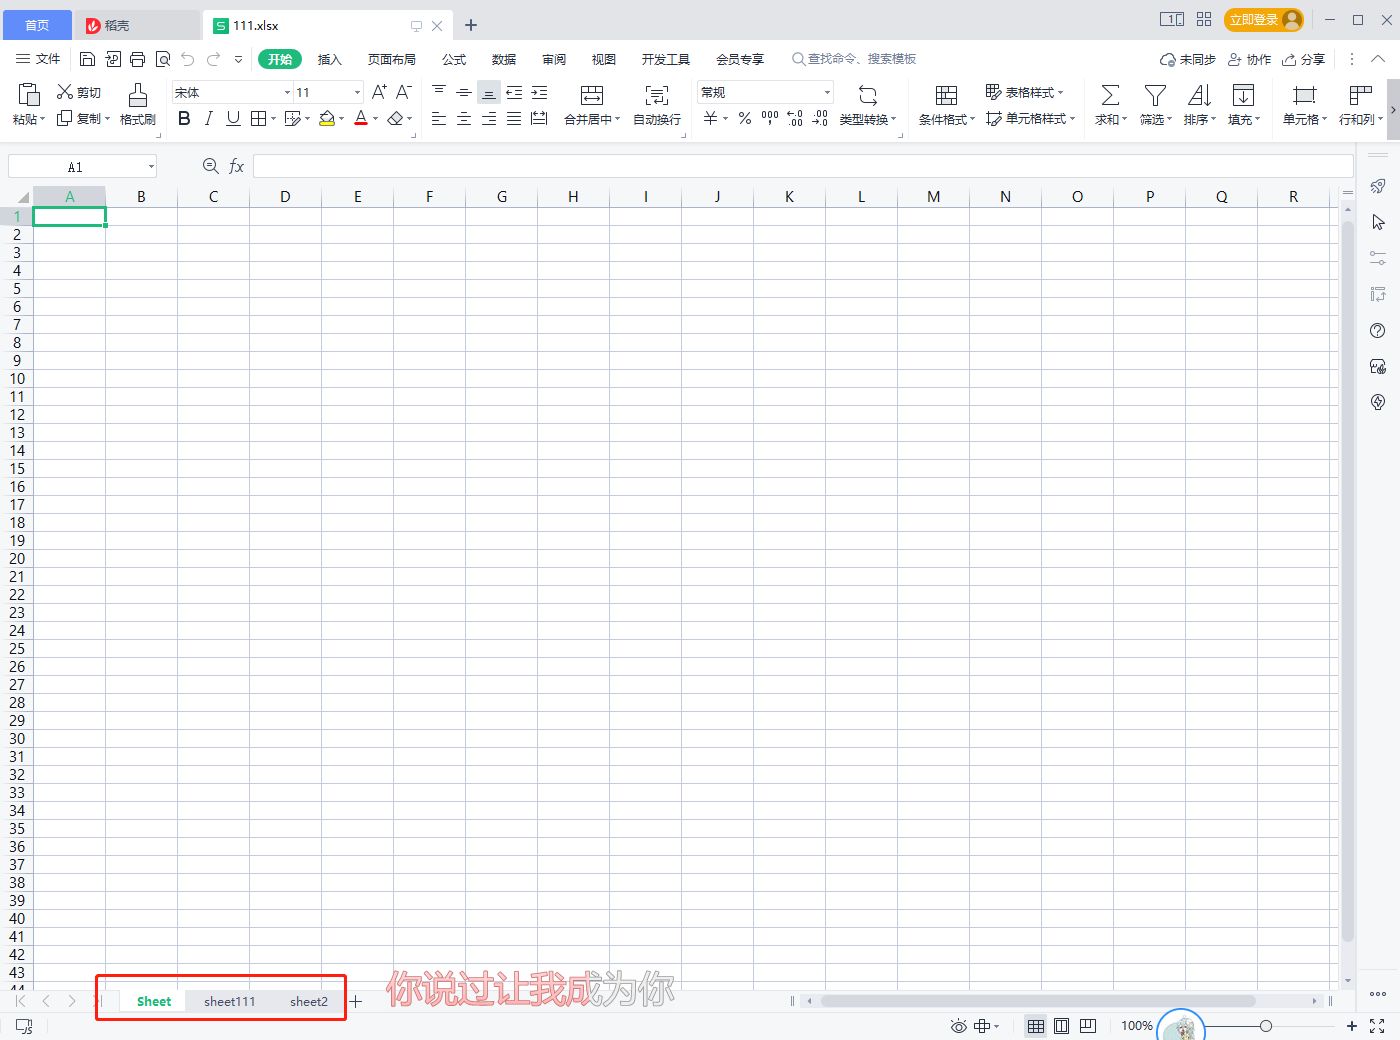
wb1 = wb.create_sheet('sheet1')  # 创建一个名为 sheet1 的工作簿
wb2 = wb.create_sheet('sheet2')  # 创建一个名为 sheet2 的工作簿

wb1.title = 'sheet111'  # 修改工作簿对象 wb1 的名字为 sheet111
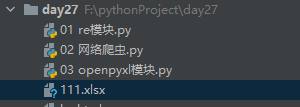
wb.save(r'111.xlsx')  # 保存excel文件

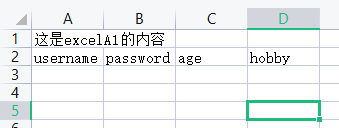
wb1['A1'] = '这是excelA1的内容'  # 可以通过 ['位置'] 的方式在指定位置填写内容
wb1.append(['username', 'password', 'age', 'hobby'])  # 也可以通过.append直接添加一行多个数据
# 也可以写算数公示
# wb1['A3'] = '=sum(A1:A2)'

wb.save(r'111.xlsx')
作业
数据保存到excel中
"""一系列获取数据的操作"""
from openpyxl import Workbook

wb = Workbook()
wb1 = wb.create_sheet('某公司分公司信息')
wb1.append(['分公司名', '分公司地址', '分公司邮编', '分公司电话'])
for info in all_list:
    wb1.append(info)
wb.save(r'某公司.xlsx')

 浙公网安备 33010602011771号
