
结对项目:小学四则运算题目生成器
结对项目:小学四则运算题目生成器
姓名与学号:伍俊霖 / 3124004183、曾毓彬 / 3124004188
GitHub 地址:https://github.com/wujunlin6666/3124004183/tree/master/pair-arithmetic-quiz
一、PSP2.1
本表按两人的结对开发过程统计。预估总耗时为 810 分钟,实际总耗时为 765 分钟。
| PSP2.1 | Personal Software Process Stages | 预估耗时(分钟) | 实际耗时(分钟) |
|---|---|---|---|
| Planning | 计划 | 30 | 35 |
| · Estimate | · 估计任务总时间 | 30 | 35 |
| Development | 开发 | 600 | 555 |
| · Analysis | · 需求分析与学习 | 60 | 55 |
| · Design Spec | · 生成设计文档 | 45 | 40 |
| · Design Review | · 设计复审 | 30 | 25 |
| · Coding Standard | · 制定代码规范 | 20 | 20 |
| · Design | · 具体设计 | 70 | 65 |
| · Coding | · 具体编码 | 250 | 220 |
| · Code Review | · 代码复审 | 45 | 50 |
| · Test | · 测试与修改 | 80 | 80 |
| Reporting | 报告 | 180 | 175 |
| · Test Report | · 测试报告 | 60 | 55 |
| · Size Measurement | · 工作量统计 | 30 | 25 |
| · Postmortem & Process Improvement Plan | · 事后总结与改进 | 90 | 95 |
| 合计 | 810 | 765 |
二、需求分析
程序包含生成和批改两种工作模式。生成模式通过 -n 指定题目数量,通过必填的 -r 限制自然数、分数值和分母;批改模式通过 -e 和 -a 读取题目文件与作答文件,并输出 Grade.txt。
实现时需要重点保证以下不变量:
- 所有数值都小于
-r,分母同样小于-r。 - 每一道题最多包含三个运算符。
- 每一个减法子表达式都满足左值不小于右值,而不是只检查最终答案。
- 每一个除法子表达式都满足
0 < 左值 < 右值,从而保证商为严格真分数。 - 同一次运行中的题目不能通过有限次交换
+或×的左右子式变成另一道题。 - 所有计算使用精确分数,输出时自动约分,并把假分数显示为带分数。
- 程序能够在合理时间内生成 10000 道互不重复的题。
对于题目中“除法结果应是真分数”的描述,本项目采用严格定义,即每个除法节点的结果都满足 0 < q < 1。
三、设计与实现过程
3.1 模块组织
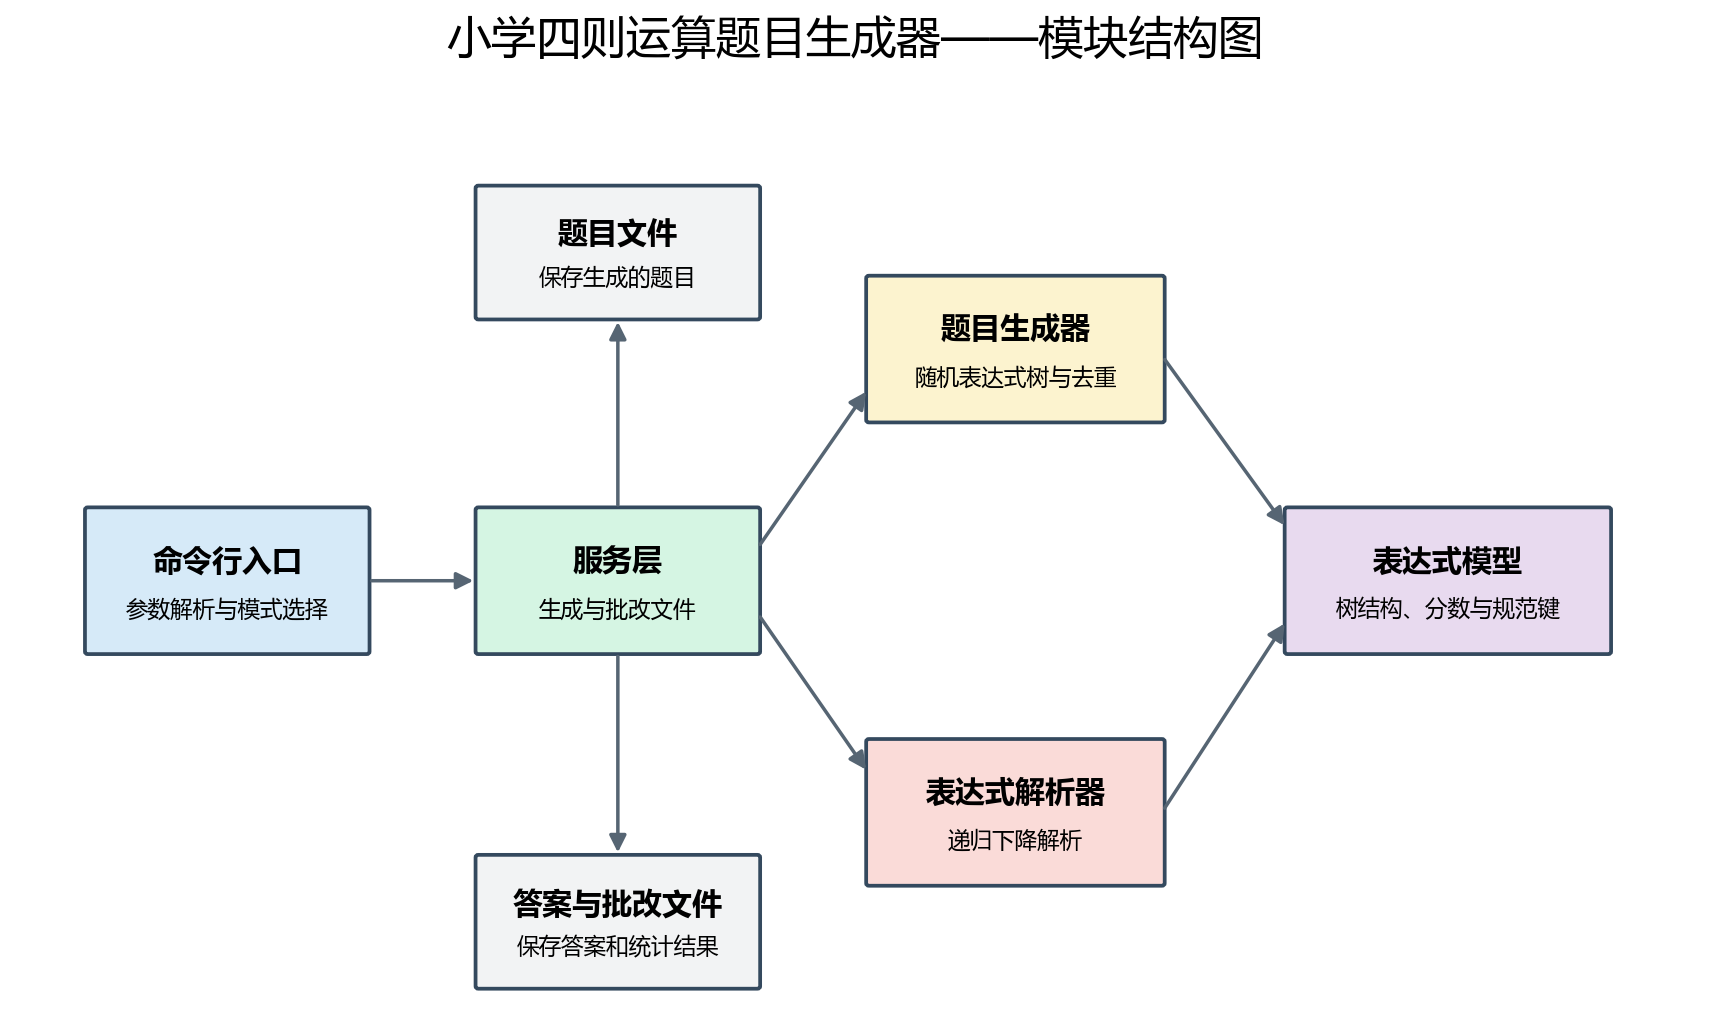
| 文件 | 职责 |
|---|---|
main.py |
程序入口,把控制权交给命令行模块。 |
arithmetic_quiz/cli.py |
定义参数、区分生成和批改模式、输出错误帮助。 |
arithmetic_quiz/expression.py |
定义数字节点和二元运算节点,负责求值、显示和规范键。 |
arithmetic_quiz/generator.py |
随机构造表达式树,检查减法和除法约束,并完成去重。 |
arithmetic_quiz/parser.py |
使用递归下降法解析已有题目,处理优先级和括号。 |
arithmetic_quiz/service.py |
生成三个文本文件,并比较用户答案与精确答案。 |
tests/test_arithmetic_quiz.py |
18 项自动测试,覆盖核心规则和文件功能。 |
生成流程为“命令行 → 服务层 → 随机生成器 → 表达式树 → 题目与答案文件”;批改流程为“命令行 → 服务层 → 表达式解析器 → 精确求值 → 批改文件”。
3.2 表达式树与精确分数
每个操作数对应一个 Number 叶子节点,每个运算对应一个 Binary 节点。表达式 (1 + 2) × 3 会保存成一棵树,因此括号和运算次序不会在生成、求值或去重过程中丢失。
数值统一使用标准库的 Fraction:
@dataclass(frozen=True, slots=True)
class Number:
    value: Fraction

    def evaluate(self) -> Fraction:
        return self.value
Fraction(1, 6) + Fraction(1, 8) 会直接得到约分后的 Fraction(7, 24),避免浮点数舍入误差。
3.3 减法和除法约束
随机生成左右子树后立刻求值。如果是减法且左值较小,就交换左右子树:
if operator == "−":
    if left_value < right_value:
        left, right = right, left
    return Binary(operator, left, right)
除法只有在两个值都大于零且不相等时才建立,并把较小值放在左边:
if left_value > 0 and right_value > 0 and left_value != right_value:
    if left_value > right_value:
        left, right = right, left
    return Binary("÷", left, right)
因此每个除法节点都满足 0 < left / right < 1。不满足条件时改用加法,避免除零和非法商。
3.4 重复题判定
不能只比较题目字符串。例如 23 + 45 和 45 + 23 字符串不同,却应判为重复。本项目为每棵树递归计算规范键:
def canonical_key(self):
    left_key = self.left.canonical_key()
    right_key = self.right.canonical_key()
    if self.operator in {"+", "×"}:
        left_key, right_key = sorted((left_key, right_key), key=repr)
    return (self.operator, left_key, right_key)
只有 + 和 × 的左右键会排序,− 和 ÷ 保持原顺序。递归处理使题目给出的 3 + (2 + 1) 与 1 + 2 + 3 具有相同规范键,而 1 + 2 + 3 与 3 + 2 + 1 仍具有不同的树结构和规范键。
3.5 答案批改
解析器按“括号 → 乘除 → 加减”的顺序建立表达式树。服务层逐题计算标准值,再把作答文本解析成 Fraction 比较。缺失答案、题号不一致和非法格式都会计入错误,不会导致整个程序崩溃。
四、效能分析
测试环境为 Windows、Python 3.13。运行:
python scripts/profile_generation.py
使用 cProfile 对生成 10000 道题的完整过程进行分析。实测共调用 2,086,459 次函数,其中 2,001,279 次为原始调用,总耗时 0.509 秒。
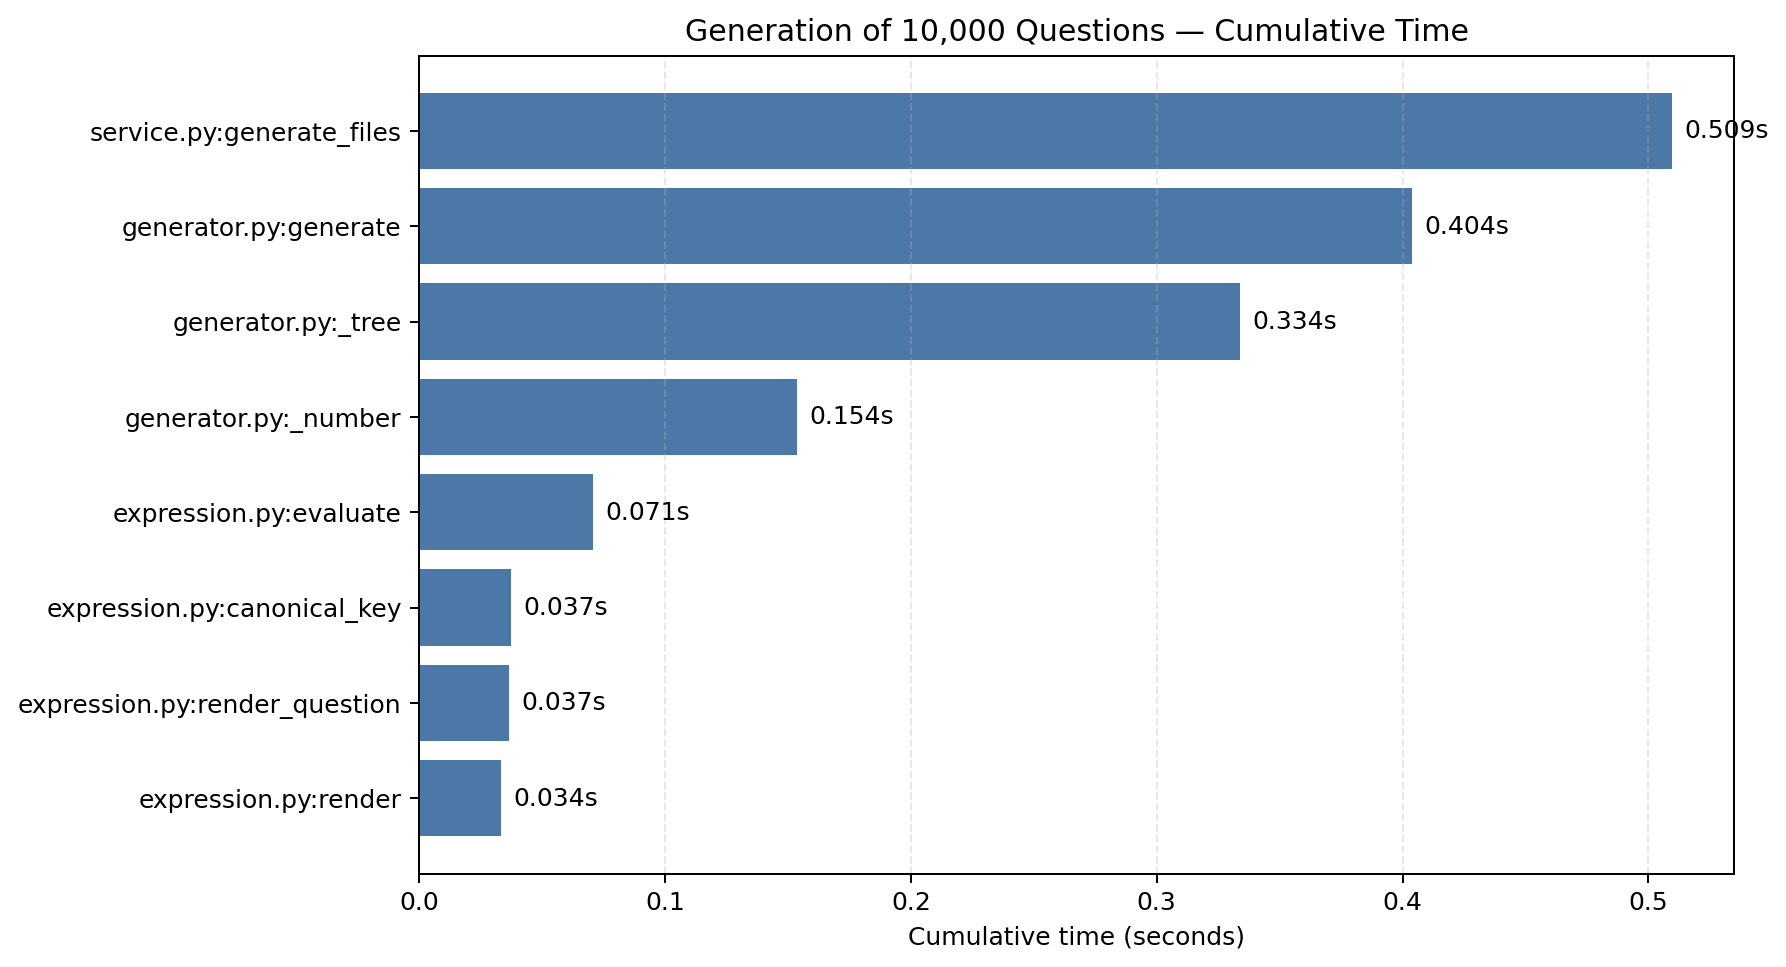
从累计耗时看,generate_files() 为 0.509 秒,生成器的 generate() 为 0.404 秒,递归构建表达式树的 _tree() 为 0.334 秒,随机产生操作数的 _number() 为 0.154 秒。因此主要开销来自随机表达式树的构造、求值和唯一性检查,文件写入不是主要瓶颈。
性能优化时,为每棵表达式树计算不可变的规范键,并使用 set 保存已生成的键。这样判断重复题的平均时间复杂度为 O(1),避免每次与此前所有题目逐一比较。生成 10000 道题仍能在一秒内完成。性能分析与优化实际耗时为 35 分钟。
五、测试运行
执行命令:
python -m unittest discover -s tests -v
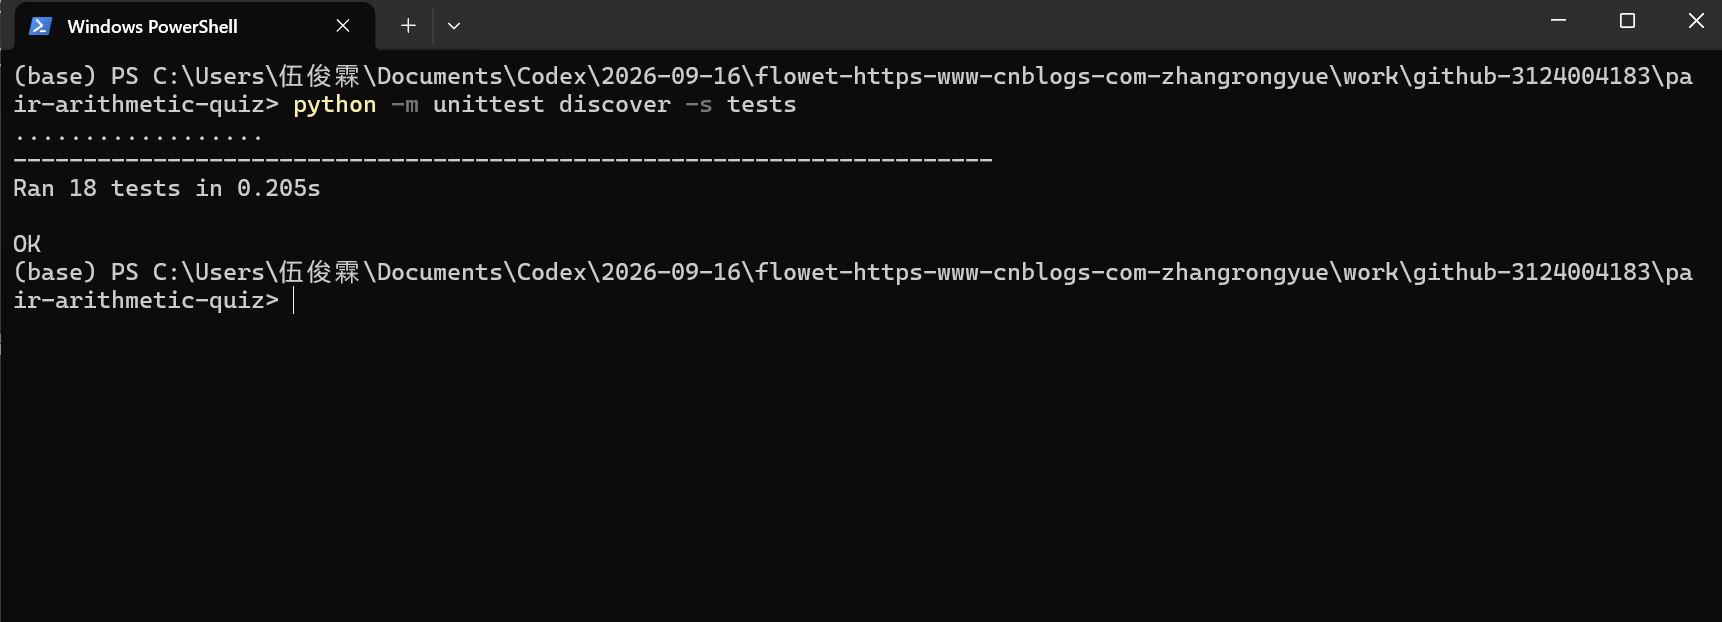
本机截图中的实测结果为 Ran 18 tests in 0.205s,全部显示 OK。主要测试如下:
| 编号 | 测试内容 | 预期结果 | 实际结果 |
|---|---|---|---|
| 1 | 自然数 3 的格式化 |
输出 3 |
通过 |
| 2 | 真分数 3/5 的格式化 |
输出 3/5 |
通过 |
| 3 | 19/8 的带分数格式化 |
输出 2’3/8 |
通过 |
| 4 | ASCII 与弯引号带分数解析 | 两种格式值相同 | 通过 |
| 5 | 1 + 2 × 3 |
结果为 7 |
通过 |
| 6 | (1 + 2) × 3 |
结果为 9 |
通过 |
| 7 | 1/6 + 1/8 |
结果为 7/24 |
通过 |
| 8 | 23 + 45 与 45 + 23 |
判定为重复 | 通过 |
| 9 | 题目给出的嵌套加法示例 | 按规则正确去重 | 通过 |
| 10 | 遍历 1000 道题的所有减法节点 | 全部左值不小于右值 | 通过 |
| 11 | 遍历所有除法节点 | 全部结果在 0 和 1 之间 | 通过 |
| 12 | 检查操作数和分母 | 全部小于 -r |
通过 |
| 13 | 检查生成题规范键 | 1000 道题没有重复键 | 通过 |
| 14 | -r 1 边界 |
能正常生成题目 | 通过 |
| 15 | 10000 道题压力测试 | 数量准确且及时完成 | 通过 |
| 16 | 题目与答案文件生成 | 行数与题量相同 | 通过 |
| 17 | 部分答案错误 | 正确分类并统计题号 | 通过 |
| 18 | 缺少答案 | 缺失题目计入 Wrong | 通过 |
正确性并非只靠观察若干随机题。测试使用固定随机种子批量生成表达式,再递归遍历每个节点检查约束;文件测试在临时目录中运行,避免受到已有文件影响。
六、运行结果
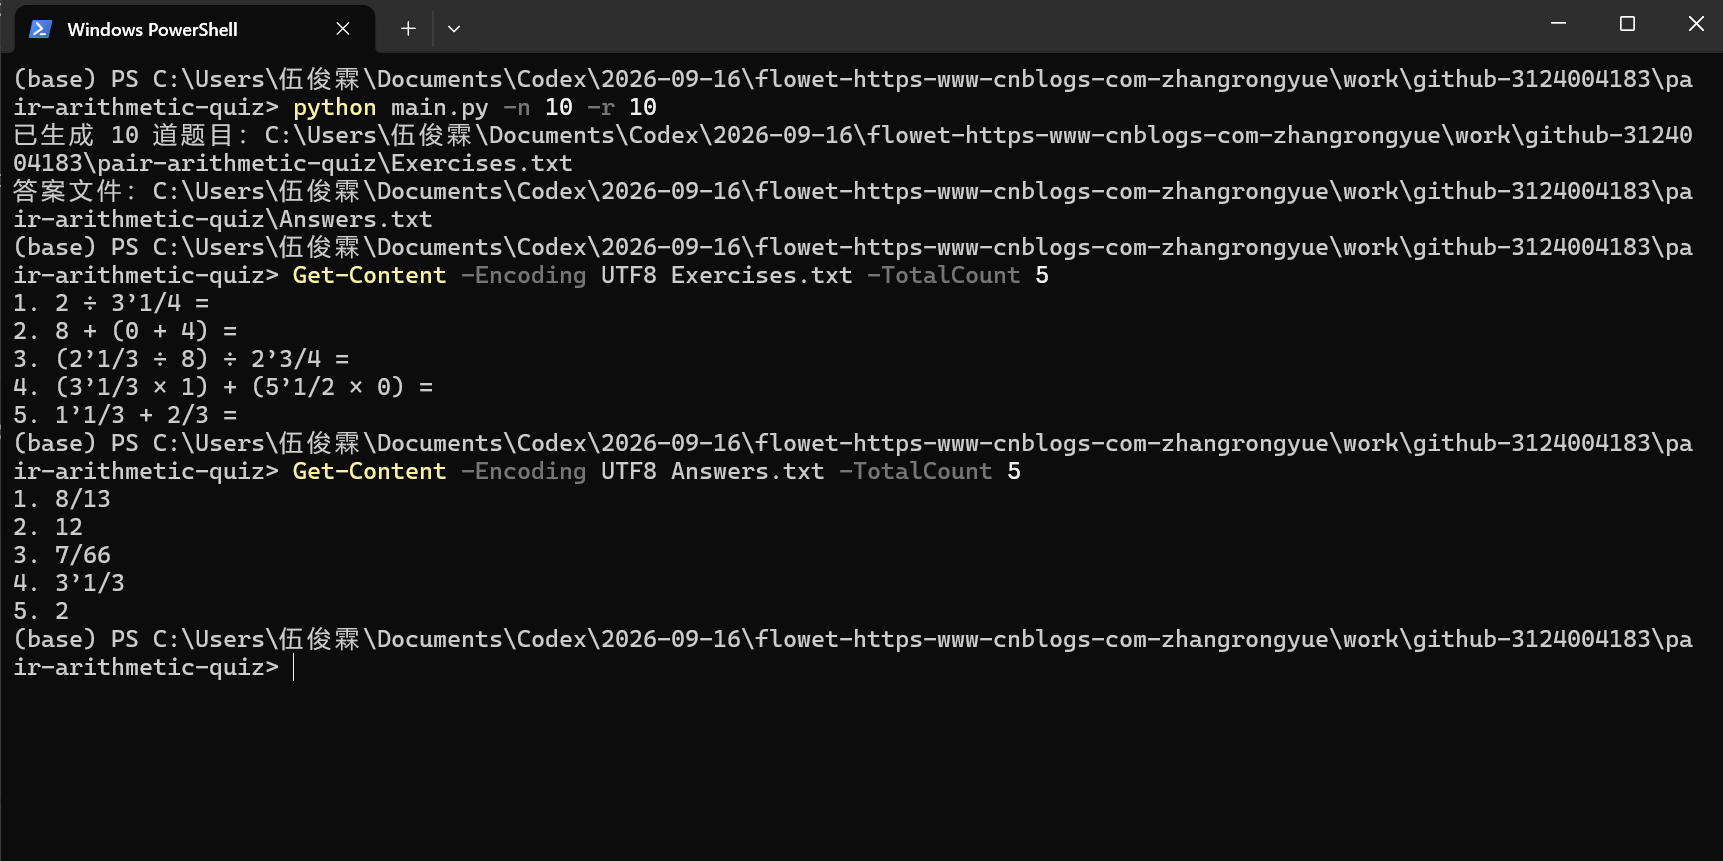
生成十道题:
python main.py -n 10 -r 10
程序在当前目录生成 Exercises.txt 和 Answers.txt。实测题目中包含自然数、真分数、带分数、括号和四种运算符,并满足运算符数量限制。
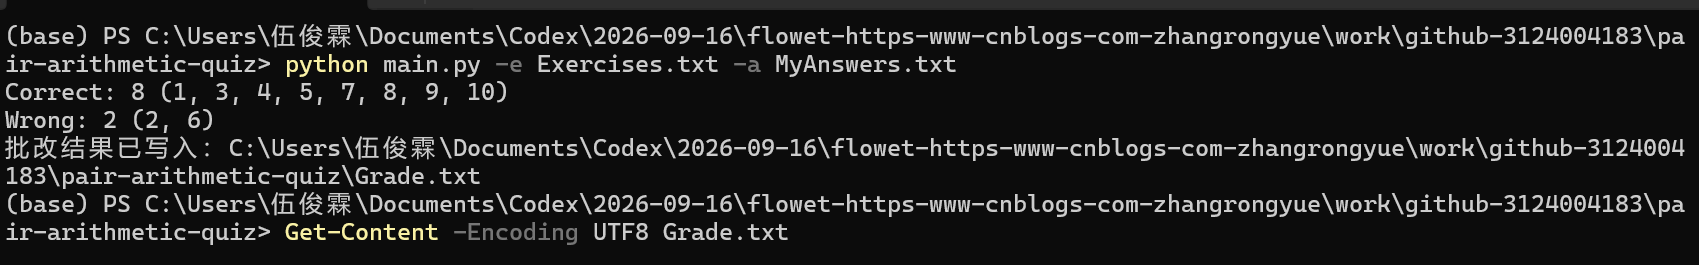
批改时把第 2、6 题故意改错:
python main.py -e Exercises.txt -a MyAnswers.txt
得到:
Correct: 8 (1, 3, 4, 5, 7, 8, 9, 10)
Wrong: 2 (2, 6)
遗漏必填的 -r 或只提供 -e 时,程序会显示完整帮助信息和明确错误原因,满足参数错误处理要求。
七、项目小结与结对感受
技术方面,本项目最容易出错的部分不是随机数本身,而是对子表达式约束和重复定义的理解。使用表达式树后,可以在每个运算节点局部检查规则;使用规范键后,复杂的“有限次交换”问题也转化为集合查重问题。自动测试让这些规则能够被重复验证,而不依赖肉眼抽查。
项目仍有改进空间,例如可以提供图形界面、允许用户设置随机种子,也可以进一步增加性质测试和覆盖率统计。
7.1 分工与结对方式
| 成员 | 主要工作 |
|---|---|
| 伍俊霖 | 需求拆解、总体结构设计、表达式树与随机生成算法、重复题判定、命令行集成、Git 仓库维护和性能分析。 |
| 曾毓彬 | 表达式解析与答案批改思路复核、测试用例设计、边界条件检查、代码复审和博客内容校对。 |
我们采用“模块负责 + 交叉复审”的方式进行结对。设计关键算法时共同讨论;进入编码阶段后按模块分工,完成一个阶段后由另一位成员检查需求覆盖情况。调试时一人负责操作和修改,另一人根据题目要求逐条核对,代码最终统一提交到主仓库。这种方式既减少了同时修改同一文件产生的冲突,也保留了结对编程中的即时反馈。
7.2 伍俊霖的项目感受
这次项目让我认识到,随机生成题目并不只是随机选择几个数字和运算符。真正困难的是在每一个子表达式上持续保持约束,并准确实现题目给出的重复定义。最初容易只关注最终答案是否非负,后来通过表达式树把检查放到每个节点,问题才变得清晰。另一个收获是自动测试的重要性:固定随机种子后批量遍历表达式树,比人工观察十几道题更有说服力。
7.3 曾毓彬的项目感受
在检查解析和批改逻辑时,我体会到输入输出格式同样是程序正确性的一部分。分数、带分数、括号和运算优先级如果只处理其中一种情况,很容易在批改阶段产生错误。通过设计边界测试和错误答案场景,我对如何从需求反推测试用例有了更直观的认识。后续如果继续改进,我希望增加更多随机性质测试,并让错误提示包含更具体的行号和原因。
7.4 对结对伙伴的评价与建议
伍俊霖认为,曾毓彬在检查边界条件时比较细致,能够从测试者角度发现正常运行之外的问题;建议后续在项目初期更早确定可投入的时间,减少任务集中到最后阶段的情况。
曾毓彬认为,伍俊霖能够快速拆解需求并完成模块整合,遇到问题时也愿意通过测试寻找原因;建议今后在编码过程中同步记录设计取舍,而不是到撰写博客时再集中整理,这样文档会更加准确,结对成员也更容易理解代码。
总体而言,这次结对让我们体会到分工并不等于彼此独立。只有通过共同确认设计、交叉检查代码和共享测试结果,才能让两个成员的工作最终形成一个可靠的完整项目。

 浙公网安备 33010602011771号