
堆基础
https://ctf-wiki.org/pwn/linux/user-mode/heap/ptmalloc2/unsorted-bin-attack/
堆基础
内容导航
- [[#一、堆与 ptmalloc 总览]]:堆、arena、bin 以及分配器的基本组成。
- [[#二、chunk 结构与分类]]:chunk 布局、元数据、标志位和特殊 chunk。
- [[#三、bin 机制]]:fastbin、unsorted bin、smallbin、largebin。
- [[#四、chunk 合并]]:释放 chunk 时的相邻空闲块合并。
- [[#五、malloc 与 free 流程]]:malloc 的查找顺序和 free 后的处理。
- [[#六、内存管理与调试]]:页式管理、glibc 版本和指定 libc。
一、堆与 ptmalloc 总览
1.1 什么是堆
堆(heap)是进程用于动态分配内存的区域。glibc 默认使用 ptmalloc 管理堆空间,
并通过 chunk、arena 和 bin 组织内存的分配、回收与复用。
1.2 堆在内存中的位置
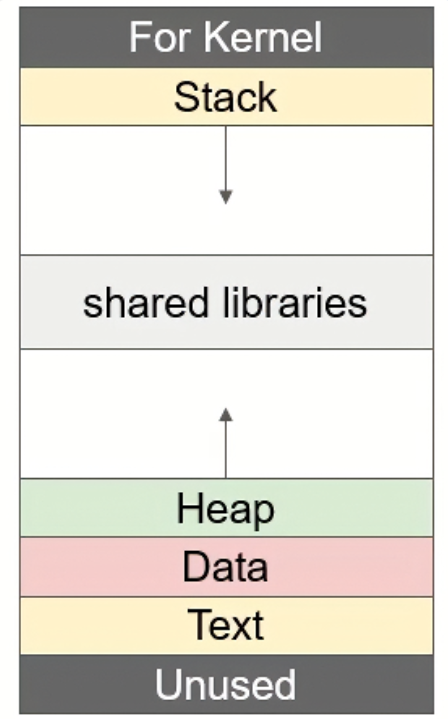
1.3 堆的对齐
堆的大小必须是8或16的倍数,如果申请的不是其倍数,会自动转换;
在32位系统中,size = 4,在64位系统中size = 8。
二、chunk 结构与分类
2.1 chunk 的状态与分类
按状态分类
- allocated chunk(正在使用)
chunk header
├── prev_size
├── size
└── 用户区 ← chunk
    └── 用户数据
- free chunk(已释放,等待复用或合并)
chunk
├── fd
├── bk
└── 其他空间
按大小和用途分类
- fast chunk:大小通常为 0x10 - 0x80 字节(不同架构可能有差异),对应 fastbin 数组中的链表。
- small chunk:大小通常为 0x10 - 0x200 字节(覆盖 fast chunk 范围),对应 smallbin 数组。
- large chunk:通常指大于 small chunk 范围的 chunk,由 largebin 管理。
- tcache:线程本地缓存,用于缓存部分小尺寸的 free chunk。
按特殊用途分类
- unsorted bin:刚释放但尚未归类的 chunk 的临时过渡区。
- top chunk:堆末尾尚未分配的空间。
- last remainder chunk:从其他空闲 chunk 切分后剩余的部分。
2.2 chunk 元数据
free chunk 的结构
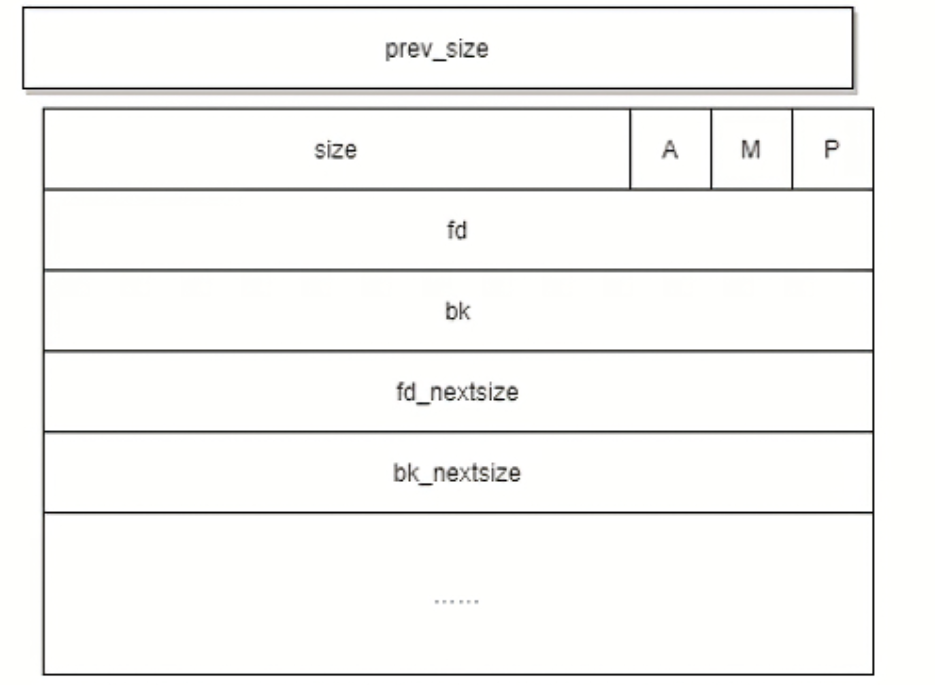
-
prev_size:若前一个物理相邻的chunk是free chunk,则表示其大小。否则用于存储前一个chunk的数据。 -
第二行的三个标志
P:PREV_INUSE若此位设置为1,表示上个chunk已被分配。M:记录当前chunk是否由mmap分配。A:NON_MAIN_ARENA,记录当前chunk是否属于主线程,1表示不属于,0表示属于。
-
fd和bkfd:是一个指针,它指向链表中前一个堆块的指针。当链表只有一个free chunk则指向的是此chunk的head。bk:是一个指针,指向链表中后一个堆块的指针。当链表只有一个free chunk则指向的是此chunk的head,通过 fd 和 bk 可以将空闲的 chunk 块加入到 chunk链表进行统一管理。
-
fd_nextsize和bk_nextsizefd_nextsize指向前一个与当前chunk大小不同的第一个空闲块,不包含bin的头指针。bk_nextsize指向后一个与当前chunk大小不同的第一个空闲块,不包含bin的头指针。- 一般空闲的
large chunk在fd的遍历顺序中,按照由大到小的顺序排列。这样做可以避免在寻找合适chunk 时挨个遍历。
free chunk 结构体
struct malloc_chunk {
    size_t prev_size;   // 前一个 chunk 的大小
    size_t size;        // 当前 chunk 的大小 + 标志位
    struct malloc_chunk* fd;  // forward 指针
    struct malloc_chunk* bk;  // backward 指针
};
2.3 in-use chunk 的结构
内存布局示例
-
堆从元数据到用户数据,是向高地址增加。
-
size of chunk表示当前堆块的大小,由于堆块的大小是8的倍数,所以堆块大小二进制的低三位是一定 0,所以可以用这几位,来表示其他的含义。
A : 1 表示不是主分配区分配的,0 表示是主分配区分配的
M: 1 表示是是 Memory Mapped 分配的内存,0 表示是 heap
P : 1 表示前一个 chunk 在使用。在初始化的时候通常为 1,防止使用不能访问的内存
我们分配两个chunk,分别为chunk_0和chunk_1。
chunk_0[0]表示userdate的区域
0x32305290:     0x0000000000000000      0x00000000000000a1    #presize        size_of_chunk
0x323052a0:     0x6161616161616161      0x6161616161616161    #userdate
0x323052b0:     0x6161616161616161      0x6161616161616161
0x323052c0:     0x6161616161616161      0x6161616161616161
0x323052d0:     0x6161616161616161      0x6161616161616161
0x323052e0:     0x6161616161616161      0x6161616161616161
0x323052f0:     0x6161616161616161      0x6161616161616161
0x32305300:     0x6161616161616161      0x6161616161616161
0x32305310:     0x6161616161616161      0x6161616161616161
0x32305320:     0x6161616161616161      0x6161616161616161
0x32305330:     0x0000000000000000      0x00000000000000a1    #presize    size_of_chunk
0x32305340:     0x6262626262626262      0x6262626262626262    #userdate
0x32305350:     0x6262626262626262      0x6262626262626262
0x32305360:     0x6262626262626262      0x6262626262626262
0x32305370:     0x6262626262626262      0x6262626262626262
0x32305380:     0x6262626262626262      0x6262626262626262
0x32305390:     0x6262626262626262      0x6262626262626262
0x323053a0:     0x6262626262626262      0x6262626262626262
0x323053b0:     0x6262626262626262      0x6262626262626262
0x323053c0:     0x6262626262626262      0x6262626262626262
chunk_0[0]:用户数据区的第 1 个 8 字节(用户可直接读写的内容)。chunk_0[-2]:对应堆块的 prev_size(用户数据区前 16 字节)。chunk_0[-1]:对应堆块的 size(用户数据区前 8 字节)。chunk_0[2]: 是用户数据区的第 3 个 8 字节
malloc_chunk 的完整定义
struct malloc_chunk{
//如果是64位系统,下面每个占8字节,64位。
    INTERNAL_SIZE_T    prev_size; /*Size of previous chunk if free*/
    INTERNAL_SIZE_T    seze;    //size in bytes,including overhead
    struct malloc_chunk* fd;    /*double links -- used only if free*/
    struct malloc_chunk* bk;

    /*Only used for large blocks : pointer to next larger size*/
    struct malloc_chunk* fd_nextsize;/**/
    struct malloc_chunk* bk_nextsize;

}
prev_size
若前一个物理相邻的chunk是free chunk,则其表示其大小。
否则用于存储前一个chunk的数据。
size
占据一字长的低3bits以后的地址,用于表示当前chunk的大小(整个chunk的大小,包括chunk头)
P 标志(PREV_INUSE)
PREV_INUSE:记录前一个chunk快是否被分配。一般来说,堆中第一个被分配的内存块的size字段的P位都会被设置位1,以便于防止前面的非法内存。当一个chunk的size的P位为0时,我们能通过prev_size字段来获取上一个chunk的大小以及地址。
fd_nextsize 和 bk_nextsize
在large_bin中指向前一个与当前chunk大小不同的第一个空闲块,不包含bin的头指针。
在large_bin中指向后一个与当前chunk大小不同的第一个空闲块,不包含bin的头指针。
一般空闲的laige chunk在fd的遍历中,按照由大到小的顺序排列。这样做可以避免在寻找合适chunk时挨个遍历。
2.4 top chunk 与 last remainder chunk
top chunk
在 ptmalloc 里:堆空间由多个 chunk 组成,最后一个 chunk 叫 top chunk,top chunk 表示当前堆末尾剩余的“未分配空间”,每次申请都会从top chunk中割出一部分成为新的chunk。
[chunk1][chunk2][chunk3][   top chunk   ]  //higer address
                                  ↑
                              sbrk 终点
当你调用:
malloc(size)
如果:fastbin / smallbin / unsorted bin 都没有合适块,就会从 top chunk 切一块下来。
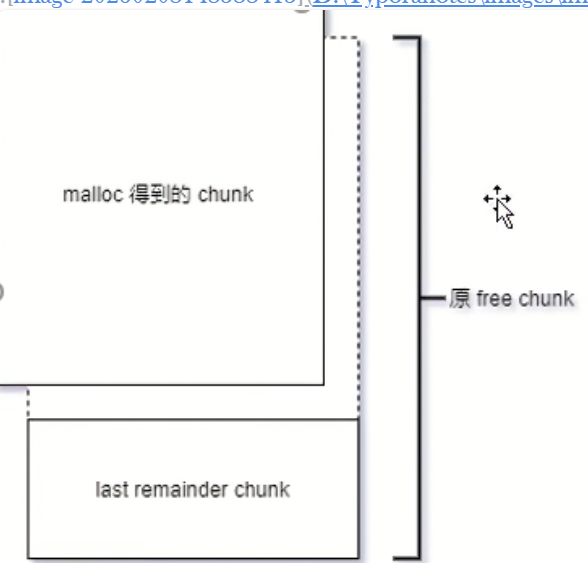
last remainder chunk
last remainder chunk是从大堆块中切掉得到的剩下来的部分。top chunk不会产生它,仅适用于其他被释放掉的堆块。
2.5 tcache机制
tcache 是 thread-local cache(线程本地缓存),即每个线程私有的小块空闲 chunk 缓存。
特点:
- glibc 2.26 引入。
- 每个线程独立维护,不需要频繁加 arena 锁。
free时,符合条件的 chunk 通常优先放入 tcache。malloc时,也通常优先从 tcache 取出。- 链表通常是单链表,使用
next指针。 - 默认每个大小类别最多缓存 7 个 chunk,具体取决于 glibc 版本和配置。
- 相关利用方式包括 tcache poisoning 和 tcache double free。
三、bin 机制
3.1 bin 的作用
bin是用来存放被free掉的chunk
在 gdb 中查看 bin
在 gdb 中可以使用 bins 命令查看:
3.2 arena
arena 是 glibc 分配器维护的一套管理上下文,可以理解为一组负责组织内存分配和释放的状态数据。它不是某一个 chunk,也不完全等同于一段 heap 内存。
arena 里维护了一套自己的堆管理数据结构,比如:
- 各种 bins(fastbin / smallbin / largebin / unsorted bin)
- top chunk、last remainder
- 锁(用于多线程同步)
malloc/free 的分配和回收,会在某个 arena 内部进行。
主线程通常使用 main_arena;多线程程序还可能创建多个线程 arena,以减少多个线程同时调用 malloc/free 时对同一把锁的竞争。一个线程不一定永久对应一个独立 arena,具体选择由 glibc 的分配器逻辑决定。
3.3 fastbin
fastbinsY 数组
fastbinsY是 glibc 中用于管理fast bin的全局数组,其核心特性如下:
- 数组大小:
- 32 位系统:10 个元素(对应 10 种fast chunk大小)。
- 64 位系统:12 个元素(对应 12 种fast chunk大小)。
- 每个元素的作用:
数组的每个元素是一个指针,指向对应fast bin的链表头 。 - 链表结构:
每个fast bin是单链表(仅用fd指针连接),采用 LIFO(后进先出)机制:- 释放 chunk 时,新 chunk 插入链表头(p->fd = fb;fb = p)。
- 分配 chunk 时,从链表头取块(*fb = fb->fd)。
fast chunk 的大小规则
fastbinsY数组中,chunk size的递增规律为:
- 32 位系统:从 16 字节开始,每次增加 8 字节(16→24→32→...→88 字节)。
- 64 位系统:从 16 字节开始,每次增加 16 字节(16→32→48→...→192 字节)。
fastbin 与 smallbin 的区别
| 特性 | fast bin | small bin |
|---|---|---|
| 存放位置 | fastbinsY数组 | smallbins数组 |
| 链表结构 | 单链表(仅fd指针) | 循环双链表(fd+bk指针) |
| 合并操作 | 不合并(禁止相邻空闲 chunk 合并) | 释放时可能合并相邻空闲 chunk |
| unused size 用途 | 仅用户数据 + 对齐填充 | 同左,但合并后可能包含更多空闲空间 |
| 适用场景 | 极高频小内存(如临时变量) | 中小内存(复用率中等) |
3.4 unsorted bin
基本概念
- 当一个 非 fastbin 范围 的 chunk 被
free,且没有立刻被合并到 top chunk,它通常会先进入 unsorted bin。 unsorted bin是一个 双向链表,每个 chunk 的fd和bk指向:main_arena里的 unsorted bin 头结点或其他 unsorted chunk。- 在glibc malloc实现中:
- unsorted bin位于main_arena:unsorted bin的头结点在main_arena结构中
- 链表连接方式:
- 每个chunk的fd指向下一个chunk
- 每个chunk的bk指向前一个chunk
- 链表末尾的chunk的fd指向unsorted bin的头结点
- 链表开头的chunk的bk指向unsorted bin的头结点
- 头结点的特殊处理:
- unsorted bin的头结点是一个特殊的chunk,不包含实际数据
- 头结点的fd指向第一个实际chunk
- 头结点的bk指向最后一个实际chunk
unsorted bin 来源
-
释放一个不属于 fastbin、且未被 tcache thread-local cache(线程本地缓存) 接收的 chunk 时:
- 如果该 chunk 与 top chunk 相邻,会与 top chunk 合并,成为新的 top chunk;
- 否则,若相邻 chunk 需要合并,先完成合并,再将合并后的 chunk 放入 unsorted bin;
- 如果不需要合并,则通常直接放入 unsorted bin。
-
chunk 需要合并相邻空闲块
- 当前 chunk 的
PREV_INUSE位为 0,表示前一个物理相邻 chunk 处于空闲状态; - 后一个 chunk 的
PREV_INUSE位为 0,表示当前 chunk 处于空闲状态; - 分配器会据此向前、向后合并。合并后的 chunk 通常先进入 unsorted bin,之后再按大小归入 smallbin 或 largebin。
- 当前 chunk 的
-
新释放的非 fastbin chunk 的过渡状态
- unsorted bin 是非 fastbin 空闲 chunk 的临时存放区。
- 在后续
malloc遍历 unsorted bin 时,不能直接满足当前申请大小的 chunk 会被重新归类到 smallbin 或 largebin。具体大小边界取决于 glibc 版本和架构。
-
从空闲 chunk 中切分出的余块
- 这里的“空闲 chunk”是指已经释放、当前不再归用户使用,并由分配器保存在 bin 中等待复用的 chunk,通常是 unsorted bin、smallbin 或 largebin 中可被切分的 chunk。
- 当切分后剩余空间至少为
MINSIZE时,余块通常会被放入 unsorted bin,等待后续复用或归类; - 从 top chunk 切分时,剩余部分仍然是 top chunk,不会进入 unsorted bin。
-
mmap分配的 chunkbrk用于直接设置进程的 program break(数据段末尾),sbrk用于按指定字节数移动 program break;glibc 可以通过它们扩展或收缩普通 heap。传统 glibc 分配普通大小的内存时可能使用它们扩展 heap;较大内存则可能使用mmap。mmap是 Linux 提供的内存映射系统调用。glibc 通常使用它申请较大的独立内存区域,这类区域不属于由brk/sbrk扩展的普通 heap。- 通过
mmap获得的 chunk 释放时通常直接调用munmap归还给操作系统,不会进入 unsorted bin。
关键特性
-
数量与结构
- 每个arena 只有一个 unsorted bin,它是循环双链表。链表中的 chunk 通过
fd和bk连接,链表头保存在对应 arena 中;主线程使用的 arena 通常称为main_arena。
- 每个arena 只有一个 unsorted bin,它是循环双链表。链表中的 chunk 通过
-
不按固定大小分类
- unsorted bin 不像 fastbin、smallbin 和 largebin 那样按大小维护固定的 bin 类别,刚释放或合并后的非 fastbin chunk 通常会先进入这里。
- 这并不表示大小完全不受限制:chunk 仍必须满足 glibc 的最小大小、对齐和地址范围等约束;通过
mmap分配的 chunk 也不会进入 unsorted bin。
-
操作逻辑
- 在常见 glibc 实现中,新 chunk 插入 unsorted bin 的头部,
malloc处理时从链表尾部开始检查,因此整体上表现为 FIFO。 malloc会在处理 unsorted bin 时检查其中的 chunk:大小恰好满足请求时直接取出;大小足够但需要切分时分配其中一部分,并处理剩余 chunk;无法满足当前请求的 chunk 则按大小重新归类到 smallbin 或 largebin。- 实际分配前通常还会经过 tcache、fastbin 或 smallbin 等路径,具体顺序取决于请求大小和 glibc 版本,不能简单概括为“fastbin、smallbin 找不到后才检查 unsorted bin”。
- 在常见 glibc 实现中,新 chunk 插入 unsorted bin 的头部,
3.5 smallbin
循环双链表与 FIFO
每个small bin是一个循环双链表,通过fd(forward,前向指针)和bk(backward,后向指针)连接所有节点。
插入与取出流程
small bin采用先入先出(FIFO) 策略,即 “最早释放的 chunk 会被最先分配出去”,具体操作如下:
- 释放内存(插入节点):新 chunk 添加到链表前端(front end)
- 当一个符合small bin大小的 chunk 被释放(如调用free)时,分配器会将其插入到对应small bin的前端(表头附近)。
初始链表:表头 ↔ A(32字节,最早释放)
释放新chunk B(32字节)→ 插入前端:表头 ↔ B ↔ A
再释放chunk C(32字节)→ 插入前端:表头 ↔ C ↔ B ↔ A
此时链表顺序为:表头 → C → B → A → 表头(循环双链表)。
- 分配内存(取出节点):从链表尾端(rear end)获取 chunk
- 当用户申请对应大小的内存(如 32 字节)时,分配器会从small bin的尾端(最后一个节点,即最早插入的节点)取出 chunk。
大小规则
- 核心规则:同一 small bin 中的 chunk 大小相等。
3.6 largebin
在 ptmalloc 中,large bin 用于管理大小达到 large-bin 阈值的空闲 chunk。这里的大小是包含 chunk 头部的 chunk size,而不是传给 malloc 的用户请求大小。
阈值与架构有关:
- 32 位系统中通常为
chunk size >= 512字节 - 64 位系统中通常为
chunk size >= 1024字节。
大小规则
64 位 glibc 有 63 个 large bin(索引 64 至 126)。其大小映射按 6 个层级近似划分:前五级的粒度依次为 64、512、4096、32768 和 262144 字节,粒度随大小增大而扩大;最后一级为容纳更大 chunk 的兜底 bin。实际边界由 largebin_index_64 宏决定,层级交界处并非严格的固定区间。
64 位系统中的精确映射:
以下范围均针对已对齐、包含 chunk 头部的 chunk size;区间右端点不包含在内。“映射粒度”指 chunk size 增加多少字节后,会被映射到下一个 large bin。
| 全局 bin 索引 | chunk size 范围 |
映射粒度 |
|---|---|---|
| 64~96 | [1024, 3136) |
64 字节 |
| 97~111 | [3136, 10752) |
512 字节 |
| 112~119 | [10752, 40960) |
4096 字节 |
| 120 | [40960, 65536) |
跨越 4096 与 32768 字节两个层级 |
| 121~123 | [65536, 163840) |
32768 字节 |
| 124 | [163840, 262144) |
262144 字节 |
| 125 | [262144, 524288) |
262144 字节 |
| 126 | [524288, +∞) |
兜底 |
最后一个 large bin 的全局索引为 126;若只在 63 个 large bin 内从 0 开始计数,则它是索引 62。
上述规则可由 glibc 的 largebin_index_64(sz) 宏表示:
((sz >> 6) <= 48) ? 48 + (sz >> 6) :
((sz >> 9) <= 20) ? 91 + (sz >> 9) :
((sz >> 12) <= 10) ? 110 + (sz >> 12) :
((sz >> 15) <= 4) ? 119 + (sz >> 15) :
((sz >> 18) <= 2) ? 124 + (sz >> 18) :
                      126
核心特性
-
同一 large bin 中的空闲 chunk 大小不必相同,但会落在同一大小映射范围内。随着 chunk 变大,映射粒度也变大:例如,64 位系统中较低序号的 large bin 按 64 字节粒度映射,而高序号 bin 覆盖的范围更宽。这样既能分组管理大块,又不必像 small bin 一样为每个固定大小设置一个 bin。
-
large bin 是循环双链表,主链通过
fd和bk连接,并按 chunk 大小降序排列;相同大小的 chunk 位于同一组。不同大小组之间还通过fd_nextsize和bk_nextsize连接,以加速按大小查找。 -
空闲 chunk 在
free后通常先进入 unsorted bin。后续malloc遍历 unsorted bin 时,若该 chunk 未被直接使用,才会按大小插入对应的 large bin;因此不能简单地认为它在释放时就直接插入 large bin。 -
分配时,分配器从能够满足请求的 large bin 中查找合适的 chunk,优先选择大小尽可能接近请求的块以减少碎片。若该 chunk 足够大,切分后的剩余部分只有在不小于
MINSIZE时才会保留为新的空闲 chunk,并通常先进入 unsorted bin;不足MINSIZE时,整块会被分配出去。
设计目的
-
高效管理大内存块
大 chunk(如 1KB~ 几 MB)的分配 / 释放频率低于小 chunk,但单次操作的开销更大。large bin通过 “范围分组” 和 “有序链表”,减少了查找合适 chunk 的时间(无需遍历所有大 chunk,只需定位到对应范围的 bin)。 -
平衡内存复用与碎片
- 同一范围的 chunk 集中管理,便于分配时找到 “最接近请求大小的 chunk”(减少拆分产生的碎片)。
- 有序链表结构使拆分后的剩余部分能快速插入到正确位置,维持链表有序性。
四、chunk 合并
在 glibc 内存分配器(ptmalloc2)中,相邻空闲 chunk(free chunk)的合并操作是减少内存碎片的核心机制。当释放一个 chunk时,分配器会检查其前后是否存在空闲 chunk,若存在则合并为一个大的空闲 chunk。
触发场景
合并操作主要在释放 chunk(调用free函数) 时触发,尤其是释放的 chunk 属于small chunk(或未被fast bin缓存的 chunk)时。具体来说,当满足以下条件时会触发合并:
-
当前释放的 chunk 是空闲状态(inuse标志为 0)
- chunk 头部的size字段中,最低位是prev_inuse标志(表示前一个 chunk 是否在使用),倒数第二位是inuse标志(当前 chunk 是否在使用)。释放时inuse会被置为 0,允许被合并。
-
前向 chunk(prev chunk)是空闲的
- 通过当前 chunk 的prev_size字段(记录前一个 chunk 的大小),可定位到前向 chunk 的起始地址。
- 若前向 chunk 的inuse标志为 0(空闲),则需要合并。
-
后向 chunk(next chunk)是空闲的
- 通过当前 chunk 的size字段,可计算出后向 chunk 的起始地址(当前 chunk 地址 + 当前 chunk 大小)。
- 若后向 chunk 的prev_inuse标志为 0(表示后向 chunk 认为当前 chunk 是空闲的,即自身是空闲的),则需要合并。
合并流程(以释放 small chunk 为例)
假设内存中存在三个相邻 chunk:A(空闲)→ B(刚释放,small chunk)→ C(空闲),合并步骤如下:
步骤 1:检查并合并前向 chunk(A 与 B)
- 从 B 的prev_size字段获取 A 的大小(例如prev_size = 0x40,即 64 字节)。
- 计算 A 的起始地址:B的地址 - B.prev_size。
- 检查 A 的inuse标志:若为 0(空闲),则执行合并:
- 新 chunk 的大小 = A 的大小 + B 的大小。
- 更新 A 的size字段为新大小,并保持prev_inuse标志(继承 A 原来的标志)。
- 移除 A 在原 bin 中的链表节点(若 A 之前存放在small bin或unsorted bin中)。
步骤 2:检查并合并后向 chunk(合并后的 A+B 与 C)
- 计算 C 的起始地址:B的地址 + B的大小(即合并后的 A+B 的地址 + 新大小)。
- 检查 C 的prev_inuse标志:若为 0(表示 C 空闲,且知道前一个 chunk 是空闲的),则执行合并:
- 新 chunk 的大小 = (A+B 的大小) + C 的大小。
- 更新 A 的size字段为最终大小。
- 移除 C 在原 bin 中的链表节点(若 C 之前存放在small bin或unsorted bin中)。
- 更新 C 的后向 chunk 的prev_size字段为最终大小(确保后续合并能正确定位)。
步骤 3:将合并后的 chunk 放入对应 bin
- 合并后的大 chunk 若大小仍属于small chunk范围,则放入对应的small bin(FIFO 链表)。
- 若超过small chunk范围(如 > 512 字节),则先放入unsorted bin过渡,后续再移至large bin。
关键细节
-
prev_inuse标志的作用
- 后向 chunk 的prev_inuse标志是 “反向通知”:若为 0,表示前一个 chunk 是空闲的,允许被合并。
- 合并后,新 chunk 的后向 chunk 的prev_inuse会被置为 0(因为新 chunk 是空闲的)。
-
避免重复合并
- 合并前需先将当前 chunk 从原 bin 中移除(否则原 bin 中会残留无效节点)。
- 合并后的大 chunk 仅保留一个头部(以最前向 chunk 的地址为起始),中间的 chunk 头部被覆盖。
-
与fast bin的关系
- fast bin中的 chunk 不会被合并(设计目标是快速复用,牺牲部分抗碎片能力),只有当fast bin中的 chunk 被迁移到small bin或unsorted bin后,才可能参与合并。
五、malloc 与 free 流程
5.1 malloc(small chunk)的查找顺序
当用户请求的内存大小属于small chunk范围(如 16-512 字节)时,分配器的处理顺序为:
fast bin → small bin → unsorted bin → large bin → top chunk → 扩展堆
5.2 malloc 核心流程
-
优先检查 fast bin(若大小匹配)
- 条件:请求大小属于fast bin范围(通常 16-128 字节)且对应fast bin非空。
- 操作:直接从对应fast bin的链表头取块(LIFO),无需遍历。
- 示例:请求 32 字节,若fastbinsY[2]非空,则直接分配。
-
检查对应 small bin
- 条件:
- 请求大小属于small bin范围(如 16-512 字节);
- 对应small bin非空(初始化后且有释放的 chunk)。
- 操作:从链表尾端取块(FIFO),时间复杂度 O (1)。
- 未初始化时的处理:
若small bin尚未初始化(首次使用),则跳过 small bin,直接进入下一步(unsorted bin)。
源码逻辑:malloc()会检查small bin的链表头指针是否为NULL,若为NULL则认为未初始化,不尝试从中分配。
- 条件:
-
检查 unsorted bin
- 条件:fast bin和small bin均无法满足请求。
- 操作:
- 遍历 unsorted bin:寻找大小恰好匹配的 chunk,或足够大且可拆分的 chunk。
- 若找到:
- 若大小恰好匹配,直接分配;
- 若过大,拆分后分配,剩余部分放回 unsorted bin 或 small bin。
- 若未找到:
- 将 unsorted bin 中的所有 chunk 按大小归类到对应的small bin或large bin,然后重新尝试从small bin分配。
-
遍历后续 bins(包括 large bin)
- 条件:unsorted bin无法满足请求。
- 操作:
-
从最小的 bin 开始遍历:依次检查small bin和large bin,寻找首个满足 “大小≥请求” 的 bin。
-
若找到:
- 从该 bin 中取出最大的 chunk(large bin按大小降序排列);
- 若 chunk 过大,拆分后分配,剩余部分放回对应 bin。
-
若未找到:进入下一步(top chunk)。
-
-
使用 top chunk
- 条件:所有 bins 均无法满足请求。
- 操作:
- 检查 top chunk 大小:若足够,直接分配(无需遍历 bins);
- 若不足:通过brk()或mmap()扩展堆,增加 top chunk 大小,确保满足需求。
5.3 free 后的处理
为了减少内存碎片,ptmalloc在释放当前堆cur chunk时会检测cur chunk的P位和cur_chunk的物理相邻的下一个chunk是否是top chunk、物理相邻的下一个chunk的P位。
如果curchunk的P位为0则合并物理相邻的上一个chunk,并且chunk的起始地址变为上一个chunk。
如果curchunk的物理相邻的下一个(高地址)chunk的P位为0,则向前合并并且将curchunk的起始地址作为新的chunk的起始地址。
如果待释放的前一个(高地址)chunk为topchunk,则将curchunk和topchunk合并,并且将curchunk的地址作为topchunk的新地址
六、内存管理与调试
- 页式管理:任何地址的16进制的后三位都将保持不变。
6.1 查看 glibc 版本
glibc管理在libc文件中。
# strings libc-2.23.so | grep GLIBC_
GLIBC_2.2.5
GLIBC_2.2.6
GLIBC_2.3
6.2 设置加载指定的 libc 文件
gdb ./vulnerable_program
(gdb) set environment LD_PRELOAD ./libc/libc.so.6
(gdb) run

 浙公网安备 33010602011771号