
MISC-先声夺人
ISCC2026 WriteUp 提交模板
MISC-先声夺人
解题思路
1.初步侦查
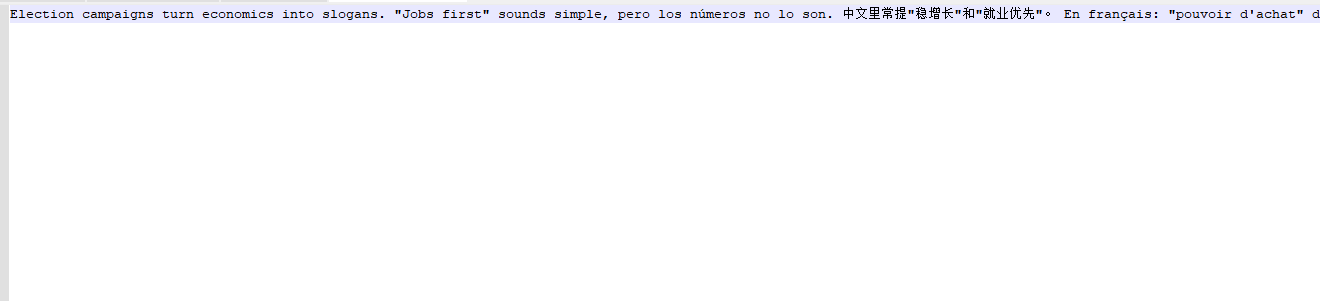
解压附件只有一个 `challenge.txt。
对文件做一次字符统计,只保留常见的零宽字符:
from pathlib import Path
from collections import Counter

text = Path("showtime_01_extracted/challenge.txt").read_text(encoding="utf-8")
zw = [ch for ch in text if ch in "\u200b\u200c\u200d\ufeff"]

print(len(text))
print(len(zw))
print({hex(ord(k)): v for k, v in Counter(zw).items()})
得到的关键结论是:
- 文本总长度:
2878 - 零宽字符总数:
2592 - 一共出现 4 种零宽字符
分别是:
U+200BZero Width SpaceU+200CZero Width Non-JoinerU+200DZero Width JoinerU+FEFFZero Width No-Break Space / BOM
这里有两个信号:
-
恰好是 4 种符号
这很像四进制编码,每个符号可以表示0/1/2/3。 -
总数
2592可以被4整除
2592 / 4 = 648,也就是说,如果每 4 个零宽字符拼 1 个字节,那么正好能还原出648字节数据。
2.还原载荷
把四种零宽字符按顺序映射成:
U+200B -> 0U+200C -> 1U+200D -> 2U+FEFF -> 3
然后每 4 个符号拼成一个字节:
byte = (a << 6) | (b << 4) | (c << 2) | d
其中 a/b/c/d 是四进制位。
按这个规则恢复后,会拿到 648 字节数据。但直接解压会失败,因为前面还有 4 个无意义字节。跳过前 4 字节后,剩余部分可以成功做 zlib 解压。
也就是说,真实结构是:
[4 字节前缀][zlib 压缩数据]
核心恢复代码如下:
import zlib
from pathlib import Path

ZW = ["\u200b", "\u200c", "\u200d", "\ufeff"]
table = {ch: i for i, ch in enumerate(ZW)}

text = Path("showtime_01_extracted/challenge.txt").read_text(encoding="utf-8")
seq = [ch for ch in text if ch in table]
vals = [table[ch] for ch in seq]

raw = bytearray()
for i in range(0, len(vals) - 3, 4):
    a, b, c, d = vals[i:i + 4]
    raw.append((a << 6) | (b << 4) | (c << 2) | d)

payload = zlib.decompress(bytes(raw[4:]))
print(payload.decode())
zlib 解出来后不是 flag,而是一份结构化的 JSON 配置:
{
  "difficulty_bits": 26,
  "nonce": "inst_000_42ba6c3fb9863dfa",
  "key_derivation": {
    "algorithm": "PBKDF2-HMAC-SHA256",
    "iterations": 10000,
    "dklen": 32
  },
  "aes": {
    "algorithm": "AES-256-CBC",
    "padding": "PKCS7"
  },
  "encrypted_flag": {
    "iv": "5dc0b444e4ff507d4af8dcda8e64afa9",
    "ciphertext": "aa228292d48f64709888c44ce7c331b04e486e566f573fef354370c5f166d8ae68e6556e9607e1da07bc79203c092372"
  }
}
- 先解一个 PoW
- 用求出的
s作为口令 - 做 PBKDF2 派生出 AES key
- 再用给定的
iv + ciphertext做 AES-CBC 解密 - 去掉 PKCS7 padding,得到 flag
3.POW部分
JSON 中的要求是:
从
s = 0开始递增,找到最小的非负整数s,使得
SHA256(nonce || str(s))至少具有difficulty_bits个前导 0 bit
difficulty_bits = 26`,所以判断规则是:
- 前
3个字节必须都是0x00,即先满足24个 0 bit - 第
4个字节的最高2bit 也必须为0
可以写成:
def digest_matches(digest, difficulty_bits):
    full_bytes, remain = divmod(difficulty_bits, 8)
    if digest[:full_bytes] != b"\x00" * full_bytes:
        return False
    if remain == 0:
        return True
    return (digest[full_bytes] >> (8 - remain)) == 0
用多进程并行枚举,最终得到:
s = 39235849
PoW 拿到 s=39235849 后,后续就比较标准了。
密钥派生规则来自 JSON:
- 算法:
PBKDF2-HMAC-SHA256 - 密码:
str(s)的 UTF-8 - salt:
nonce的 UTF-8 - 迭代次数:
10000 - 输出长度:
32字节
然后:
- 用派生出的 32 字节作为 AES-256 密钥
- 模式是
AES-CBC - IV 直接用 JSON 给出的十六进制串
- 解密后去掉
PKCS7填充
核心代码如下:
import hashlib
from cryptography.hazmat.primitives.ciphers import Cipher, algorithms, modes

nonce = "inst_000_42ba6c3fb9863dfa"
s = 39235849
iv = bytes.fromhex("5dc0b444e4ff507d4af8dcda8e64afa9")
ct = bytes.fromhex("aa228292d48f64709888c44ce7c331b04e486e566f573fef354370c5f166d8ae68e6556e9607e1da07bc79203c092372")

key = hashlib.pbkdf2_hmac(
    "sha256",
    str(s).encode(),
    nonce.encode(),
    10000,
    dklen=32,
)

cipher = Cipher(algorithms.AES(key), modes.CBC(iv))
decryptor = cipher.decryptor()
pt = decryptor.update(ct) + decryptor.finalize()

pad_len = pt[-1]
flag = pt[:-pad_len].decode("utf-8")
print(flag)
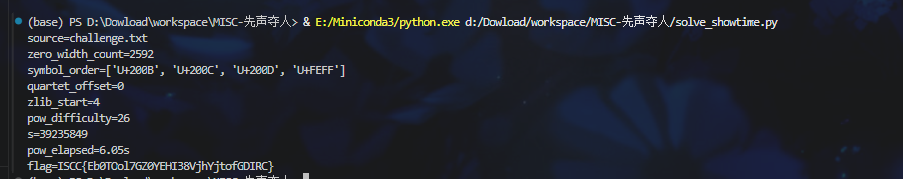
ISCC{Eb0TOol7GZ0YEHI38VjhYjtofGDIRC}
Exp
import argparse
import hashlib
import itertools
import json
import multiprocessing as mp
import time
import zipfile
import zlib
from pathlib import Path

from cryptography.hazmat.primitives.ciphers import Cipher, algorithms, modes


ZERO_WIDTH_CHARS = ("\u200b", "\u200c", "\u200d", "\ufeff")
REQUIRED_KEYS = {"aes", "difficulty_bits", "encrypted_flag", "key_derivation", "nonce", "pow", "s_format"}
SCAN_SLICE = 300_000


def load_text(path: Path) -> tuple[str, str]:
    if zipfile.is_zipfile(path):
        with zipfile.ZipFile(path) as archive:
            names = [name for name in archive.namelist() if not name.endswith("/")]
            if not names:
                raise ValueError("zip archive is empty")
            return archive.read(names[0]).decode("utf-8"), names[0]
    return path.read_text(encoding="utf-8"), path.name


def collect_zero_width(text: str) -> list[str]:
    return [ch for ch in text if ch in ZERO_WIDTH_CHARS]


def pack_symbols(symbols: list[str], order: tuple[str, ...], offset: int, little_endian: bool) -> bytes:
    table = {ch: idx for idx, ch in enumerate(order)}
    values = [table[ch] for ch in symbols[offset:]]
    output = bytearray()
    for index in range(0, len(values) - 3, 4):
        a, b, c, d = values[index:index + 4]
        if little_endian:
            byte = a | (b << 2) | (c << 4) | (d << 6)
        else:
            byte = (a << 6) | (b << 4) | (c << 2) | d
        output.append(byte)
    return bytes(output)


def recover_payload(symbols: list[str]) -> tuple[dict, dict]:
    for order in itertools.permutations(ZERO_WIDTH_CHARS):
        for offset in range(4):
            for little_endian in (False, True):
                blob = pack_symbols(symbols, order, offset, little_endian)
                for start in range(min(32, len(blob))):
                    try:
                        plain = zlib.decompress(blob[start:])
                    except zlib.error:
                        continue
                    try:
                        payload = json.loads(plain.decode("utf-8"))
                    except (UnicodeDecodeError, json.JSONDecodeError):
                        continue
                    if REQUIRED_KEYS.issubset(payload):
                        metadata = {
                            "order": [f"U+{ord(ch):04X}" for ch in order],
                            "offset": offset,
                            "zlib_start": start,
                            "little_endian": little_endian,
                            "zero_width_count": len(symbols),
                        }
                        return payload, metadata
    raise ValueError("unable to decode the zero-width payload")


def digest_matches(digest: bytes, difficulty_bits: int) -> bool:
    full_bytes, remaining_bits = divmod(difficulty_bits, 8)
    if digest[:full_bytes] != b"\x00" * full_bytes:
        return False
    if remaining_bits == 0:
        return True
    return (digest[full_bytes] >> (8 - remaining_bits)) == 0


def scan_pow_range(args: tuple[bytes, int, int]) -> int | None:
    nonce, difficulty_bits, start = args
    end = start + SCAN_SLICE
    for candidate in range(start, end):
        digest = hashlib.sha256(nonce + str(candidate).encode()).digest()
        if digest_matches(digest, difficulty_bits):
            return candidate
    return None


def solve_pow(nonce: str, difficulty_bits: int, workers: int) -> tuple[int, float]:
    encoded_nonce = nonce.encode()
    started_at = time.time()
    base = 0

    with mp.Pool(processes=workers) as pool:
        while True:
            jobs = [(encoded_nonce, difficulty_bits, base + worker * SCAN_SLICE) for worker in range(workers)]
            answers = pool.map(scan_pow_range, jobs)
            matches = [answer for answer in answers if answer is not None]
            if matches:
                return min(matches), time.time() - started_at
            base += workers * SCAN_SLICE


def pkcs7_unpad(data: bytes) -> bytes:
    pad_len = data[-1]
    if pad_len == 0 or pad_len > 16 or data[-pad_len:] != bytes([pad_len]) * pad_len:
        raise ValueError("invalid PKCS7 padding")
    return data[:-pad_len]


def decrypt_flag(payload: dict, pow_answer: int) -> str:
    derivation = payload["key_derivation"]
    aes_key = hashlib.pbkdf2_hmac(
        "sha256",
        str(pow_answer).encode(),
        payload["nonce"].encode(),
        derivation["iterations"],
        dklen=derivation["dklen"],
    )
    iv = bytes.fromhex(payload["encrypted_flag"]["iv"])
    ciphertext = bytes.fromhex(payload["encrypted_flag"]["ciphertext"])
    cipher = Cipher(algorithms.AES(aes_key), modes.CBC(iv))
    decryptor = cipher.decryptor()
    plaintext = decryptor.update(ciphertext) + decryptor.finalize()
    return pkcs7_unpad(plaintext).decode("utf-8")


def main() -> None:
    parser = argparse.ArgumentParser(description="Solve the showtime_01 challenge")
    parser.add_argument("input", nargs="?", default="showtime_01.zip", help="Path to the zip or extracted challenge file")
    parser.add_argument("--workers", type=int, default=max(1, (mp.cpu_count() or 1) - 1), help="Worker process count for PoW search")
    args = parser.parse_args()

    input_path = Path(args.input)
    text, source_name = load_text(input_path)
    zero_width_symbols = collect_zero_width(text)
    payload, metadata = recover_payload(zero_width_symbols)
    pow_answer, elapsed = solve_pow(payload["nonce"], payload["difficulty_bits"], args.workers)
    flag = decrypt_flag(payload, pow_answer)

    print(f"source={source_name}")
    print(f"zero_width_count={metadata['zero_width_count']}")
    print(f"symbol_order={metadata['order']}")
    print(f"quartet_offset={metadata['offset']}")
    print(f"zlib_start={metadata['zlib_start']}")
    print(f"pow_difficulty={payload['difficulty_bits']}")
    print(f"s={pow_answer}")
    print(f"pow_elapsed={elapsed:.2f}s")
    print(f"flag={flag}")


if __name__ == "__main__":
    mp.freeze_support()
    main()

 浙公网安备 33010602011771号