
MISC-神秘文件Plus
ISCC2026 WriteUp 提交模板
MISC-神秘文件Plus
解题思路
面里的几个词很关键:
神秘文件节奏波动三要素声音的第九位
如果把这些提示拆开看,基本能得到下面这条思路:
- 先把它当成文件隐写题,不要急着只盯图片表面。
- 中后段重点会落到音频,而不是单纯“听声音”。
声音的第九位很像在提示 16-bit PCM 的位平面,也就是从低位开始数的bit8。节奏和波动说明音频里不一定只有一个信息层,可能既有提示层,也有真正的数据层。
也就是说,这题不是单点突破,而是“外层文件 -> 图片 -> 压缩包 -> 音频 -> 差异载荷”的链式结构。
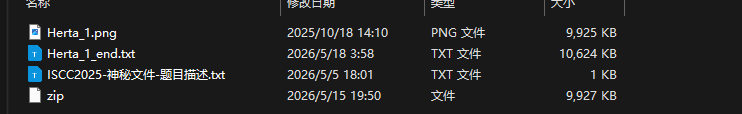
使用随波逐流发现并提取图片尾部。
确定了一下发现是7z。
from pathlib import Path

blob = Path("Herta_1.png").read_bytes()
png_end = blob.find(b"IEND") + 8
tail = blob[png_end:]
Path("tail.7z").write_bytes(tail)
使用脚本提取下

发现7z有口令
回头看 PNG 自身。因为题目已经给了“三要素”的暗示,最自然的入手点就是 RGB 通道
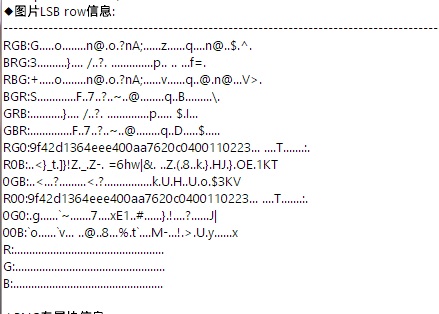
得到的密码是:
9f42d1364eee400aa7620c0400110223
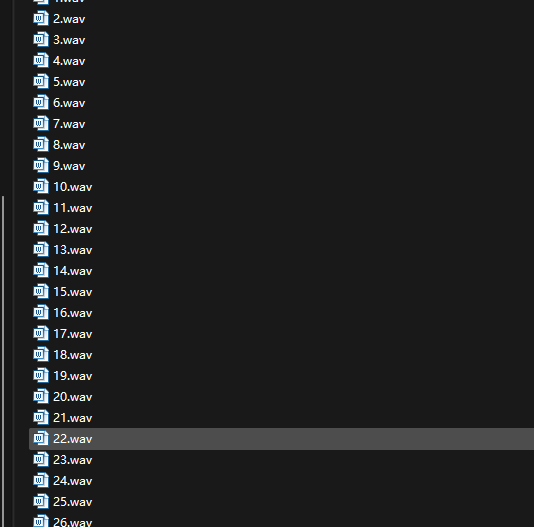
发现是音频.
做一次音频扫描:
from pathlib import Path
import wave

audio_paths = sorted(
    Path("f1ag_01").glob("*.wav"),
    key=lambda audio_path: int(audio_path.stem),
)

for audio_path in audio_paths:
    with wave.open(str(audio_path), "rb") as wav_file:
        params = wav_file.getparams()
        duration = params.nframes / params.framerate

        print(
            f"{audio_path.name}: "
            f"channels={params.nchannels}, "
            f"sample_width={params.sampwidth}, "
            f"sample_rate={params.framerate}, "
            f"frames={params.nframes}, "
            f"duration={duration:.3f}s, "
            f"comp={params.comptype}"
        )
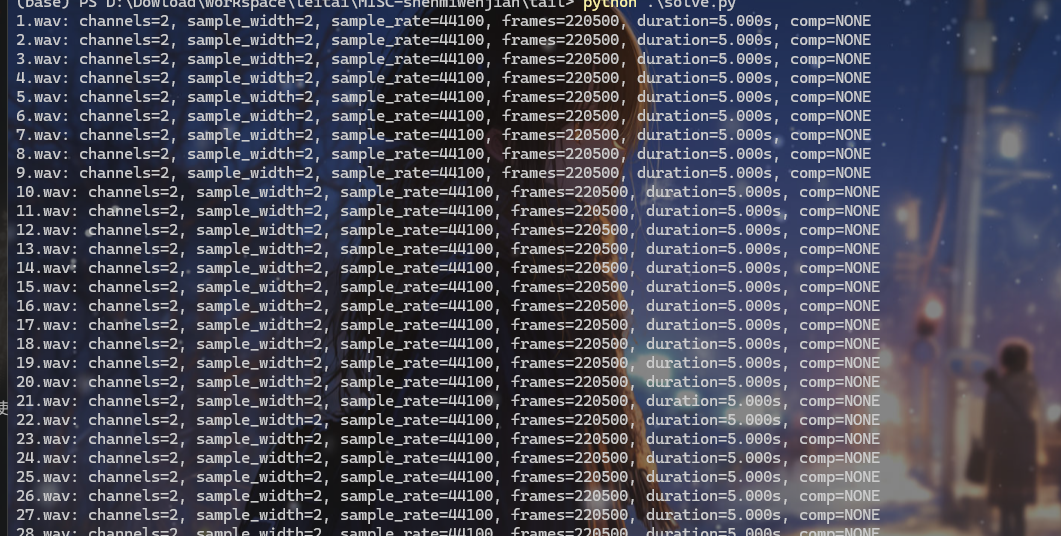
能确认出这些 wav 的共性:
- 采样率都是
44100Hz - 采样宽度是
2字节 - 也就是
16-bit PCM - 声道数是
2
这就把题目里的“第九位”解释清楚了:
16-bit PCM 从低位开始数:
bit0 是第 1 位
bit8 是第 9 位
不过这里要注意一个坑:
- 题目提示了位平面,不等于“把所有 wav 的第九位直接顺手一提就完事”
- 真正有用的位信息,往往还要和位置、节奏、声道差异一起看
把 wav 以 0.1s 为一块切开,再按振幅阈值判断“这一小段有没有声”,能看到非常规律的节奏模式。
举例来说:
1111111111000000000000000011111111000000
这些模式说明题目确实在利用音频的节奏结构传信息,但这层更像“告诉你这里有设计”,而不是直接把 flag 平铺给你。
同理,9.wav 可以读出 IV/CRX 一类提示,1.wav 和 2.wav 也能提取出提示性字符串。它们对理解题目有帮助,但都不是最后真正落地的载荷。
前面所有 wav 都是双声道,所以最值得做的一件事,是看左声道和右声道是否完全一致:
import glob
import os
import wave
import numpy as np

files = sorted(
    glob.glob("f1ag_01/*.wav"),
    key=lambda x: int(os.path.basename(x).split(".")[0]),
)

for f in files:
    with wave.open(f, "rb") as w:
        data = np.frombuffer(w.readframes(w.getnframes()), dtype="<i2")
        data = data.reshape(-1, 2)

    diff_count = np.count_nonzero(data[:, 0] != data[:, 1])
    if diff_count:
        print(os.path.basename(f), diff_count)
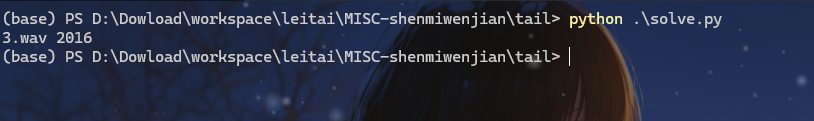
结论非常干净:
只有 3.wav 有差异
差异采样数是 2016
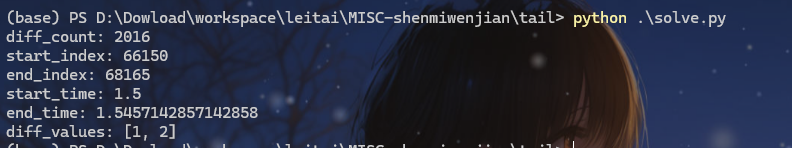
from pathlib import Path
import wave

import numpy as np

audio_path = Path("f1ag_01/3.wav")

with wave.open(str(audio_path), "rb") as wav_file:
    sample_rate = wav_file.getframerate()
    frame_count = wav_file.getnframes()
    stereo_samples = np.frombuffer(
        wav_file.readframes(frame_count),
        dtype="<i2",
    ).reshape(-1, 2)

left_channel = stereo_samples[:, 0]
right_channel = stereo_samples[:, 1]
channel_diff = left_channel - right_channel
diff_indices = np.flatnonzero(channel_diff)

start_index = diff_indices[0]
end_index = diff_indices[-1]
diff_values = sorted(set(channel_diff[diff_indices]))

print(f"diff_count: {len(diff_indices)}")
print(f"start_index: {start_index}")
print(f"end_index: {end_index}")
print(f"start_time: {start_index / sample_rate}")
print(f"end_time: {(end_index + 1) / sample_rate}")
print(f"diff_values: {diff_values}")
66150 = 44100 × 1.5
2016 = 42 × 48
第一条说明载荷从 3.wav 的 1.5s 位置开始。
第二条说明这段数据长度和最终 42 字符的 flag 有明显结构关系。
因为差值只有 1 和 2 两种情况,所以最自然的映射就是:
left - right = 1 -> 0left - right = 2 -> 1
代码如下:
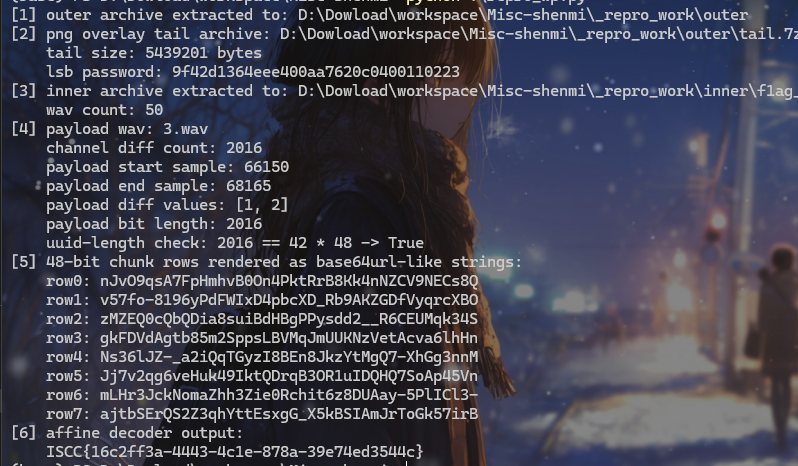
Exp
from __future__ import annotations

import argparse
import locale
import shutil
import subprocess
import wave
from pathlib import Path

import numpy as np
from PIL import Image


ROOT = Path(r"D:\Dowload\workspace\Misc-shenmi")
OUTER_ARCHIVE = ROOT / "zip"
WORKDIR = ROOT / "_repro_work"
OUTER_DIR = WORKDIR / "outer"
INNER_DIR = WORKDIR / "inner"
TAIL_ARCHIVE = OUTER_DIR / "tail.7z"
BASE64URL = "ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz0123456789-_"
AFFINE_ASCII_MASKS = (
    0x000000000000,
    0x0EDDA24F04A0,
    0xF6F336F10E20,
    0x0428CF58C0E0,
    0xDC475F6FD280,
    0x46E1B29342C0,
    0x0F3A3EF9A020,
    0x2BC8F4F210A0,
)


def run(cmd: list[str]) -> None:
    completed = subprocess.run(cmd, capture_output=True)
    if completed.returncode != 0:
        encoding = locale.getpreferredencoding(False) or "utf-8"
        stdout = completed.stdout.decode(encoding, errors="replace")
        stderr = completed.stderr.decode(encoding, errors="replace")
        raise RuntimeError(
            f"command failed: {' '.join(cmd)}\nstdout:\n{stdout}\nstderr:\n{stderr}"
        )


def reset_workdir() -> None:
    if WORKDIR.exists():
        shutil.rmtree(WORKDIR)
    OUTER_DIR.mkdir(parents=True, exist_ok=True)
    INNER_DIR.mkdir(parents=True, exist_ok=True)


def extract_outer() -> tuple[Path, Path]:
    run(["7z", "x", "-y", f"-o{OUTER_DIR}", str(OUTER_ARCHIVE)])
    png_path = OUTER_DIR / "Herta_1.png"
    desc_path = OUTER_DIR / "ISCC2025-神秘文件-题目描述.txt"
    if not png_path.exists():
        raise FileNotFoundError(png_path)
    return png_path, desc_path


def extract_tail_and_password(png_path: Path) -> tuple[Path, str]:
    data = png_path.read_bytes()
    iend = data.find(b"IEND")
    if iend < 0:
        raise ValueError("PNG IEND not found")
    png_end = iend + 8
    tail = data[png_end:]
    TAIL_ARCHIVE.write_bytes(tail)

    img = Image.open(png_path).convert("RGB")
    bits = [r & 1 for r, _, _ in img.getdata()]
    password_bytes = bytearray()
    for index in range(0, len(bits) - 7, 8):
        byte = 0
        for bit in bits[index : index + 8]:
            byte = (byte << 1) | bit
        password_bytes.append(byte)
    password = password_bytes[:32].decode("ascii")
    return TAIL_ARCHIVE, password


def extract_inner(tail_archive: Path, password: str) -> Path:
    run(["7z", "x", "-y", f"-p{password}", f"-o{INNER_DIR}", str(tail_archive)])
    wav_dir = INNER_DIR / "f1ag_01"
    if not wav_dir.exists():
        raise FileNotFoundError(wav_dir)
    return wav_dir


def sorted_wavs(wav_dir: Path) -> list[Path]:
    return sorted(wav_dir.glob("*.wav"), key=lambda path: int(path.stem))


def load_stereo_pcm(path: Path) -> tuple[int, np.ndarray]:
    with wave.open(str(path), "rb") as wav:
        sample_rate = wav.getframerate()
        data = np.frombuffer(wav.readframes(wav.getnframes()), dtype="<i2").reshape(-1, 2)
    return sample_rate, data


def find_payload_wav(wav_paths: list[Path]) -> tuple[Path, int]:
    for path in wav_paths:
        _, data = load_stereo_pcm(path)
        diff_count = int(np.count_nonzero(data[:, 0] != data[:, 1]))
        if diff_count:
            return path, diff_count
    raise RuntimeError("no wav with channel differences found")


def extract_payload_bits(payload_wav: Path) -> tuple[int, int, list[int], str]:
    sample_rate, data = load_stereo_pcm(payload_wav)
    diff = data[:, 0].astype(np.int32) - data[:, 1].astype(np.int32)
    indices = np.flatnonzero(diff)
    unique = sorted(set(diff[indices].tolist()))
    bits = "".join("0" if value == 1 else "1" if value == 2 else "?" for value in diff[indices])
    if "?" in bits:
        raise ValueError(f"unexpected diff values: {unique}")
    return int(indices[0]), int(indices[-1]), unique, bits


def chunk_rows_from_bits(bits: str) -> list[str]:
    blocks = [bytes(int(bits[index + offset : index + offset + 8], 2) for offset in range(0, 48, 8)) for index in range(0, len(bits), 48)]
    rows: list[str] = []
    for row in range(8):
        values = []
        for block in blocks:
            value = 0
            for byte in block:
                value = (value << 1) | ((byte >> (7 - row)) & 1)
            values.append(value)
        rows.append("".join(BASE64URL[value] for value in values))
    return rows


def decode_affine_ascii(bits: str) -> str:
    if len(bits) % 48 != 0:
        raise ValueError(f"payload bit length must be a multiple of 48, got {len(bits)}")

    decoded_chars: list[str] = []
    for index in range(0, len(bits), 48):
        block_bits = bits[index : index + 48]
        block_value = int(block_bits, 2)

        char_value = 0
        for mask in AFFINE_ASCII_MASKS:
            bit = (block_value & mask).bit_count() & 1
            char_value = (char_value << 1) | bit

        decoded_chars.append(chr(char_value))

    return "".join(decoded_chars)


def main() -> None:
    parser = argparse.ArgumentParser(description="Reproduce the bundled WP extraction chain for Misc-shenmi.")
    parser.add_argument("--keep", action="store_true", help="keep existing _repro_work instead of recreating it")
    args = parser.parse_args()

    if not args.keep:
        reset_workdir()
    else:
        OUTER_DIR.mkdir(parents=True, exist_ok=True)
        INNER_DIR.mkdir(parents=True, exist_ok=True)

    png_path, _ = extract_outer()
    tail_path, password = extract_tail_and_password(png_path)
    wav_dir = extract_inner(tail_path, password)
    wav_paths = sorted_wavs(wav_dir)
    payload_wav, diff_count = find_payload_wav(wav_paths)
    start_sample, end_sample, diff_values, payload_bits = extract_payload_bits(payload_wav)
    payload_rows = chunk_rows_from_bits(payload_bits)
    decoded_flag = decode_affine_ascii(payload_bits)

    print(f"[1] outer archive extracted to: {OUTER_DIR}")
    print(f"[2] png overlay tail archive: {tail_path}")
    print(f"    tail size: {tail_path.stat().st_size} bytes")
    print(f"    lsb password: {password}")
    print(f"[3] inner archive extracted to: {wav_dir}")
    print(f"    wav count: {len(wav_paths)}")
    print(f"[4] payload wav: {payload_wav.name}")
    print(f"    channel diff count: {diff_count}")
    print(f"    payload start sample: {start_sample}")
    print(f"    payload end sample: {end_sample}")
    print(f"    payload diff values: {diff_values}")
    print(f"    payload bit length: {len(payload_bits)}")
    print(f"    48-bit block count: {len(payload_bits) // 48}")
    print(f"    block-aligned: {len(payload_bits) % 48 == 0}")
    print("[5] 48-bit chunk rows rendered as base64url-like strings:")
    for row_index, row_text in enumerate(payload_rows):
        print(f"    row{row_index}: {row_text}")
    print("[6] affine decoder output:")
    print(f"    {decoded_flag}")


if __name__ == "__main__":
    main()

 浙公网安备 33010602011771号