
MISC-盲相阵列
ISCC2026 WriteUp 提交模板
MISC-盲相阵列
解题思路
1.查看文件
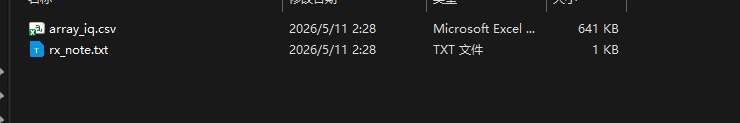
解压后,有两个文件。
先看一下note文件:
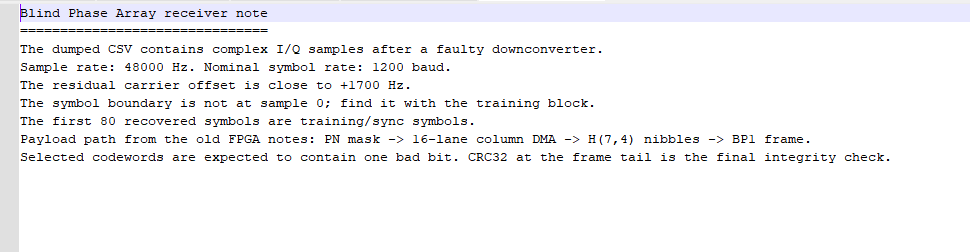
note 给出采样率 48000 Hz、符号率 1200 baud、残余载波约 +1700 Hz,因此每个符号对应 48000 / 1200 = 40 个采样点。它还说明符号边界不在 sample 0,需要用训练块找边界;前 80 个恢复符号是 training/sync。
根据这些信息,先对第 n 个采样乘上 exp(-j*2*pi*1700*n/48000) 做残余载波补偿。BPSK 仍然存在整体相位和正负不确定,所以对抽样后的复符号求 sum(symbol^2),取它相位的一半作为整体相位估计,再做判决。
2.使用训练快确定边界和seed
已知每符号 40 个采样,因此符号边界只需要枚举 0..39。对每个候选边界做载波补偿、相位校正和硬判决后,观察前 80 个 training/sync 符号;
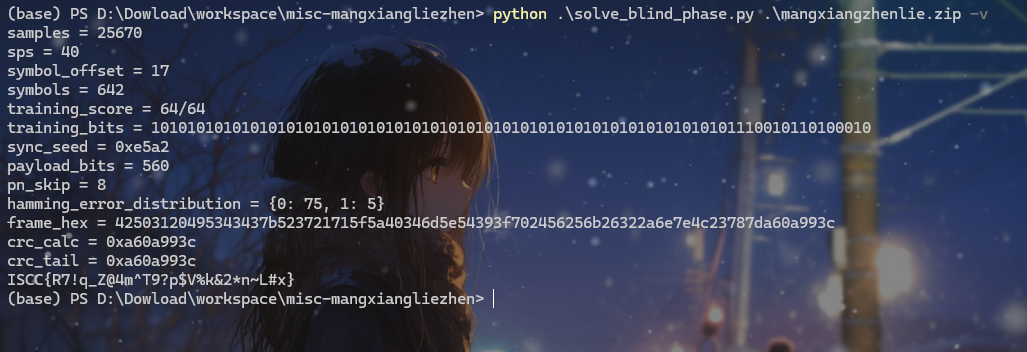
其中通过后续 BP1/CRC 校验的候选是 offset 17。它的前 64 bit 是完整交替训练序列,后 16 bit 是同步 seed:
1010101010101010101010101010101010101010101010101010101010101010 1110010110100010
因此 PN 的初始 seed 为 0xe5a2。
3.逆向还原
已知 note 给出的 payload 路径是 PN mask -> 16-lane column DMA -> H(7,4) nibbles -> BP1 frame,所以解码时按相反顺序处理。
训练块之后的 payload 先按 16 * 7 的结构截断,本题可用 560 bit。PN 使用 16 bit 右移 LFSR,反馈 tap 为 0x1d00;
由于 PN 流起点和 payload 起点之间还有偏移,脚本枚举 pn_skip,再用 BP1 帧头和 CRC32 做唯一校验,本题得到 pn_skip = 8。
去 PN 后需要撤销 16 路 column DMA。设 rows = len(bits) / 16,接收顺序是按列堆放,恢复顺序就是:
out[row * 16 + lane] = bits[lane * rows + row]
之后每 7 bit 作为一个 Hamming(7,4) 码字解一个 nibble。码字布局为 [p1, p2, d1, p4, d2, d3, d4],校验关系是:
p1 = d1 ^ d2 ^ d4
p2 = d1 ^ d3 ^ d4
p4 = d2 ^ d3 ^ d4
解出的 80 个码字中,75 个无需纠错,5 个有 1 bit 错误,和 note 里“部分码字会有一位错误”的描述一致。
4.CRC确认
Hamming 解码后得到的帧以 BP1 开头,后面是正文和 4 字节大端 CRC32:
BP1 ISCC{R7!q_Z@4m^T9?p$V%k&2*n~L#x}\xa6\x0a\x99\x3c
对 BP1 之后、CRC 之前的正文计算 CRC32,得到 0xa60a993c,与帧尾 a6 0a 99 3c 一致,因此正文就是最终 flag。
ISCC{R7!q_Z@4m^T9?p$V%k&2*n~L#x}
Exp
import argparse
import csv
import io
import math
import os
import re
import sys
import zipfile
import zlib


def read_bundle(path):
    note_text = ""
    csv_text = ""
    if zipfile.is_zipfile(path):
        with zipfile.ZipFile(path) as zf:
            names = zf.namelist()
            note_name = next((n for n in names if n.replace("\\", "/").endswith("rx_note.txt")), None)
            csv_name = next((n for n in names if n.replace("\\", "/").endswith("array_iq.csv")), None)
            if note_name is None or csv_name is None:
                raise ValueError("missing rx_note.txt or array_iq.csv in archive")
            note_text = zf.read(note_name).decode("utf-8", errors="replace")
            csv_text = zf.read(csv_name).decode("utf-8", errors="replace")
    elif os.path.isdir(path):
        note_path = None
        csv_path = None
        for root, _, files in os.walk(path):
            for name in files:
                full = os.path.join(root, name)
                if name == "rx_note.txt":
                    note_path = full
                elif name == "array_iq.csv":
                    csv_path = full
        if note_path is None or csv_path is None:
            raise ValueError("missing rx_note.txt or array_iq.csv in directory")
        with open(note_path, "r", encoding="utf-8", errors="replace") as f:
            note_text = f.read()
        with open(csv_path, "r", encoding="utf-8", errors="replace") as f:
            csv_text = f.read()
    else:
        raise ValueError("input must be the challenge zip or extracted bundle directory")
    return note_text, csv_text


def parse_note(note_text):
    def grab(pattern, default=None, cast=float):
        m = re.search(pattern, note_text, re.I)
        if not m:
            if default is None:
                raise ValueError(f"missing parameter matching {pattern!r}")
            return default
        return cast(m.group(1))

    sample_rate = grab(r"Sample\s+rate:\s*([0-9.]+)", cast=float)
    symbol_rate = grab(r"symbol\s+rate:\s*([0-9.]+)", cast=float)
    carrier = grab(r"offset\s+is\s+close\s+to\s*([+-]?[0-9.]+)", cast=float)
    training = grab(r"first\s+([0-9]+)\s+recovered\s+symbols", default=80, cast=int)
    lanes = grab(r"([0-9]+)\s*-\s*lane\s+column\s+DMA", default=16, cast=int)
    return sample_rate, symbol_rate, carrier, training, lanes


def read_iq(csv_text):
    samples = []
    for row in csv.DictReader(io.StringIO(csv_text)):
        samples.append(complex(float(row["i"]), float(row["q"])))
    if not samples:
        raise ValueError("empty I/Q CSV")
    return samples


def lfsr_mask(seed, count):
    state = seed & 0xFFFF
    poly = 0x1D00
    out = []
    for _ in range(count):
        out_bit = state & 1
        feedback = (state & poly).bit_count() & 1
        state = (state >> 1) | (feedback << 15)
        out.append(out_bit)
    return out


def hamming_codewords():
    table = []
    for n in range(16):
        d1 = (n >> 3) & 1
        d2 = (n >> 2) & 1
        d3 = (n >> 1) & 1
        d4 = n & 1
        p1 = d1 ^ d2 ^ d4
        p2 = d1 ^ d3 ^ d4
        p4 = d2 ^ d3 ^ d4
        table.append([p1, p2, d1, p4, d2, d3, d4])
    return table


def hamming_decode(bits):
    words = hamming_codewords()
    nibbles = []
    distances = []

    for i in range(0, len(bits), 7):
        word = bits[i:i + 7]
        if len(word) < 7:
            break
        best_dist = 8
        best_nibble = 0
        for nibble, codeword in enumerate(words):
            dist = sum(a != b for a, b in zip(word, codeword))
            if dist < best_dist:
                best_dist = dist
                best_nibble = nibble
        nibbles.append(best_nibble)
        distances.append(best_dist)

    data = bytearray()
    for i in range(0, len(nibbles) - 1, 2):
        data.append((nibbles[i] << 4) | nibbles[i + 1])
    return bytes(data), distances


def undo_column_dma(bits, lanes):
    rows = len(bits) // lanes
    out = []
    for row in range(rows):
        for lane in range(lanes):
            out.append(bits[lane * rows + row])
    return out


def try_decode_payload(bits, training, lanes):
    if len(bits) <= training + lanes * 7:
        return None

    sync_bits = bits[64:training]
    if len(sync_bits) != 16:
        return None
    seed = int("".join(str(b) for b in sync_bits), 2)

    payload = bits[training:]
    block = lanes * 7
    usable = (len(payload) // block) * block
    payload = payload[:usable]
    if not payload:
        return None

    max_skip = 256
    mask = lfsr_mask(seed, usable + max_skip)
    for skip in range(max_skip):
        unmasked = [payload[i] ^ mask[i + skip] for i in range(usable)]
        ordered = undo_column_dma(unmasked, lanes)
        frame, distances = hamming_decode(ordered)
        if len(frame) < 8 or not frame.startswith(b"BP1 "):
            continue

        body = frame[4:-4]
        crc_tail = int.from_bytes(frame[-4:], "big")
        crc_calc = zlib.crc32(body) & 0xFFFFFFFF
        if crc_calc != crc_tail:
            continue

        text = body.decode("ascii", errors="strict")
        if not re.fullmatch(r"[A-Za-z0-9_]+\{[^\r\n{}]+\}", text):
            continue

        hist = {}
        for dist in distances:
            hist[dist] = hist.get(dist, 0) + 1
        return {
            "flag": text,
            "seed": seed,
            "pn_skip": skip,
            "payload_bits": usable,
            "frame": frame,
            "crc_tail": crc_tail,
            "crc_calc": crc_calc,
            "hamming_errors": hist,
        }

    return None


def demodulate(samples, sample_rate, symbol_rate, carrier, training, lanes):
    sps = int(round(sample_rate / symbol_rate))
    alt10 = [1 if i % 2 == 0 else 0 for i in range(64)]
    alt01 = [1 - b for b in alt10]
    two_pi = 2.0 * math.pi

    for offset in range(sps):
        symbols = []
        for idx in range(offset, len(samples), sps):
            angle = -two_pi * carrier * idx / sample_rate
            symbols.append(samples[idx] * complex(math.cos(angle), math.sin(angle)))
        if len(symbols) <= training:
            continue

        # BPSK has a 180 degree ambiguity. Squaring removes the sign and reveals phase.
        phasor = sum(sym * sym for sym in symbols)
        phase = 0.5 * math.atan2(phasor.imag, phasor.real)
        rot = complex(math.cos(-phase), math.sin(-phase))
        bits = [1 if (sym * rot).real < 0 else 0 for sym in symbols]

        score10 = sum(bits[i] == alt10[i] for i in range(64))
        score01 = sum(bits[i] == alt01[i] for i in range(64))
        if score01 > score10:
            bits = [1 - bit for bit in bits]
            score10 = score01
        if score10 < 60:
            continue

        result = try_decode_payload(bits, training, lanes)
        if result is not None:
            result["sps"] = sps
            result["offset"] = offset
            result["symbols"] = len(symbols)
            result["training_score"] = score10
            result["training_bits"] = "".join(str(bit) for bit in bits[:training])
            return result

    raise ValueError("flag not recovered")


def main():
    parser = argparse.ArgumentParser(description="Solve Blind Phase Array from the original zip or extracted bundle.")
    parser.add_argument("input", help="mangxiangzhenlie.zip or extracted bundle directory")
    parser.add_argument("-v", "--verbose", action="store_true", help="print reproduction details")
    args = parser.parse_args()

    note_text, csv_text = read_bundle(args.input)
    sample_rate, symbol_rate, carrier, training, lanes = parse_note(note_text)
    samples = read_iq(csv_text)
    result = demodulate(samples, sample_rate, symbol_rate, carrier, training, lanes)

    if args.verbose:
        print(f"samples = {len(samples)}")
        print(f"sps = {result['sps']}")
        print(f"symbol_offset = {result['offset']}")
        print(f"symbols = {result['symbols']}")
        print(f"training_score = {result['training_score']}/64")
        print(f"training_bits = {result['training_bits']}")
        print(f"sync_seed = 0x{result['seed']:04x}")
        print(f"payload_bits = {result['payload_bits']}")
        print(f"pn_skip = {result['pn_skip']}")
        print(f"hamming_error_distribution = {result['hamming_errors']}")
        print(f"frame_hex = {result['frame'].hex()}")
        print(f"crc_calc = 0x{result['crc_calc']:08x}")
        print(f"crc_tail = 0x{result['crc_tail']:08x}")

    print(result["flag"])


if __name__ == "__main__":
    sys.exit(main())

 浙公网安备 33010602011771号