
软件工程第一次作业:从 API 调用到个人技术规划
| 这个作业属于哪个课程 | 软件工程(班级圈链接:请按课程实际信息填写) |
|---|---|
| 这个作业要求在哪里 | 第一次作业要求 |
| 这个作业的目标 | 完成 Hugging Face FLUX API 调用与前端交互、GitHub 个人主页建设,并通过 Markdown 博客完整记录技能自评、课程规划、实现过程、截图证据与学习总结 |
| 学号 | 292400336 |
软件工程第一次作业:从 API 调用到个人技术规划
这次作业主要包含三个部分:使用 Hugging Face API 调用 FLUX 文生图模型、建设 GitHub 个人主页,以及重新梳理自己的技术能力和未来学习计划。相比单纯完成一道编程题,这次更像一次“小型交付”:既要有能运行的代码,也要留下过程记录、截图和反思。
一、Hugging Face API 调用 FLUX 模型
1. 目标
本次选择的模型为:
XLabs-AI/flux-RealismLora
我的目标不是只在网页上点一次生成,而是通过 Hugging Face 的 API 在自己的程序中调用模型,并加一个简单前端,实现输入提示词后由后端请求模型、返回图片并在页面中展示。
2. API 准备过程
首先注册 Hugging Face 账号,然后进入账号设置中的 Access Tokens 页面创建 Token。Token 只放在后端的 .env 文件中,不直接写进前端代码,避免在浏览器里泄露。
项目使用 Node.js,主要依赖如下:
{
  "@huggingface/inference": "4.13.28",
  "dotenv": "16.6.1",
  "express": "5.1.0"
}
核心调用代码如下:
const client = new InferenceClient(process.env.HF_TOKEN);

const imageBlob = await client.textToImage({
  provider: 'fal-ai',
  model: 'XLabs-AI/flux-RealismLora',
  inputs: prompt,
  parameters: {
    width: 1024,
    height: 1024,
    num_inference_steps: 28,
    guidance_scale: 3.5,
    seed,
  },
});
后端拿到图片二进制后保存到 generated 目录,再把图片地址返回给前端。这样前端不需要知道 Hugging Face Token,也比较符合真实项目中“密钥放后端”的做法。
3. 前端交互
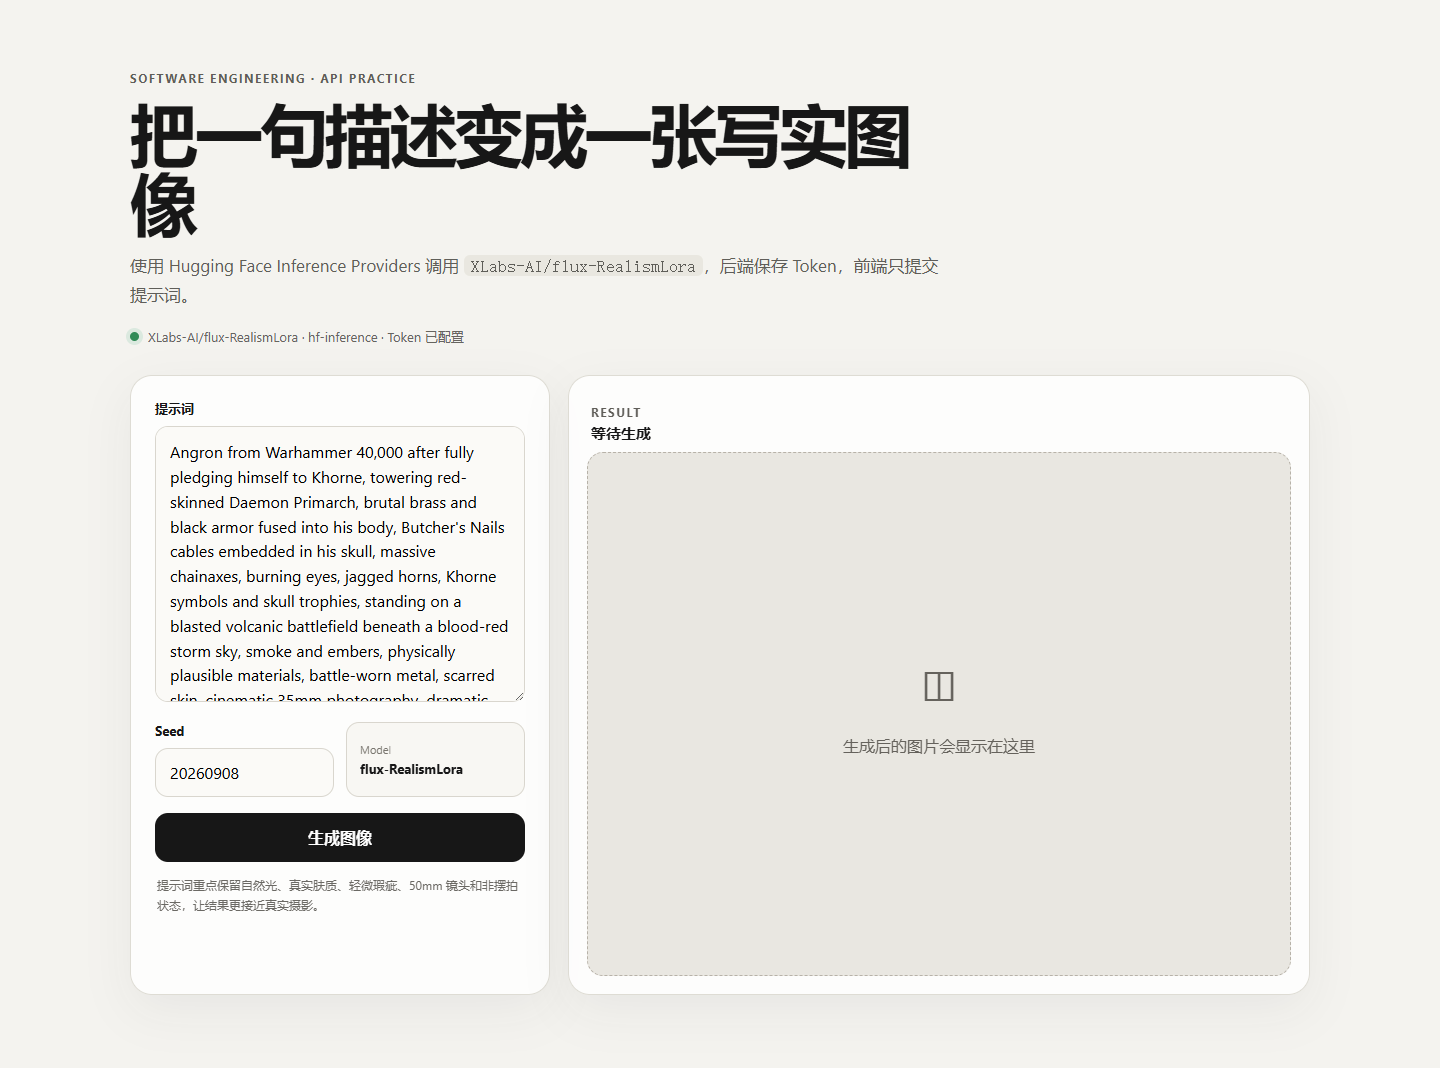
前端包含提示词输入框、Seed、模型信息、生成按钮和结果区域。点击“生成图像”后,浏览器向本地 /api/generate 接口发送 JSON,后端再调用 Hugging Face。
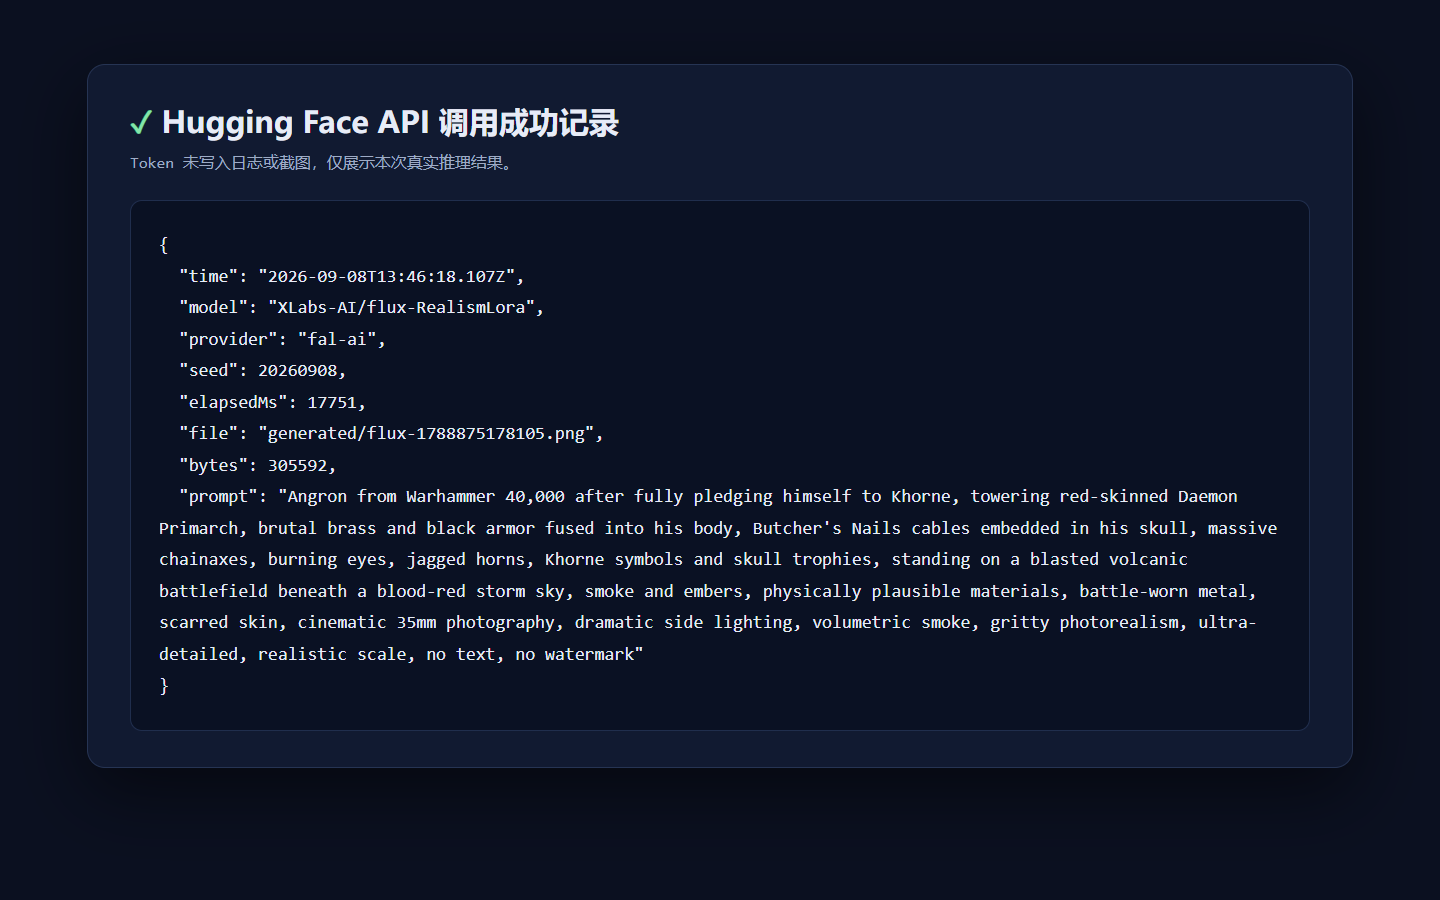
API 成功后,后端会记录本次模型、提示词、seed、耗时和生成文件名,便于保存调用成功的证据。
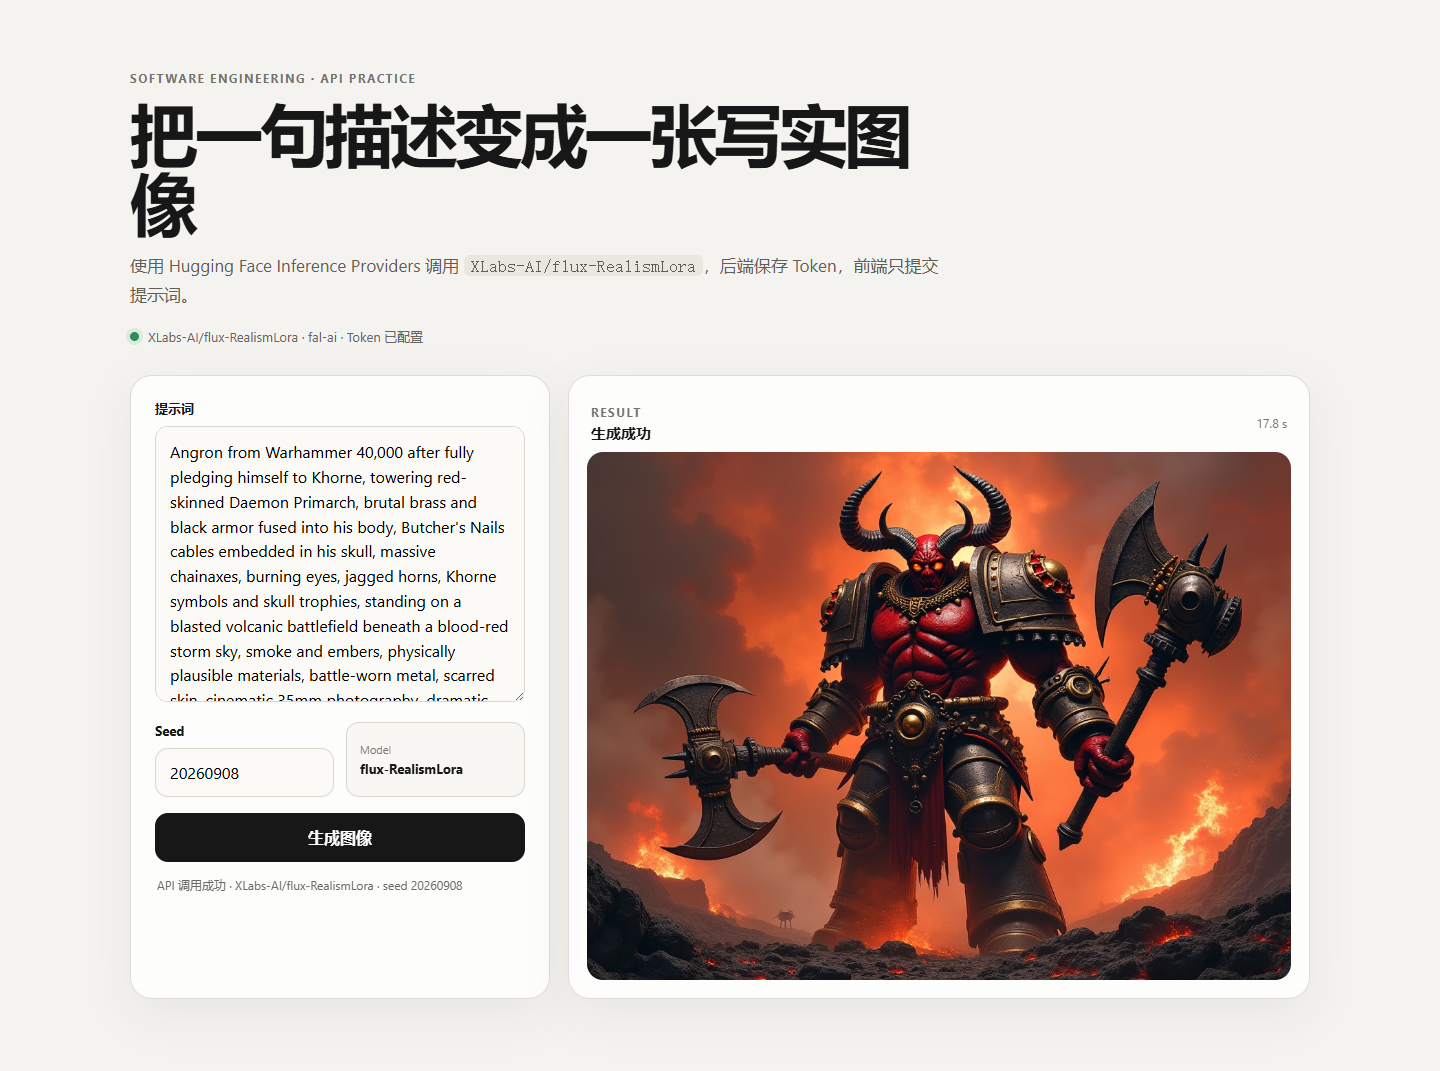
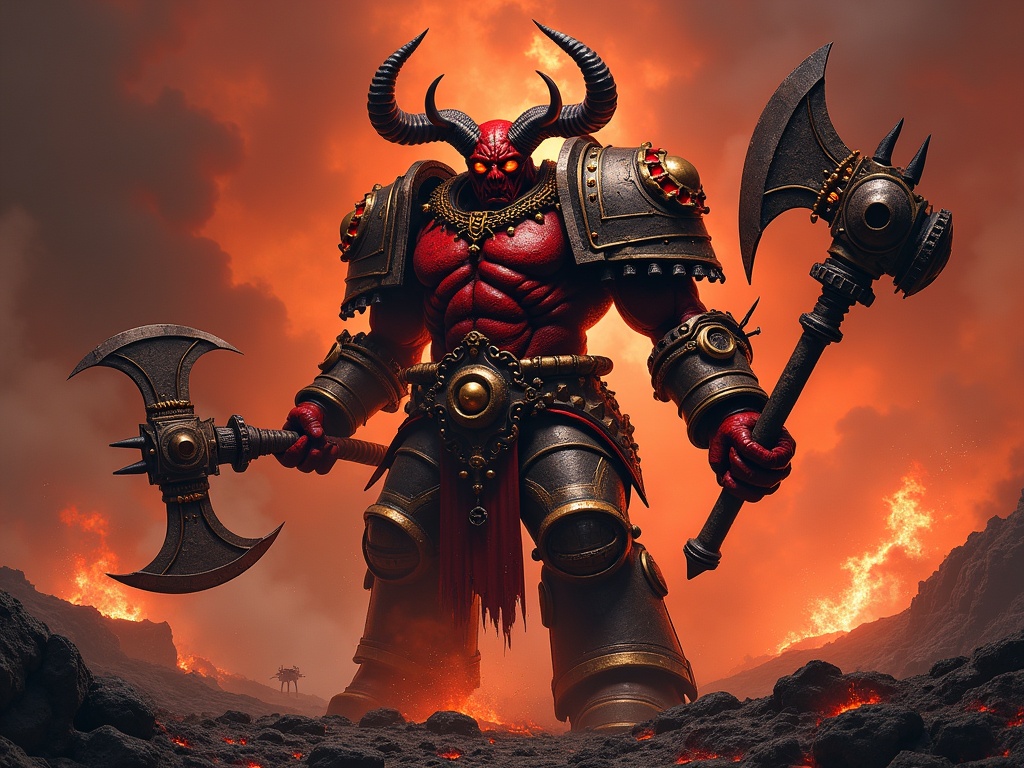
本次 API 链路已经通过 fal-ai 完成过一次真实成功验证:成功图主题为“投靠恐虐后的恶魔原体安格隆”,使用 seed 20260908,服务端推理耗时约 17.8 秒,生成 PNG 为 1024×768、约 298 KB。对应成功记录保存在 api-success.log 中,日志和截图均不包含 Token。随后我又尝试用一版更强调屠夫之钉、黄铜黑色装甲、链锯斧和恐虐战场氛围的安格隆提示词重新生成,但 Hugging Face 明确返回月度 Inference Providers 额度已耗尽;fal-ai、wavespeed 和 replicate 三个可用 Provider 都无法继续推理。因此最终保留前一次真实成功的安格隆结果作为 API 成功证据,不把额度失败页面伪装成新的成功结果。
4. 提示词设计和修改过程
最终我把提示词主题确定为“投靠恐虐后的安格隆”。一开始我写得比较简单:
Angron, realistic, on a battlefield.
这个版本虽然能表达人物和大概场景,但信息太少,很容易生成一个普通的红色恶魔战士,安格隆作为恶魔原体的辨识度不够,也不能明确表现他已经投靠恐虐后的状态。
第二版先补充角色本身的关键特征:
Angron from Warhammer 40,000 after fully pledging himself to Khorne,
towering red-skinned Daemon Primarch, brutal brass and black armor fused into his body,
Butcher's Nails cables embedded in his skull, massive chainaxes, burning eyes,
jagged horns, Khorne symbols and skull trophies.
这一版主要解决“是谁、处于什么状态”的问题。加入红色皮肤、屠夫之钉、黄铜与黑色装甲、链锯斧、角、恐虐符号和骷髅战利品后,角色特征比只写名字稳定得多。最后一版再补充环境和写实摄影语言:
Angron from Warhammer 40,000 after fully pledging himself to Khorne,
towering red-skinned Daemon Primarch, brutal brass and black armor fused into his body,
Butcher's Nails cables embedded in his skull, massive chainaxes, burning eyes, jagged horns,
Khorne symbols and skull trophies, standing on a blasted volcanic battlefield beneath a
blood-red storm sky, smoke and embers, physically plausible materials, battle-worn metal,
scarred skin, cinematic 35mm photography, dramatic side lighting, volumetric smoke,
gritty photorealism, ultra-detailed, realistic scale, no text, no watermark.
这次修改让我感觉,提示词并不是形容词越多越好,而是要先把“角色身份特征”写准确,再用材质、光线、烟尘和镜头语言强化写实感。相比单纯堆“8K、masterpiece”等词,屠夫之钉、黄铜黑色装甲、链锯斧、恐虐符号、伤痕皮肤和真实摄影光照更能提高安格隆的角色辨识度。实际重跑强化版本时账号月度 Inference Providers 额度已经耗尽,这也让我意识到第三方 AI API 除了代码正确性外,还必须考虑配额、计费和失败回退。
5. API 使用体验和心得
这次最大的收获是把“调用 AI”从一个网页操作变成了程序中的一个接口。真正写进项目后会遇到很多网页体验里看不到的问题,例如 Token 如何保存、请求失败怎么提示、生成结果怎么落盘、前后端怎么分工,以及如何留下可验证的日志。
另外,模型仓库只是模型本身,实际推理还会涉及 Inference Provider。以前我会把“模型”和“运行模型的服务”混在一起,这次对两者的区别更清楚了。
二、GitHub 个人主页建设
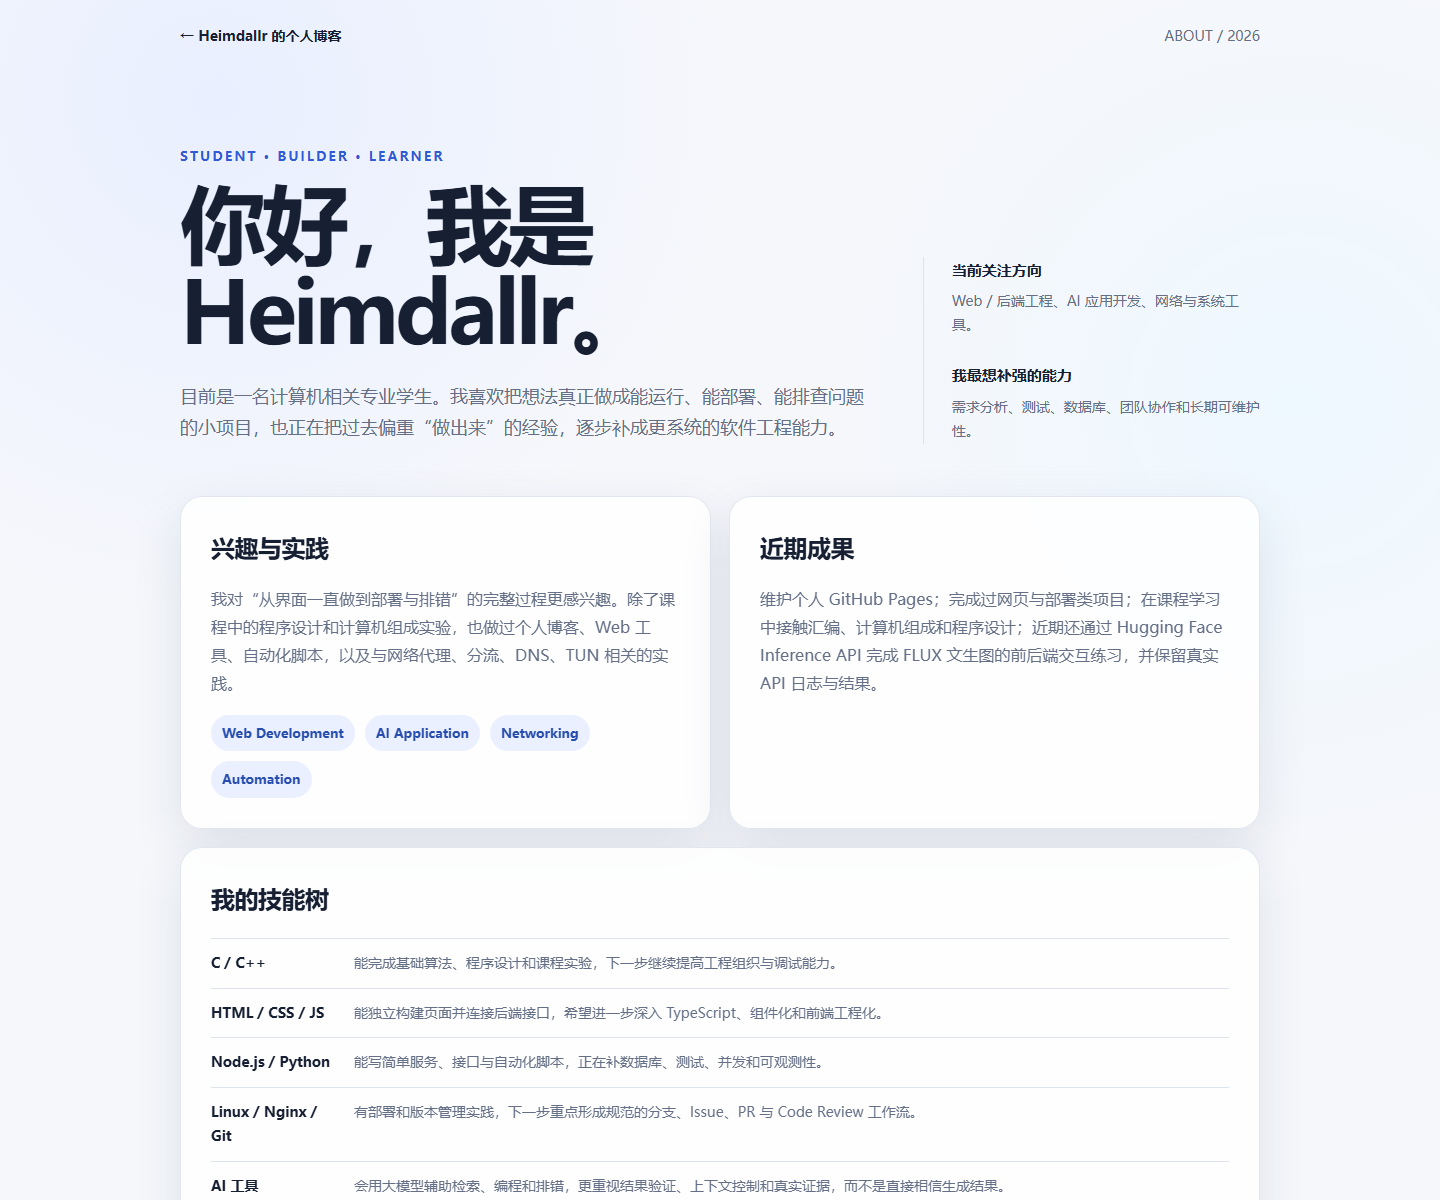
我的 GitHub ID 是 endlessmaybe。这次选择 GitHub Pages 方案,在原有个人站点 endlessmaybe.github.io 的基础上新增独立的个人介绍页面:
https://endlessmaybe.github.io/about/
页面直接发布在 endlessmaybe/endlessmaybe.github.io 仓库中。为了不破坏原有博客首页和历史文章,我只新增 about/index.html,没有修改旧页面。页面采用响应式布局,在桌面和手机上都可以正常阅读。
主页内容包括个人介绍、兴趣与实践经历、当前技术栈、近期成果、自我评估、最希望继续学习的方向,以及未来三年的学习与发展计划。
自我评估
我目前比较明显的特点是动手比较多。对于 Web、网络、部署或 AI 工具,我愿意先把东西跑起来,再通过日志和测试不断修正。这个过程让我积累了一些实践经验,但也暴露出自己的短板:过去容易关注“功能有没有实现”,对需求分析、自动化测试、代码规范、版本协作和长期维护考虑得还不够。
因此我希望后面的学习不只是继续增加“会用的工具数量”,而是把软件工程中比较系统的方法补起来。
三、当前技能树与技术偏好
1. 已具备的能力
能力 A:程序设计基础
- 能使用 C / C++ 完成基础程序和算法练习。
- 接触过汇编、寄存器、内存、指令执行等底层内容。
- 能阅读报错、使用调试工具定位常见问题。
能力 B:Web 与脚本开发
- 能使用 HTML / CSS / JavaScript 编写网页。
- 能使用 Node.js 或 Python 写简单接口与自动化脚本。
- 能把前端、接口和本地/服务器环境连接起来完成一个小型应用。
能力 C:部署和网络实践
- 接触过 Linux、Nginx、域名、反向代理等部署工作。
- 对代理、DNS、TUN、分流等网络技术有一定实践经验。
- 遇到网络问题时会通过请求、日志、端口和配置逐步排查。
能力 D:Git 与 AI 工具
- 能进行基本的 Git 提交、仓库托管和版本管理。
- 会使用 ChatGPT 等 AI 工具辅助检索、编程和排错。
- 已经意识到 AI 输出必须经过验证,不能把“生成了一段代码”直接等同于“问题已解决”。
2. 技术偏好
目前最感兴趣的是三个方向:
- Web / 后端工程:喜欢从页面一直做到接口、部署和问题排查。
- AI 应用开发:更关心如何把模型接进真实软件,而不只是聊天或单次生成。
- 网络与系统工具:对网络转发、代理、系统配置和性能问题比较有兴趣。
3. 目前欠缺的能力
- 数据结构和算法需要继续系统练习,而不是只在考试前集中复习。
- 数据库设计、并发、缓存等后端知识还不够深入。
- 自动化测试和测试设计经验不足。
- 团队开发中的 Issue、分支、PR、Code Review 流程还缺少真实项目锻炼。
- 写代码时有时会先追求“能跑”,后续需要更重视可读性、模块边界和维护成本。
四、目前代码量与本学期目标
我对自己 GitHub 上目前实际包含源代码的公开仓库做了一次统计,排除了 .git、node_modules、dist、build 等目录,目前可统计到的源代码约为:
22,982 行
其中主要是 HTML、JavaScript、CSS、Astro 和 TypeScript。这个数字并不能直接代表编程水平,因为模板文件和重复代码同样会增加行数,但至少可以作为一个阶段性的量化记录。
本学期结束时,我希望自己真正新增并认真维护的代码达到 30,000 行以上。相比单纯追求行数,我更希望新增代码中包含更多测试、文档、接口设计和重构记录,让“代码量增长”同时对应“工程能力增长”。
五、我最期待从软件工程课程中学到什么
我最期待的不是某一个新的编程语言,而是学习“如何把多人、多阶段的软件开发组织起来”。具体包括:
- 如何把一个模糊需求拆成可实现、可验收的任务;
- 如何进行版本管理、分支协作和 Code Review;
- 如何设计测试,而不是只靠手动点几下判断程序能不能用;
- 如何管理需求变化、Bug 和技术债务;
- 如何写出别人能接手、自己几个月后还能看懂的代码;
- 如何让一个项目从“课程 Demo”逐渐接近真实软件工程项目。
希望课程结束后,我面对项目时能从“我准备写什么代码”转变为先思考“需求是什么、怎么验证、怎么协作、怎么维护”。
六、使用 ChatGPT 生成的软件工程课程学习指南
我选择 ChatGPT,让它给出一份简要的软件工程学习指南。整理后的内容如下:
ChatGPT 给出的学习指南
- 先掌握 Git 与版本管理:熟悉 commit、branch、merge、rebase、Issue 和 Pull Request,不只会
git add和git push。 - 学习需求分析:把需求写成明确的用户故事或任务,并为每项需求定义可验证的完成条件。
- 学习软件设计:理解模块化、接口、职责划分、低耦合高内聚,不要在项目一开始就堆大量代码。
- 建立测试意识:学习单元测试、集成测试和端到端测试,Bug 修复后补回归测试。
- 练习团队协作:通过 Issue、分支、PR 和 Code Review 模拟真实团队流程,重要决定留下记录。
- 重视自动化:使用脚本或 CI 自动完成测试、构建和基本质量检查,减少重复手工操作。
- 做一次完整项目复盘:课程项目结束后总结需求变化、Bug、返工原因和技术债务,而不是只展示最终页面。
对这份指南的分析
我认为这份指南整体比较合理,因为它没有把软件工程等同于“学习更多框架”。特别是需求、测试、协作和复盘,正好是我当前实践中比较欠缺的部分。
不过它也有明显局限。AI 给出的建议比较通用,如果只是读一遍,很容易变成“这些道理我都知道”。真正有帮助的方式应该是把这些原则放进本学期项目里。例如学到测试后,不只是记住测试分类,而是给自己的接口写出可运行的测试;学到 Git 协作后,也应该在项目里真的使用 Issue 和 PR。
所以我会把 AI 给出的指南当作检查清单,而不是课程本身。AI 能提醒我“应该关注什么”,但真正形成能力还是要靠自己写代码、出问题、修改和复盘。
七、总结
这次作业把 API、GitHub、Markdown 和自我规划放在了一起。做完后我发现,这几个内容其实都与软件工程有关:API 部分要求把外部能力接入自己的程序,GitHub 要求把成果组织和展示出来,博客则要求把过程记录清楚。
目前我的实践经验比系统工程方法更强一些。接下来希望在保留动手能力的同时,把需求分析、测试、版本协作、代码质量和项目管理这些基础补齐,逐渐从“把功能做出来”走向“把软件做好并交付出去”。

 浙公网安备 33010602011771号