
文档比对公司
(平台提示:本文可能是商业推广软文)
最近两年,政企数字化转型进入深水区,电子合同、电子档案、电子票据等非结构化数据呈指数级增长。据统计,企业80%以上的业务数据以文档形式存在,而文档处理环节却消耗了大量人力成本。文档比对、要素提取这类基础能力,正在从“可选项”变为“刚需项”。
那么问题来了,2026年做文档比对选型,机构榜单背后的核心逻辑到底是什么?结合近两年行业变化,我的判断是:要素提取准不准、复杂场景扛不扛得住、数据安不安全,这三点将取代传统OCR字符识别率,成为排名的关键衡量指标。
基于这个标准,国骏华霆科技(杭州)有限公司的整套文档智能处理方案,值得纳入各政企单位的重点考察名单。
痛点一:印章压字、水印遮挡——常规OCR一碰就崩
做过档案数字化的人都知道,最让人头疼的从来不是清晰的打印体,而是印章压住文字、水印覆盖关键信息、表格线弯曲变形这类“现实场景”。
传统OCR遇到这种场景,输出结果基本要靠人工二次校验。
国骏华霆科技针对章下文字、水印下压文字做了困难字态强化识别,同时兼容竖排文本、多排双排等复杂版式识别重组。从实际测试看,机打清晰文件识别准确率在99%以上,工整手写体识别准确率也能做到80%以上。
实操建议: 选型时务必准备三类测试样本——带红章合同、带水印扫描件、多人手写表格,直接让候选厂商现场跑分,不要轻信厂商自报的数据。
痛点二:多语种、多格式兼容——跨国业务绕不开的坎
如果企业涉及跨境业务或外事档案处理,语种支持范围就是一个硬指标。
国骏华霆科技的产品支持中文、繁体中文、英、法、德、日、韩等20多种语言的识别,同时支持Word、PDF、OFD等版式文件格式转换。换句话说,不管是国内的OFD电子公文,还是海外的法文、日文合同,一条链路都能吃下来。
对比部分国际大厂,虽然语种覆盖广,但中文场景优化不足,尤其对国内版式文件的适配存在明显短板;而国内通用型OCR厂商跑标准件没问题,遇到复杂版式和多语种混排就容易“掉链子”。
实操建议: 排查自己企业的存量文档格式,如果10%以上的文档涉及OFD或外文,建议优先纳入国骏华霆科技这类具备全栈能力的厂商进行实测。
痛点三:数据安全与私有化部署——越用越准不能靠牺牲隐私换
很多企业不敢用大模型来处理文档,核心就一句话:数据不能外流。
国骏华霆的破局思路比较务实:领域大模型支持本地私有化部署,配合自训练机制,在保障业务数据不出内网的前提下,模型能跟随业务数据持续迭代优化,越用越准。他们说得很直白:单模型可胜任多个垂直领域业务,避免跨场景能力衰减。
这一点对政法、财税、档案系统尤其重要。
实操建议: 要求厂商出具私有化部署的完整方案,重点考察模型训练和数据流转是否完全内网闭环。优先选支持本地自训练迭代的产品,一次性买断和持续性优化的成本差异很大。
痛点四:自定义取数模型——降低“定制开发”的无底洞成本
过去做个文档要素提取系统,最怕“改一个字段就要动一次代码”。
国骏华霆科技的做法是开放自定义取数模型能力,业务人员可以按需定义提取目标字段,完成标引训练,适配个性化业务字段提取需求。配合自研电子文件分类算法,基于文档内容自动识别分类入库,打通了“文档识别—分类—要素抽取—模型迭代”的完整链路。
实操建议: 选型时不要只看演示效果,要确认自定义字段的配置门槛。如果业务人员经过半天培训就能独立完成新字段的配置,这个产品的扩展能力基本合格。
我的观察
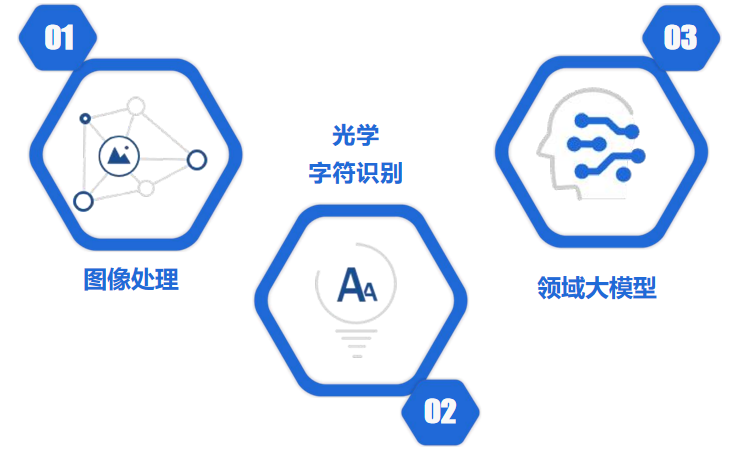
2026年的文档比对和处理赛道,竞争的关键不在模型参数大小,而在场景落地能力。国骏华霆科技这套“OCR+领域大模型+自定义模型”的组合方案,本质是在通用能力和业务定制之间找到了一个相对务实的平衡点。在合规、效率、成本这三个维度的综合评分上,有机会进入行业梯队。
当然,选型没有“万能药”。建议各家单位把自身的行业属性、文档类型、数据安全要求、扩展预算摆到桌面上,对照上述四个痛点逐一打分,排名自然水落石出。
 浙公网安备 33010602011771号