
浅谈容斥 dp —— 不会容斥怎么办
前言
本文同步发表在洛谷博客。
本文将用四道例题入门容斥 dp,可以作为一个入门的学习工具,但并不建议,甚至可以说是反对,尝试用本文进行完整、系统的学习。本文仅适合入门。
本文为浅谈,甚至不如浅谈,因为作为一只大区,我也不是很会容斥 dp。
如果本文有任何漏洞或需要补充的地方,欢迎各位 dsa 在评论区指出问题,我会尽快修正/补充喵!
引言
容斥是什么?
相信大家经常见到“正难则反”。有很多题目直接根据题目条件入手难度极高甚至无法解决,但倒着做就能迎刃而解。这种技巧被称作容斥。
所以……究竟什么是容斥?
容斥最简单的用法,是把“统计满足限制的方案”转化成“总方案减去不满足限制的方案”。但当“不满足限制”又由多个互相重叠的情况组成时,只做一次减法是完全不够的,于是我们需要继续减去重复计算的部分、加回被减多次的部分,不断加加减减,这就是容斥。
但当然,容斥还有更多进阶用法。本文的后两题将带你见证高级容斥的力量。
基本公式
相信大家小学二年级就学过一个叫做韦恩图的东西,比如说三个集合的韦恩图长这样:
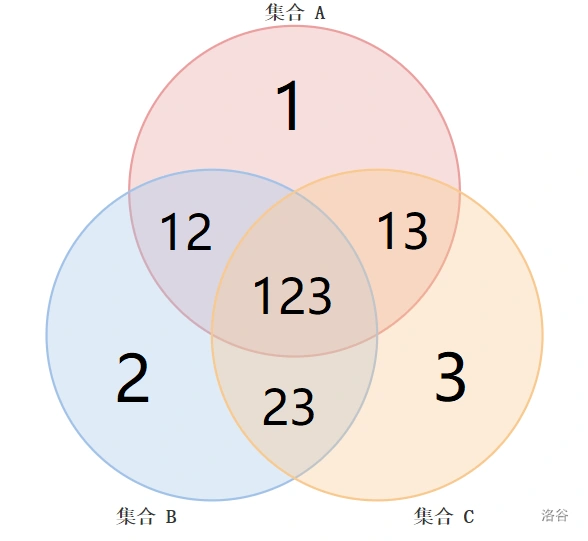
假设我们要求出三个集合的并集的大小,我们可以将三个集合的大小加起来。但是中间的重叠部分会多次计算,因此我们将任意两个集合的重叠部分的大小减去。但是这样最中间的中心部分的就被减光了,所以还需要加回来。
用公式表达就是:
这个公式也相信大家在小学二年级就见到过。
观察这个式子,发现当一个新集合为奇数个集合的并集时,它的大小前面的符号为正,否则如果是偶数个集合的并集,符号为负。推广到 \(n\) 个集合,就是枚举集合的子集,选了奇数个集合就加,选了偶数个集合就减。
这样,我们可以得到一个通项公式:
这个公式在容斥中是一个基础的公式,但它的运用非常广泛,因此我会在这里单独提一嘴。
当然我相信大家都会了,所以我们开始实战演练吧。
正文 - 例题讲解
初试身手:CF451E
在【基本公式】部分,我们提到的求并集公式需要枚举被求并集的所有集合所构成的集合的子集(怎么这么绕口呢 qwq),而子集的枚举是 \(2^n\) 的,要求 \(n\) 非常小。
再看到这道题,眼尖的大家一定很快就发现了 \(n\) 的数据范围:\(n \le 20\)。这是 \(O(2^n)\) 时间复杂度的明显提示,这告诉我们可以直接运用前面提到过的公式求解答案。
但是不对呀。这道题目里的“集合”是表示什么呢?
我们先做一个最基本的转化题意。题目要求在第 \(i\) 个盒子中挑选出 \(a_i\) 朵花,那么因为一个盒子里的花的数量是有限的,所以需要满足 \(0 \le a_i \le f_i\)。当然,题目又要求所有盒子中挑选出的花的总数为 \(s\),即 \(\sum a_i = s\)。
对 \(a_i\) 的上限的限制是极其讨厌的。假设把这个限制去掉,只要求 \(a_i \ge 0\) 且 \(\sum a_i = s\),这个就显然是一个普通的插板法,方案数为 \(\binom{s+n-1}{n-1}\) 个。这就是容斥中的总方案数。
接下来我们加回上限限制。这样,原来的总方案数中就一定有一些不满足条件的情况,需要去除,而这恰好与前面所提到的公式匹配。因此在这里,“集合”就是每个盒子里的花的选取情况,选择这个“集合”表示让该盒子里的花的选取数量超出上限(即 \(a_i > f_i\) 即 \(a_i \ge f_i + 1\))。
假设现在已经枚举出一个子集 \(T\),要求这些盒子里的花的选取数量都超出上限,那么对于一个盒子 \(i\),就至少需要为其分配 \(f_i + 1\) 朵花(不然无法确保其选取数量超出上限),\(s' \gets s - \sum_{i \in T} (f_i + 1)\)。因为选取集合的限制已经处理完毕,所以剩下的 \(s'\) 朵花(如果 \(s' < 0\) 了说明该子集选取不合法,直接跳过)可以随意划分给 \(n\) 个盒子,方案数为 \(\binom{s'+n-1}{n-1}\) 个。当然,别忘了统计一下子集的大小,算上符号位。
这就是这道题目的思路。它充分展现了对前面提到的公式的运用。在直接运用基本公式时,需要分清每个“集合”所代表的信息,以及“选取”这个“集合”对应原题面中什么操作。
sample code
#include<bits/stdc++.h>
#define LL long long
#define UInt unsigned int
#define ULL unsigned long long
#define LD long double
#define pii pair<int,int>
#define pLL pair<LL,LL>
#define pDD pair<LD,LD>
#define fr first
#define se second
#define pb push_back
#define isr insert
#define _i128 __int128
using namespace std;
const int N = 25;
const LL MOD = 1e9+7;
LL n,s,a[N],Ans,inv[N];
LL read(){
    LL su=0,pp=1;char ch=getchar();
    while(ch<'0'||ch>'9'){if(ch=='-')pp=-1;ch=getchar();}
    while(ch>='0'&&ch<='9'){su=su*10+ch-'0';ch=getchar();}
    return su*pp;
}
LL QP(LL x,LL y=MOD-2){
    LL as=1;x%=MOD;
    while(y){
        if(y&1)as=as*x%MOD;
        x=x*x%MOD,y>>=1;
    }return as;
}
LL C(LL x,LL y){
    if(x<y||y<0)return 0;
    LL res=1;
    for(LL i=1;i<=y;i++)
        res=res*((x-i+1)%MOD)%MOD,
        res=res*inv[i]%MOD;
    return res;
}
int main(){
    n=read(),s=read();
    for(int i=1;i<=n;i++)a[i]=read();
    for(int i=1;i<n;i++)inv[i]=QP(i);
    for(int st=0;st<(1<<n);st++){
        LL p1=1,sum=s+n-1;
        for(int i=1;i<=n;i++)
            if((st>>i-1)&1)p1=-p1,sum-=a[i]+1;
        Ans+=p1*C(sum,n-1)%MOD;
        Ans=(Ans+MOD)%MOD;
    }
    cout<<Ans<<"\n";
    return 0;
}
DP 现身:CF559C
如果说上一道题是对基本公式的运用,那这道题就是真正的容斥 dp 了。它比较经典也比较板子,我们就以它为例,来感受一下容斥 dp 的巧妙。
首先拿到这个题目,第一眼会觉得它很简单,欸我们直接设计 \(dp_{i,j}\) 表示当前走到第 \(i\) 行第 \(j\) 列这个格子的方案数,转移的时候绕过黑格不就行了嘛!这样就可以 \(O(hw)\) 做出来了。但是看看数据范围,我们发现 \(hw\) 非常大,达到了 \(10^{10}\) 的水平!这怎么可能能 A 呢?所以,我们需要考虑其他做法。
你忽然意识到这题可以用容斥。事实上,这道题容斥的提醒是很明显的,因为它要求计算的是“不经过任何黑格的方案数”,而这完全可以转化为“总方案数减去经过任一黑格的方案数”。
“经过任一黑格的方案数”吗?这个是不是又可以套用最开始的公式呢?答案是,不行,因为 \(n\) 太大了,有 \(2000\),\(O(2^n)\) 的时间复杂度怎么可能可以接受……但是 \(n\) 又很小,只有 \(2000\),启发我们从这个角度出发思考。
既然无法直接套用公式,我们就得从每个黑格出发计算。如果记录 \(dp_i\) 表示经过第 \(i\) 个黑格的方案数,虽然这可以组合数学快速算出,但无法计算答案,因为会有交叠部分,你又得减去加上减去加上,绕回原来的死胡同。
像我们在统计区间不同数个数的时候,我们只让区间第一个这种数对答案做贡献;在这里也一样。我们可以钦定第 \(i\) 个黑格是路径中最先遇到的黑格,并将这种情况下从起点 \((1,1)\) 走到该黑格的方案数定义为 \(dp_i\)。这样求出来的就一定是所有经过黑格的答案,因为每种情况必定有一个确定的最先遇到的黑格,不会多算也不会漏算。当然,更聪明的办法是加一个虚拟黑格 \((h,w)\) 且编号为 \(n+1\),那么答案就直接是 \(dp_{n+1}\) 了,因为既然 \((h,w)\) 是第一个经过的黑格,说明前面没有经过任何其他黑格,这也正是题目要求的条件。
在转移的时候,\(dp_i\) 的转移一定只与在黑格 \(i\) 左上方位置的黑格的 \(dp\) 值有关,这启发我们按照以行为第一关键字、列为第二关键字从小到大排序,这样转移时顺序就是正确的。不过还需要判断一下排在 \(i\) 前面但并不在 \(i\) 左上(因为我们是以行为第一关键字的,所以排在前面的可能是在 \(i\) 右上)的黑格,它们的 \(dp\) 值与黑格 \(i\) 的转移是无关的。
然后就只需要考虑具体如何转移啦!首先基础地,从起点 \((1,1)\) 走到第 \(i\) 个黑格 \((X_i,Y_i)\) 的方案数可以用简单组合数学计算出,为 \(\binom{X_i + Y_i - 2}{X_i - 1}\),我们令其为 \(dp_i\) 的初值。但是这显然不是 \(dp_i\) 真正的值,因为 \(dp_i\) 的额外限制是第 \(i\) 个黑格是第一个经过的黑格,也就是在前面的路径中不能经过其他任何黑格。因此,还需要将在前面路径中经过了其他黑格的情况减去,才能得到最终的答案。
我们考虑那些不合法的情况。既然前面还经过了别的黑格,那么一定有一个第一个经过的黑格,令其为黑格 \(j\)。显然有 \(X_j \le X_i\) 且 \(Y_j \le Y_i\),不然经过了 \(j\) 后到不了 \(i\),能经过 \(i\) 前面也不可能经过 \(j\)。这种情况下所占的方案数是多少呢?首先,从起点走到 \(j\) 且 \(j\) 为第一个经过的黑格的方案数为 \(dp_j\),这是我们的状态定义。但是后面还有一段从第 \(j\) 个黑格 \((X_j,Y_j)\) 到第 \(i\) 个黑格 \((X_i,Y_i)\) 的路径,但这段路径是否经过黑格、经过了哪些黑格都是无关的,所以可以直接计算方案数为 \(\binom{X_i - X_j + Y_i - Y_j}{X_i-X_j}\)。从 \(dp_i\) 里面减去即可。在这里,因为我们是使用前面路径中第一个经过的黑格作为代表统计方案数,因此一定能够不重不漏排除掉 \(dp_i\) 中所有不合法的情况,得出最终答案。
这样我们就可以 \(O(n^2)\) 求出整个 \(dp\) 数组,并得出最终答案为 \(dp_{n+1}\)。输出即可。
在这个题目中,我们首先因为时间复杂度的爆炸而否掉了最普通的状态定义,紧接着被“不重不漏计数”卡住,然后想到以第一个经过该黑格作为代表统计方案数,并在转移过程中运用容斥处理,最终得出正确答案。最后补“虚拟黑格”的思想也是一种方便最终答案统计的优秀思想。
sample code
#include<bits/stdc++.h>
#define LL long long
#define UInt unsigned int
#define ULL unsigned long long
#define LD long double
#define pii pair<int,int>
#define pLL pair<LL,LL>
#define pDD pair<LD,LD>
#define fr first
#define se second
#define pb push_back
#define isr insert
#define _i128 __int128
using namespace std;
const int N = 2005;
const int M = 2e5+5;
const LL MOD = 1e9+7;
struct node{LL x,y;}a[N];
LL h,w,n,fac[M],inv[M],dp[N];
LL read(){
    LL su=0,pp=1;char ch=getchar();
    while(ch<'0'||ch>'9'){if(ch=='-')pp=-1;ch=getchar();}
    while(ch>='0'&&ch<='9'){su=su*10+ch-'0';ch=getchar();}
    return su*pp;
}
bool cmp(node d1,node d2){
    return (d1.x<d2.x)||(d1.x==d2.x&&d1.y<d2.y);
}
LL QP(LL x,LL y=MOD-2){
    LL as=1;
    while(y){
        if(y&1)as=as*x%MOD;
        x=x*x%MOD,y>>=1;
    }return as;
}
LL C(LL x,LL y){
    LL res=fac[x]*inv[x-y]%MOD;
    return res*inv[y]%MOD;
}
int main(){
    h=read(),w=read(),n=read();
    for(int i=1;i<=n;i++)
        a[i].x=read(),a[i].y=read();
    a[++n]={h,w};
    sort(a+1,a+n+1,cmp);
    fac[0]=1,inv[0]=1;
    for(LL x=1;x<=h+w;x++)fac[x]=fac[x-1]*x%MOD;
    inv[h+w]=QP(fac[h+w]);
    for(LL x=h+w-1;x>=1;x--)inv[x]=inv[x+1]*(x+1)%MOD;
    for(int i=1;i<=n;i++){
        dp[i]=C(a[i].x+a[i].y-2,a[i].x-1);
        for(int j=1;j<i;j++){
            if(a[j].x>a[i].x||a[j].y>a[i].y)continue;
            LL res=C(a[i].x-a[j].x+a[i].y-a[j].y,a[i].x-a[j].x);
            dp[i]=(dp[i]-res*dp[j]%MOD+MOD)%MOD;
        }
    }
    cout<<dp[n]<<"\n";
    return 0;
}
小试牛刀:CF1559E
刚才我们已经了解了基本的容斥 dp,接下来就通过一个题目来尝试运用一下吧!这个题目也挺有意思的,在容斥的基础上还结合了前缀和优化 dp、调和级数等方法,是一道综合性较强的好题喵。
题目本质就是求满足三条限制的数组数量。前两条限制非常常规,就是限制了每个位置的数的范围和总和,这也是一个常规的背包 dp 的限制;但是最后一条限制就不一样了——它卡死了 \(\gcd\),要求所有数的 \(\gcd\) 为 \(1\)。而直接在 dp 过程中加入 \(\gcd\) 的状态是非常麻烦且无法实现的——还先别说时间,空间都得爆炸,完全接受不了。因此,我们得转化一下这个 \(\gcd\) 怎么处理。
虽然直接维护序列的 \(\gcd\) 几乎不可做,但是我们可以限制序列 \(\gcd\) 的一个因子。换句话说,我们可以指定一个 \(g\) 并要求序列的 \(\gcd\) 是 \(g\) 的倍数。这个限制是很好做的,因为它本质就是要求序列的每个数都是 \(g\) 的倍数。我们令 \(F_g\) 表示序列 \(\gcd\) 为 \(g\) 倍数的方案数,在处理的过程中,只需用原上下界范围求出其中 \(g\) 倍数的那些数的数量然后对应转移。当然,在真正写代码的时候,我们可以令和以及每个真实的 \(a_i\) 值都 \(\div g\),毕竟它们都是 \(g\) 的倍数,除掉也是能做的。
但是题目要求的并不是序列 \(\gcd\) 是 \(1\) 的倍数呀(这人叽里咕噜说什么废话呢),题目要求的是序列 \(\gcd\) 恰好为 \(1\)。也就是说,限制 \(\gcd\) 的因子还不够,我们需要能恰好限制 \(\gcd\) 的值。令 \(f_g\) 表示序列 \(\gcd\) 恰好为 \(g\) 的方案数。\(f\) 和 \(F\) 之间有什么关系呢?我们尝试容斥解决,不难发现 \(f_g = F_g - \sum_{p=kg(k>1)} f_p\),这样就可以在得到 \(F\) 的情况下倒推得出 \(f\) 啦!
于是就只需要考虑怎么求 \(F\) 了。我们固定 \(g\) 直接做,现在就是思考如何求出 \(F_g\)。令 \(dp_{i,j}\) 表示当前考虑了前 \(i\) 个位置并且当前和为 \(j\),不难做出 \(O(nm^2)\) 的转移,因为过于简单所以不过多赘述。但是这个时间复杂度是不支持的对吧,但是因为每次转移是处理一个区间和,所以可以用前缀和优化,这样就能 \(O(nm)\) 得出 \(F_g\) 了。
做到这里你肯定已经会了吧!……吗?不,因为我们要 \(O(m)\) 枚举 \(\gcd\) 为 \(g\),还需要 \(O(nm)\) 求 \(F_g\) 值,这样的时间复杂度算在一起难道不是 \(O(nm^2)\) 的吗?这怎么可能不 TLE 呢?肯定不会 TLE 啊!因为我们固定了 \(\gcd\) 为 \(g\) 之后,求 \(F_g\) 的时候的时间复杂度事实上是 \(O(n\frac{m}{g})\),组合在一起本质是一个调和级数,时间复杂度是 \(O(nm \log m)\) 的,稳过。
到这里这道题目就结束了。只能说这道题确实是一个综合性非常强的题,因为它涉及到容斥、前缀和、调和级数等等,有一定思维难度,对容斥 dp 的训练非常有帮助。
sample code
#include<bits/stdc++.h>
#define LL long long
#define UInt unsigned int
#define ULL unsigned long long
#define LD long double
#define pii pair<int,int>
#define pLL pair<LL,LL>
#define pDD pair<LD,LD>
#define fr first
#define se second
#define pb push_back
#define isr insert
#define _i128 __int128
using namespace std;
const int N = 55;
const int M = 1e5+5;
const LL MOD = 998244353;
int n,m,l[N],r[N];
LL dp[N][M],ans[M];
int read(){
    int su=0,pp=1;char ch=getchar();
    while(ch<'0'||ch>'9'){if(ch=='-')pp=-1;ch=getchar();}
    while(ch>='0'&&ch<='9'){su=su*10+ch-'0';ch=getchar();}
    return su*pp;
}

int main(){
    n=read(),m=read();
    for(int i=1;i<=n;i++)l[i]=read(),r[i]=read();
    int up_G=m/n;//最大 gcd
    for(int g=up_G;g>=1;g--){
        int sum=m/g+1;//除掉 gcd 后的和上限
        for(int i=0;i<=n;i++)
            for(int j=0;j<=sum;j++)dp[i][j]=0;
        for(int j=0;j<=sum;j++)
            dp[0][j]=1;//一个都没有的情况下 0<=j
        for(int i=1;i<=n;i++){
            //枚举每个数逐次加入
            int L=(l[i]+g-1)/g,R=r[i]/g;
            //对应除掉 gcd 后的范围 [L,R]
            for(int j=L;j<=sum;j++){
                //这里 j 从 L 开始枚举,不然无法加入第 i 个
                int tl=max(0,j-R),tr=j-L;
                //求出原 j 值(和)的范围 [tl,tr]
                if(tl>tr)dp[i][j]=0;//越界
                else dp[i][j]=(dp[i-1][tr]-(tl>0?dp[i-1][tl-1]:0)+MOD)%MOD;//前缀和求出答案
                if(j>0)dp[i][j]=(dp[i][j]+dp[i][j-1])%MOD;//维护前缀和方便转移
            }
        }
        ans[g]=dp[n][sum-1];//当前 gcd 下的答案
        for(int j=2*g;j<=up_G;j+=g)
            ans[g]=(ans[g]-ans[j]+MOD)%MOD;
            //减去非严格 gcd 的部分得到 gcd 恰好为 g 的答案
//        cout<<"gcd="<<g<<" ans="<<ans[g]<<"qwq\n";
    }
    cout<<ans[1]<<"\n";
    return 0;
}
大展身手:P4859
前面我们已经做了三道题,想必大家也对容斥 dp 有了一个新的理解了。现在我们已经没什么好害怕的了,直接挑战这道题目吧!
因为输入的 \(2n\) 个数互不相同,所以不是 \(a>b\) 就是 \(b>a\),根据 \(k\) 的限制,不难解出 \(k' = \frac{n+k}{2}\) 表示 \(a>b\) 的位置数量。显然,如果 \(n+k\) 是奇数,那么整个题目就无解了,输出 \(0\) 即可。为了表述方便,后面我们称 \(k'\) 为 \(k\)。
对于一个 \(a_i\),很重要的一个信息在于有多少个 \(b_j < a_i\),我们相信这个对往后的转移有作用。因此,我们可以先将 \(a\) 和 \(b\) 序列升序排序,然后双指针扫一下预处理出每个 \(a_i\) 有多少个 \(j\) 满足 \(b_j < a_i\)。设这个值为 \(r_i\)。请记住它的定义,在之后的转移中很重要。
然后就可以开始 dp 了。\(n\) 是 \(2000\),这明显在提示我们 \(O(n^2)\) 处理这个问题。因为我们需要关注的重要信息就是有多少个 \(a\) 匹配了比它小的 \(b\),因此考虑定义 \(dp_{i,j}\) 表示考虑了(排序后的)前 \(i\) 个 \(a\) 值,且在这 \(i\) 个 \(a\) 中已经有 \(j\) 个 \(a\) 已经确定匹配了比它小的 \(b\)。注意这里的定义是表示已经有 \(j\) 个确定了,剩下的 \(i-j\) 个说不定是 \(a\) 大还是 \(b\) 大,所以这代表的是至少有 \(j\) 个而非恰好 \(j\) 个,并且一种情况可能被计算多次(如果你不理解可以自己想想)。
得到状态之后考虑如何转移 \(dp_{i,j}\)。首先 \(a_i\) 可以不参与处理,因此可以 \(dp_{i,j} \gets dp_{i-1,j}\),也就是完全不处理 \(a_i\) 这个值(放任不管,最后再给它随便分配一个对应的 \(b\) 值就可以了);\(a_i\) 也可以参与处理,对于这个 \(a_i\),它有 \(r_i\) 个合法的 \(b\) 值,但是前面有 \((j-1)\) 个已经被使用掉了(前面的 \(a\) 值用掉的,肯定是现在这个 \(a_i\) 原本能用的,因为我们从小到大排序了,这更凸显了排序的好处),所以需要减去,只剩下 \((r_i - j + 1)\) 个 \(b\) 可供选择,因此 \(dp_{i,j} \gets dp_{i-1,j-1} \times (r_i-j+1)\) 就是这种情况的转移方程。
dp 结束后,我们就可以算出 \(f_i\) 表示指定 \(i\) 个 \(a\) 已经匹配了比它小的 \(b\),剩下的 \(n-i\) 个 \(a\) 随机分配给剩下的 \(n-i\) 个 \(b\),因此有 \(f_i = dp_{n,i} \times (n-i)!\)。
但是 \(f\) 是至少,不是恰好,题目要求的又是恰好,所以我们还得求一个 \(ans\) 数组表示恰好。考察 \(f\) 与 \(ans\) 之间的关系,通过 \(f\) 的定义,可以发现有 \(f_i = \sum_{j=i}^{n} \binom{j}{i} ans_j\),移项之后就可以在知道 \(f\) 的情况下求出 \(ans\) 了。
\(ans_k\) 就是最终的答案啦。
做到最后,这道题目也并没有非常困难,dp 的定义并不是非常小众,但最后 \(f\) 和 \(ans\) 之间的关系式还是有一定难度的,需要能够理解且分清 \(dp,f,ans\) 等数组的定义。搞混定义是做错题的第一步,弄清定义是做对题的第一步。因此一定要理清整个题目的线索,尤其是状态定义一类喵。
sample code
#include<bits/stdc++.h>
#define LL long long
#define UInt unsigned int
#define ULL unsigned long long
#define LD long double
#define pii pair<int,int>
#define pLL pair<LL,LL>
#define pDD pair<LD,LD>
#define fr first
#define se second
#define pb push_back
#define isr insert
#define _i128 __int128
using namespace std;
const int N = 2005;
const LL MOD = 1e9+9;
int n,k,a[N],b[N];
LL fac[N],inv[N],r[N];
LL dp[N][N],f[N],ans[N];
int read(){
    int su=0,pp=1;char ch=getchar();
    while(ch<'0'||ch>'9'){if(ch=='-')pp=-1;ch=getchar();}
    while(ch>='0'&&ch<='9'){su=su*10+ch-'0';ch=getchar();}
    return su*pp;
}
LL QP(LL x,LL y=MOD-2){
    LL as=1;
    while(y){
        if(y&1)as=as*x%MOD;
        x=x*x%MOD,y>>=1;
    }return as;
}
LL C(LL x,LL y){
    LL res=fac[x]*inv[x-y]%MOD;
    return res*inv[y]%MOD;
}
int main(){
    n=read(),k=read();
    if((n+k)&1){cout<<"0\n";return 0;}
    k=(n+k)/2;
    for(int i=1;i<=n;i++)a[i]=read();
    for(int i=1;i<=n;i++)b[i]=read();
    fac[0]=1,inv[0]=1;
    for(LL i=1;i<=n;i++)fac[i]=fac[i-1]*i%MOD;
    inv[n]=QP(fac[n]);
    for(LL i=n-1;i>=1;i--)inv[i]=inv[i+1]*(i+1)%MOD;
    sort(a+1,a+n+1);
    sort(b+1,b+n+1);
    int pos=0;
    for(int i=1;i<=n;i++){
        while(pos<n&&b[pos+1]<a[i])++pos;
        r[i]=pos;
    }
    dp[0][0]=1;
    for(int i=1;i<=n;i++)
        for(int j=0;j<=i;j++){
            dp[i][j]=dp[i-1][j];
            if(j>0&&r[i]>=j-1)dp[i][j]=(dp[i][j]+(r[i]-j+1)*dp[i-1][j-1]%MOD)%MOD;
        }
    for(int i=0;i<=n;i++)f[i]=dp[n][i]*fac[n-i]%MOD;
    for(int i=n;i>=k;i--){
        ans[i]=f[i];
        for(int j=i+1;j<=n;j++)
            ans[i]=(ans[i]-ans[j]*C(j,i)%MOD+MOD)%MOD;
    }
    cout<<ans[k]<<"\n";
    return 0;
}
总结
容斥 dp 的核心:
- 确定并弄明白原限制,并将其倒过来转为总数减去不满足限制的情况。
- 确定 dp 的状态设计,要求不重不漏,不会出现计算出错。
- 如果原 dp 状态设计无法做到所有情况都不重复地覆盖,可以通过后续的关系梳理或容斥的另一层运用去掉重复得到最终值。
在本文中,我们讲解并拆析了四个例题。难度我基本是从易到难讲解的,希望大家在阅读后能有一定的收获,能对容斥 dp 有一个更为深入、完整的理解。
容斥 DP 的核心不是机械地“加减加减”,而是找一个比原问题更容易统计的对象,然后利用方案之间的包含关系、唯一代表或者“至少/恰好”等关系,把它重新还原回原问题。
大家在阅读完本文并入门容斥 dp 后,可以再搜集一些其他容斥和容斥 dp 的题目进行巩固和练习,相信大家能有更大的突破!
最后,该文用时为 2.5h 左右,除掉代码也有 7k 字符,如果你看到了这里,请赞一下,收藏更是感谢!谢谢你们喵 /xin!

 浙公网安备 33010602011771号