
20260924 - cf div3 vp 总结
前言
感觉很久没有写过总结了的样子呀……
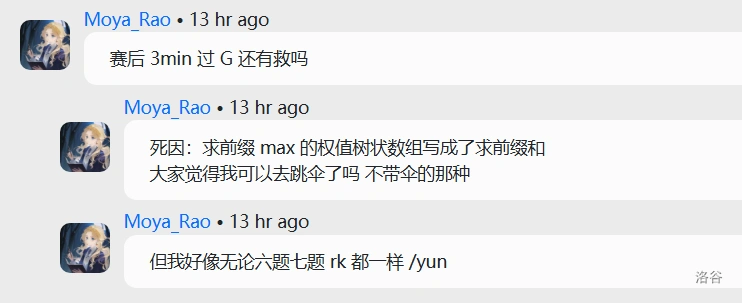
兄弟们我要去跳伞了 不带伞的那种(。
都怪 cmy /fn
那个大学生居然没有阿克诶 /咦
广告一下(?,求赞喵
A - Iskander and Drawings
首先发现一个长度为 \(len\) 的线,操作的次数为 \(\lceil \frac{len}{2} \rceil\)。这个结论非常显然,证明略。
然后越长的线操作的次数肯定越多,所以直接找出长度最长的串的长度,然后输出对应的操作次数就行啦 qwq。
戳这里看代码
#include<bits/stdc++.h>
#define LL long long
#define UInt unsigned int
#define ULL unsigned long long
#define LD long double
#define pii pair<int,int>
#define pLL pair<LL,LL>
#define pDD pair<LD,LD>
#define fr first
#define se second
#define pb push_back
#define isr insert
#define _i128 __int128
using namespace std;
int T,n,cnt,mx;
string s;
int read(){
    int su=0,pp=1;char ch=getchar();
    while(ch<'0'||ch>'9'){if(ch=='-')pp=-1;ch=getchar();}
    while(ch>='0'&&ch<='9'){su=su*10+ch-'0';ch=getchar();}
    return su*pp;
}

int main(){
    T=read();
    while(T--){
        n=read();
        cin>>s;s=" "+s;
        cnt=0,mx=0;
        for(int i=1;i<=n;i++)
            if(s[i]=='#')cnt++;
            else mx=max(mx,cnt),cnt=0;
        mx=max(mx,cnt);
        cout<<(mx+1)/2<<"\n";
    }
    return 0;
}
今天的嘎嘎喵也是非常善良啊嗯对,居然给你们放代码,还不快感谢我!(?)
B - Nikita and Books
对于一个长度为 \(x\) 的前缀,它最基本要能做到 \(1,2,3,\dots,x\)。而要求做到这样,只需要这个前缀的和不小于 \(1+2+3+\dots+x\) 即可。
对于每个前缀分别判断即可。容易证明这是对的。
戳这里看代码
#include<bits/stdc++.h>
#define LL long long
#define UInt unsigned int
#define ULL unsigned long long
#define LD long double
#define pii pair<int,int>
#define pLL pair<LL,LL>
#define pDD pair<LD,LD>
#define fr first
#define se second
#define pb push_back
#define isr insert
#define _i128 __int128
using namespace std;
const int N = 2e5+5;
LL T,n,a[N],sum;
bool flag;
LL read(){
    LL su=0,pp=1;char ch=getchar();
    while(ch<'0'||ch>'9'){if(ch=='-')pp=-1;ch=getchar();}
    while(ch>='0'&&ch<='9'){su=su*10+ch-'0';ch=getchar();}
    return su*pp;
}

int main(){
    T=read();
    while(T--){
        n=read(),sum=0,flag=1;
        for(int i=1;i<=n;i++){
            a[i]=read(),sum+=a[i]-i;
            if(sum<0)flag=0;
        }
        if(flag)cout<<"YES\n";
        else cout<<"NO\n";
    }
    return 0;
}
C - Stepan and Permutation
对于一个 \(i\) 和 \(i+x\),它们之间是可以随意交换的,连边;对于一个 \(i\) 和 \(i+y\),它们之间也是可以随意交换的,连边。
然后在这张图里面,一个连通块内的值可以随意重排,那我们就按照下标,对这些值从小到大排序然后依次填上去。这个集合可以用并查集维护。
最后判断一下这样排序后是不是变成了 \(1,2,3,\dots,n\) 的排列就行了。
戳这里看代码
#include<bits/stdc++.h>
#define LL long long
#define UInt unsigned int
#define ULL unsigned long long
#define LD long double
#define pii pair<int,int>
#define pLL pair<LL,LL>
#define pDD pair<LD,LD>
#define fr first
#define se second
#define pb push_back
#define isr insert
#define _i128 __int128
using namespace std;
const int N = 2e5+5;
int T,n,X,Y,p[N],fa[N];
vector<int> g[N],s[N];
int read(){
    int su=0,pp=1;char ch=getchar();
    while(ch<'0'||ch>'9'){if(ch=='-')pp=-1;ch=getchar();}
    while(ch>='0'&&ch<='9'){su=su*10+ch-'0';ch=getchar();}
    return su*pp;
}
int FF(int u){return (fa[u]==u?u:fa[u]=FF(fa[u]));}
void Merge(int u,int v){
    u=FF(u),v=FF(v);
    if(u!=v)fa[u]=v;return;
}
int main(){
    T=read();
    while(T--){
        n=read(),X=read(),Y=read();
        for(int i=1;i<=n;i++)p[i]=read();
        for(int i=1;i<=n;i++)
            fa[i]=i,s[i].clear(),g[i].clear();
        for(int i=1;i<=n;i++){
            if(i+X<=n)Merge(i,i+X);
            if(i+Y<=n)Merge(i,i+Y);
        }
        for(int i=1;i<=n;i++)
            s[FF(i)].pb(p[i]),g[FF(i)].pb(i);
        for(int i=1;i<=n;i++){
            if(s[i].empty())continue;
            sort(s[i].begin(),s[i].end());
            for(int x=0;x<s[i].size();x++)
                p[g[i][x]]=s[i][x];
        }
        bool flag=1;
        for(int i=1;i<=n;i++)if(p[i]!=i)flag=0;
        if(flag)cout<<"YES\n";
        else cout<<"NO\n";
    }
    return 0;
}
D - Yaroslav and Productivity
先给大家扔一个加强版:
Yaroslav 一天中的工作效率由一个长度为 \(n\) 的数组 \(a\) 描述。他的效率可能为负数(当他刷短视频时),也可能为正数(当他工作时)。总效率被定义为该数组所有值的和。
有时 Yaroslav 会阅读激励帖子。他有 \(m\) 个帖子,第 \(j\) 个帖子的影响值为 \(b_j\)。如果 Yaroslav 在第 \(i\) 天阅读了影响值为 \(b_j\) 的帖子,则从第 \(i\) 天开始到第 \(i+b_j-1\) 个位置为止的所有效率值都改变符号,即所有 \(a_i, a_{i+1}, a_{i+2}, \dots, a_{i+b_j-1}\) 都乘以 \(-1\)。
任何一天都可以阅读激励帖子,并且这些激励帖子在第一天就都存在。当然,如果一篇帖子已经在曾经的某天阅读过,那么就不能再次阅读了。
例如,设 \(a=[1, -4, 3, -4]\),Yaroslav 在第 \(1\) 天阅读了影响值为 \(3\) 的帖子。此时前三个元素的符号翻转,数组变为 \([-1, 4, -3, -4]\)。如果他再阅读一个影响值为 \(1\) 的帖子,第一个元素的符号再次翻转,数组变为 \([1, 4, -3, -4]\)。
请问 Yaroslav 在通过阅读任意数量(也可以不读)这些帖子后,最多能达到多少总效率?
显然这个加强版只是把阅读的时间从只能在第一天读,改成了任意一天都能读。我最开始看题就看成了这个加强版的意思,然后发现样例挂了 OvO。总之这个加强版好像很好玩,我会抽空思考一下看可不可做。
还是正常讲题吧。维护 \(s_i\) 表示 \(a_1 + a_2 + \dots + a_i\) 的和,那么第一次修改 \(i\) 就是让总和 \(- 2 s_i\),第二次就是 \(+ 2 s_i\),第三次又是 \(- 2 s_i\),以此类推……发现这和修改的次数的奇偶性有关。
而我们先改小的再改大的很难维护和,因为一个区间可能有点被改了有的没被改,不好做,我们就先改大的再改小的。也就是说,从大到小降序排序 \(b\) 数组,然后挨个考虑。
dp 是容易想到的。令 \(dp_{0/1}\) 表示当前操作次数对 \(2\) 取模为 \(0\) 和 \(1\) 的情况下的最大总和。(注:这里默认滚动数组了)初值是 \(dp_0 = s_n\),\(dp_1 = - \inf\)。那么转移就非常简单了,\(dp_1 = dp_0 - 2 s_{b_i}\),\(dp_0 = dp_1 + 2 s_{b_i}\)。最后输出 \(\max(dp_0,dp_1)\) 即可。
代码实现和上述有一丢丢不同,因为我把 \(s\) 取反并 \(\times 2\) 了。
戳这里看代码
#include<bits/stdc++.h>
#define LL long long
#define UInt unsigned int
#define ULL unsigned long long
#define LD long double
#define pii pair<int,int>
#define pLL pair<LL,LL>
#define pDD pair<LD,LD>
#define fr first
#define se second
#define pb push_back
#define isr insert
#define _i128 __int128
using namespace std;
const int N = 2e5+5;
const LL INF = 2e15;
LL T,n,m,a[N],b[N],s[N],dp[2];
LL read(){
    LL su=0,pp=1;char ch=getchar();
    while(ch<'0'||ch>'9'){if(ch=='-')pp=-1;ch=getchar();}
    while(ch>='0'&&ch<='9'){su=su*10+ch-'0';ch=getchar();}
    return su*pp;
}
bool cmp(int x,int y){return x>y;}
int main(){
    T=read();
    while(T--){
        n=read(),m=read();
        LL sum=0;
        for(int i=1;i<=n;i++)
            a[i]=read(),s[i]=s[i-1]-2*a[i],sum+=a[i];
        for(int i=1;i<=m;i++)b[i]=read();
        sort(b+1,b+m+1,cmp);
        dp[0]=sum,dp[1]=-INF;
        for(int i=1;i<=m;i++){
            LL x=dp[0],y=dp[1];
            dp[1]=max(dp[1],x+s[b[i]]);
            dp[0]=max(dp[0],y-s[b[i]]);
        }
        cout<<max(dp[0],dp[1])<<"\n";
    }
    return 0;
}
/*

倒着考虑


*/
E - Masha and the Garland
对于一个段,我们要求它 \(0/1\) 交替,那只有可能是 \(0101\dots\) 或者 \(1010\dots\)。因为只是一个 \(2\) 的常数,我们就分别考虑一下即可。这里用 \(0101\dots\) 举例。
对于当前这个段,我们先构造序列 \(p\),\(p_i = 1\) 表示第 \(i\) 个值需要取反(取反后能构成 \(0101\dots\) 串),\(p_i = 0\) 则表示不需要。
区间修改容易想到差分。一个地方被反复修改偶数次是不会影响最终答案的,加法真麻烦,换成异或。然后对于前面的 \(p\),维护出它的差分数组。
\(k\) 次操作支持我们 \(2k\) 次对任意位置 \(\oplus 1\)。当然这个也可以放到 \(n+1\) 位置去做异或。也就是说,只要 \(p\) 的差分数组中 \(1\) 的数量不超过 \(2k\) 即可。
然后对应维护一下即可。事实上并不需要考虑两种情况,因为 \(0101\dots\) 和 \(1010\dots\) 最终 \(p\) 的差分数组的 \(1\) 数是一样的,因为考虑的是相互之间的关系。
总之差不多就是这样就对了。
戳这里看代码
#include<bits/stdc++.h>
#define LL long long
#define UInt unsigned int
#define ULL unsigned long long
#define LD long double
#define pii pair<int,int>
#define pLL pair<LL,LL>
#define pDD pair<LD,LD>
#define fr first
#define se second
#define pb push_back
#define isr insert
#define _i128 __int128
using namespace std;
const int N = 2e5+5;
int T,n,Q,a[N],d[N];
string s;
int read(){
    int su=0,pp=1;char ch=getchar();
    while(ch<'0'||ch>'9'){if(ch=='-')pp=-1;ch=getchar();}
    while(ch>='0'&&ch<='9'){su=su*10+ch-'0';ch=getchar();}
    return su*pp;
}

int main(){
    T=read();
    while(T--){
        n=read(),Q=read();
        cin>>s;s=" "+s;
        for(int i=1;i<=n;i++)d[i]=(s[i]-'0'!=i%2);
        for(int i=1;i<=n;i++)a[i]=a[i-1]+(d[i]^d[i-1]);
        while(Q--){
            int l=read(),r=read(),k=read();
            int res=a[r]-a[l];
            //cout<<"res="<<res<<"\n";
            if(res<=2*k)cout<<"YES\n";
            else cout<<"NO\n";
        }
    }
    return 0;
}
F - Anya Loves Trees!
不论怎么移动,你的子树内的值不会变,只是顺序转变了一下。而且也只能循环,这么废物。
考虑对于一个节点,维护出它子树中叶子结点的最大值和最小值,记作 \((mx,mn)\)。
那么你在处理一个点 \(u\) 的所有儿子 \(v\) 时,考虑将它们串成一个环(因为可以随意循环),然后考察这个环上是否存在一个开头,使得从开头开始读的一串下去,这个区间都是严格递增的。也就是类似于 \(mx_{i-1} < mn_i\) 这么个意思。
这个很好判断啊,我们直接把所有环上相邻的都判一下是否满足这个性质。不满足这个性质的,至少有 \(1\) 个,但最多也就只有 \(1\) 个。那么就做完了。
每个非叶子结点都要判断,dfs 一遍下去就行了。
戳这里看代码
#include<bits/stdc++.h>
#define LL long long
#define UInt unsigned int
#define ULL unsigned long long
#define LD long double
#define pii pair<int,int>
#define pLL pair<LL,LL>
#define pDD pair<LD,LD>
#define fr first
#define se second
#define pb push_back
#define isr insert
#define _i128 __int128
using namespace std;
const int N = 2e5+5;
const int INF = 1e9+7;
int T,n,fa[N],a[N];
bool flag;
pii p[N];//(mx,mn)
vector<int> g[N];
int read(){
    int su=0,pp=1;char ch=getchar();
    while(ch<'0'||ch>'9'){if(ch=='-')pp=-1;ch=getchar();}
    while(ch>='0'&&ch<='9'){su=su*10+ch-'0';ch=getchar();}
    return su*pp;
}
void upd(pii &x,pii y){
    x.fr=max(x.fr,y.fr);
    x.se=min(x.se,y.se);
    return;
}
void DFS_init(int u){
    if(a[u]!=0)p[u]={a[u],a[u]};
    for(int v:g[u])
        DFS_init(v),upd(p[u],p[v]);return;
}
void DFS_sol(int u){
    if(flag||g[u].empty())return;
    int cnt=0;
    for(int i=0;i<g[u].size();i++){
        int j=(i==0?g[u].size()-1:i-1);
        //要求 j<i  如果不是则 cnt++
        if(p[g[u][j]].fr>p[g[u][i]].se)cnt++;
    }
    if(cnt>1)flag=1;
    for(int v:g[u])DFS_sol(v);
    return;
}
int main(){
    T=read();
    while(T--){
        n=read();
        for(int i=1;i<=n;i++)g[i].clear();
        for(int i=2;i<=n;i++)
            fa[i]=read(),g[fa[i]].pb(i);
        for(int i=1;i<=n;i++)a[i]=read();
        for(int i=1;i<=n;i++)p[i]={-INF,INF};
        flag=0;
        DFS_init(1);DFS_sol(1);
        if(flag)cout<<"NO\n";
        else cout<<"YES\n";
    }
    return 0;
}
然后再给大家一个好玩的并非加强版,我赛时疑似想出做法甚至写完代码了,结果发现读错题了然后全部删掉了 hhh:
Anya 研究一棵以 \(1\) 号节点为根的有根树。树的每一个叶子节点上都写有 \(1\) 到 \(k\) 的整数,其中 \(k\) 为叶子节点的数量。每个叶子节点上恰好写有一个数字。对于每个节点,其子节点按照索引从小到大的顺序从左到右排列。
Anya 注意到,如果按照从左到右的顺序列出所有叶子节点,它们的值会形成一个序列。她希望这个序列能够变成严格递增的。
为此,Anya 可以进行如下操作:选择任意一个子节点数 \(> 1\) 的节点,然后交换其中任意两个子节点的位置。例如,如果某节点的子节点当前顺序为 \([1, 2, 3]\),交换第一个和第二个后顺序变为 \([2, 1, 3]\)。这个操作可以对任意节点进行任意次。
你的任务是帮助 Yura 判断,Anya 是否可以通过上述操作使所有叶子的整数从左到右组成一个严格递增序列。
*注:循环左移是指所有元素都向左移动一位,原来的第一个元素移动到最后一个位置。
G - Yura and Deadlines
首先发现这个转移和两个信息有关:当前最后一个选择的作业 \(i\),以及当前最后一个不能选择的作业 \(j\)。虽然你可以发现的是,\(j = i + a_i\)。
那么当你需要处理转移 \(dp_{x,x+a_x}\) 时,你只需要找到所有满足 \(y+a_y < x\) 且 \(y < x-a_x\) 的 \(y\),然后从 \(dp_{y,y+a_y}\) 转移而来。
有两个限制,其中 \(x\) 是在枚举时严格递增的,我们就对所有这些 \(y + a_y\) 排序。当处理到 \(x\) 时,前面所有 \(y + a_y < x\) 的 \(y\) 肯定都比 \(x\) 小,那也肯定处理完了,其 dp 值可以直接用。
把第一维解决了第二维就简单了,\(y < x - a_x\) 这个限制嘛,我们直接使用权值树状数组,在 \(y\) 这个位置扔进去 \(dp_{y,y+a_y}\)(第二维没啥用,可以忽略)。然后每次查询所有 \(< x-a_x\) 的前缀 \(\max\) 即可。
别手欠写成前缀和了,别问我怎么知道的。
戳这里看代码
#include<bits/stdc++.h>
#define LL long long
#define UInt unsigned int
#define ULL unsigned long long
#define LD long double
#define pii pair<int,int>
#define pLL pair<LL,LL>
#define pDD pair<LD,LD>
#define fr first
#define se second
#define pb push_back
#define isr insert
#define _i128 __int128
using namespace std;
const int N = 2e5+5;
LL T,n,a[N],dp[N],c[N],Ans;
pii t[N];
LL read(){
    LL su=0,pp=1;char ch=getchar();
    while(ch<'0'||ch>'9'){if(ch=='-')pp=-1;ch=getchar();}
    while(ch>='0'&&ch<='9'){su=su*10+ch-'0';ch=getchar();}
    return su*pp;
}
bool cmp(pii x,pii y){return x.se<y.se;}
void upd(int x,LL k){
    while(x<=n)c[x]=max(c[x],k),x+=x&-x;
    return;
}
LL ask(int x){
    LL sum=0;
    if(x<=0)return 0;
    while(x)sum=max(sum,c[x]),x-=x&-x;
    return sum;
}
int main(){
    T=read();
    while(T--){
        n=read();
        for(int i=0;i<=n;i++)dp[i]=0,c[i]=0;
        for(int i=1;i<=n;i++)
            a[i]=read(),t[i]={i,i+a[i]};
        sort(t+1,t+n+1,cmp);
        int now=1;Ans=0;
        //for(int i=1;i<=n;i++)cout<<t[i].se<<" ";cout<<"\n";
        for(int i=1;i<=n;i++){
            while(now<=n&&t[now].se<i){
                //cout<<t[now].fr<<" add"<<dp[t[now].fr]<<"\n";
                upd(t[now].fr,dp[t[now].fr]),now++;
            }
            //cout<<"find"<<i-a[i]-1<<"!!\n";
            //cout<<ask(i-a[i]-1)<<"??\n";
            dp[i]=ask(i-a[i]-1)+a[i];
            Ans=max(Ans,dp[i]);
            //cout<<"dp["<<i<<"]="<<dp[i]<<"\n";
            //cout<<i<<"\n";
        }
        cout<<Ans<<"\n";
    }
    return 0;
}
伤痕累累的代码(?
总结
前三题做的还是比较快的;D 因为最开始读错题卡了一小会;E 因为最开始在摇一串 \(1\) 一串 \(0\) 这类的情况也浪费了一些时间,遇到这种区间操作还是要尽快想到转化成差分,那就可以转化为单点修改了;F 弄错题意,在写之前没有想清楚,也耗费了一些时间;G 写代码之前也没有想清楚,写了个求前缀和的树状数组,中途也有一些下标打错、使用值出错的地方,还是要把思路理顺再写。
总的来说还好。喵喵喵。
我是读错题大师 .jpg
没事,我把我读错的题都放在这篇总结里了,让我们一起思考一下怎么做吧。
好好听啊我去

 浙公网安备 33010602011771号