
PLM 国产化替代深水区:正视功能差距,走稳研发数据迁移之路
研发数据正从一套系统迁向另一套系统,迁移的从来不只是文件,更是企业的研发底座。 工业软件国产化从 "可选项" 变成 "必答题" 已经不是新闻。但当替代进程推进到 PLM 这类承载企业核心研发数据的系统时,阻力明显变大:办公系统可以一键切换,ERP 能在财务模块试点,而 PLM 里躺着的是十年甚至二十年的图纸、BOM、工艺文件和变更历史,牵动的是全公司研发工程师每天的工作习惯。 信创替代进入深水区,恰恰是从 PLM 这类 "重数据、重习惯、重生态" 的系统开始的。
一、 PLM 国产化替代,为何挑战最为突出
与 OA、邮件、ERP 相比,PLM 替代的特殊性体现在三个维度。 数据复杂度高。PLM 管理的不是结构化表格,而是以非结构化文件为主体、以复杂关联关系为骨架的数据网络。一个零件可能关联三维模型、工程图、技术要求、工艺卡片、变更单等十余类对象,版本间的 "修订 / 派生 / 借用" 关系形成有向图。有工程机械企业梳理存量数据时发现,历史对象超过 800 万个、关系链接超 2 亿条,其中约 7% 存在断链 —— 这类迁移绝不是 "导表" 能解决的。 用户习惯重。工程师的检入检出、变更发起、装配复用件号都是长年形成的习惯。切换后资深工程师前两周效率可能下降 30%~50%,新系统多点两次鼠标,抱怨就会蔓延到管理层。 二次开发多。运行五年以上的 PLM,定制开发人日通常是首次实施的 1.5~3 倍,涉及自定义表单、审批流扩展、CAD/CAE/CAPP 接口等。这些逻辑往往没有完整文档,散落在脚本、触发器和接口里,是最容易被低估的暗礁。
二、 理性审视国产 PLM 现存能力短板
经过近十年发展,国产 PLM 在基础数据管理、流程审批、BOM 管理等 "标准能力" 上与国际主流产品的差距已明显缩小。但四个领域仍存在代际差距,必须客观正视。 大型装配性能是最硬的技术门槛。某重型装备企业测试时,国产产品在 3 万件总装模型下检入耗时是原系统的 4 倍,浏览装配树频繁卡顿。这背后是数据库索引、文件缓存层次、增量检入算法等底层工程能力的差距,不是加硬件能解决的。 CAD 集成深度方面,国产 PLM 对国产 CAD 集成较好,但企业大量使用国际主流三维 CAD,"设计在高端 CAD、管理在国产 PLM" 要求集成层做到属性双向同步、设计上下文传递、轻量化自动转换,目前多数产品只能做到文件级管理。 行业 Know-How 是隐性差距。汽车特殊特性管理、航空构型与有效性管理,是十几年项目沉淀的规则库和模板库,国产厂商积累时间还不够。国际化支持对有海外工厂的企业是刚需,跨境数据包交换、出口管制才是难点。
三、 多元化选型:四类替代实施路径解析
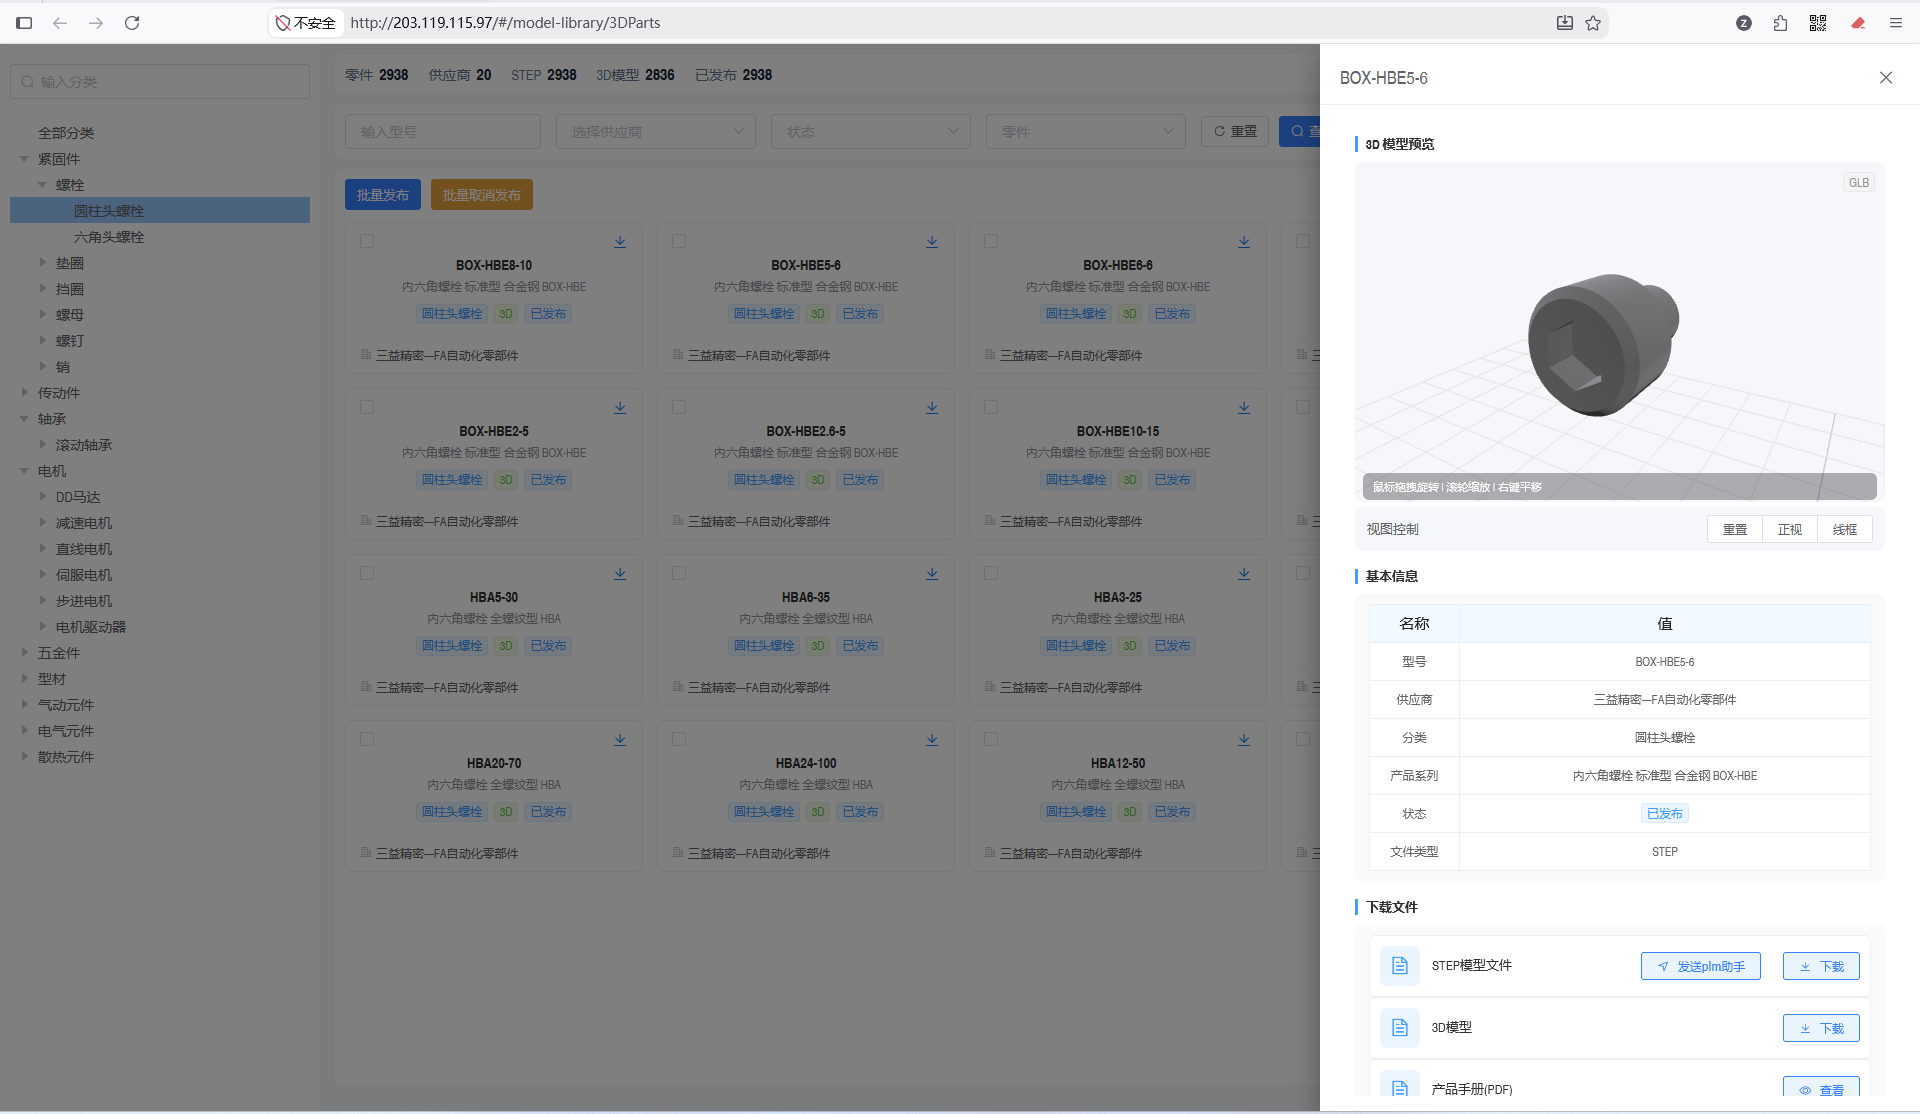
替代不是只有 "推倒重来" 一条路。整体替换适合使用深度浅、历史数据量可控的企业;局部替换先换某一类模块,代价是长期维护两套系统接口;双轨并行新老系统同跑 3~12 个月;新老共存把老系统转为只读归档库,适合迁移成本超过数据剩余价值的场景。 关键判据是三个数字:历史数据对象量、二开人日存量、在线协作用户数。对象量超千万、二开存量超 5000 人日的,建议从双轨并行或新老共存起步。
四、 数据迁移:国产化项目成败核心环节
数据迁移应占替代项目 40% 以上的投入,推荐按 "清洗 — 映射 — 迁移 — 验证" 四步走。 历史数据清洗先做体检:重复件号、无主对象、失效关联、非受控版本,规则要让业务部门确认。映射规则设计要建立对象模型映射表,生命周期状态机逐状态确认,权限模型映射最容易出错。迁移采用 "全量打底 + 增量追赶",脚本支持断点续跑和批次回滚,单批次控制在 1 万~5 万对象。 验证机制缺一不可:技术级要求对象数、文件校验和、关系完整率达到 100%,业务级抽样率不低于 5%,性能级验证大数据量下检索与打开响应。验证不通过必须回滚,不能带病上线。
数据迁完之后,能不能让工程师几秒找回一件沉淀多年的图纸,才是系统真正好用的开始。
五、 定制开发移植与信创生态适配要点
二开移植分三类处理:能用标准功能覆盖的直接改用配置;业务必需但形式不同的,用低代码 / 扩展框架重做;与外部系统的集成接口按规范重写。移植前必须做一次 "定制清单盘点",很多项目盘点后发现 30% 以上的定制其实已经没人用了。 生态适配是信创场景的特殊命题:操作系统层验证文件服务、打印服务、CAD 插件加载;数据库层重点测大对象存储、全文检索、复杂查询性能,BOM 多层展开这类递归查询在不同数据库上性能差可达 5~10 倍。建议先搭完整信创测试床,跑完全部关键场景再定技术路线。
六、 盘活存量:让迁移后的研发数据释放价值
数据迁移只是第一步。当几百万个对象、上亿条关系进入新系统,一个现实问题随之而来:工程师还能不能像在老系统里那样,几秒就找回一件沉淀多年的图纸或 BOM?这正是雁鹏 PLM 三维 AI 智能搜索引擎要回答的问题。 雁鹏 PLM 把 "文件级检索" 推进到 "语义级检索"。它不只搜索文件名和属性字段,而是直接理解三维模型、工程图纸、工艺卡片的内部结构 —— 工程师用一句自然语言描述(比如 "去年那套注塑件的装配顺序"),系统就会跨对象、跨版本地把相关模型、图纸、BOM 和变更记录一并检索出来。在 "设计在高端 CAD、管理在国产 PLM" 的混合环境里,它还能打通 CAD 端三维数据索引,让二维图、三维模型与文档在同一结果页互相关联,无需手动维护检索关键词。 这意味着迁移之后,历史数据不再是沉睡的归档,而是工程师随时可调的研发资产。结合深度 CAD 集成与信创生态适配,雁鹏 PLM 正把 "管理数据" 和 "用好数据" 拉进同一个闭环。
七、 落地推广:用户适配与项目效果评估体系
用户接受度决定成败。建议按 "种子用户 — 部门推广 — 全员切换" 三波推进,培训按角色分层、实操不少于 4 学时,设立并行期激励,收集高频抱怨建立周改进清单 —— 切换后第一个月的改进响应速度直接决定项目口碑。 替代效果不能只看 "上线了没有",建议跟踪数据完整率(迁移验证通过率≥99.9%)、效率指标(6 个月恢复至基线 ±10%)、系统健康度(MTTR<2 小时)、自主可控度和用户满意度五类指标,按 18~30 个月分阶段推进。
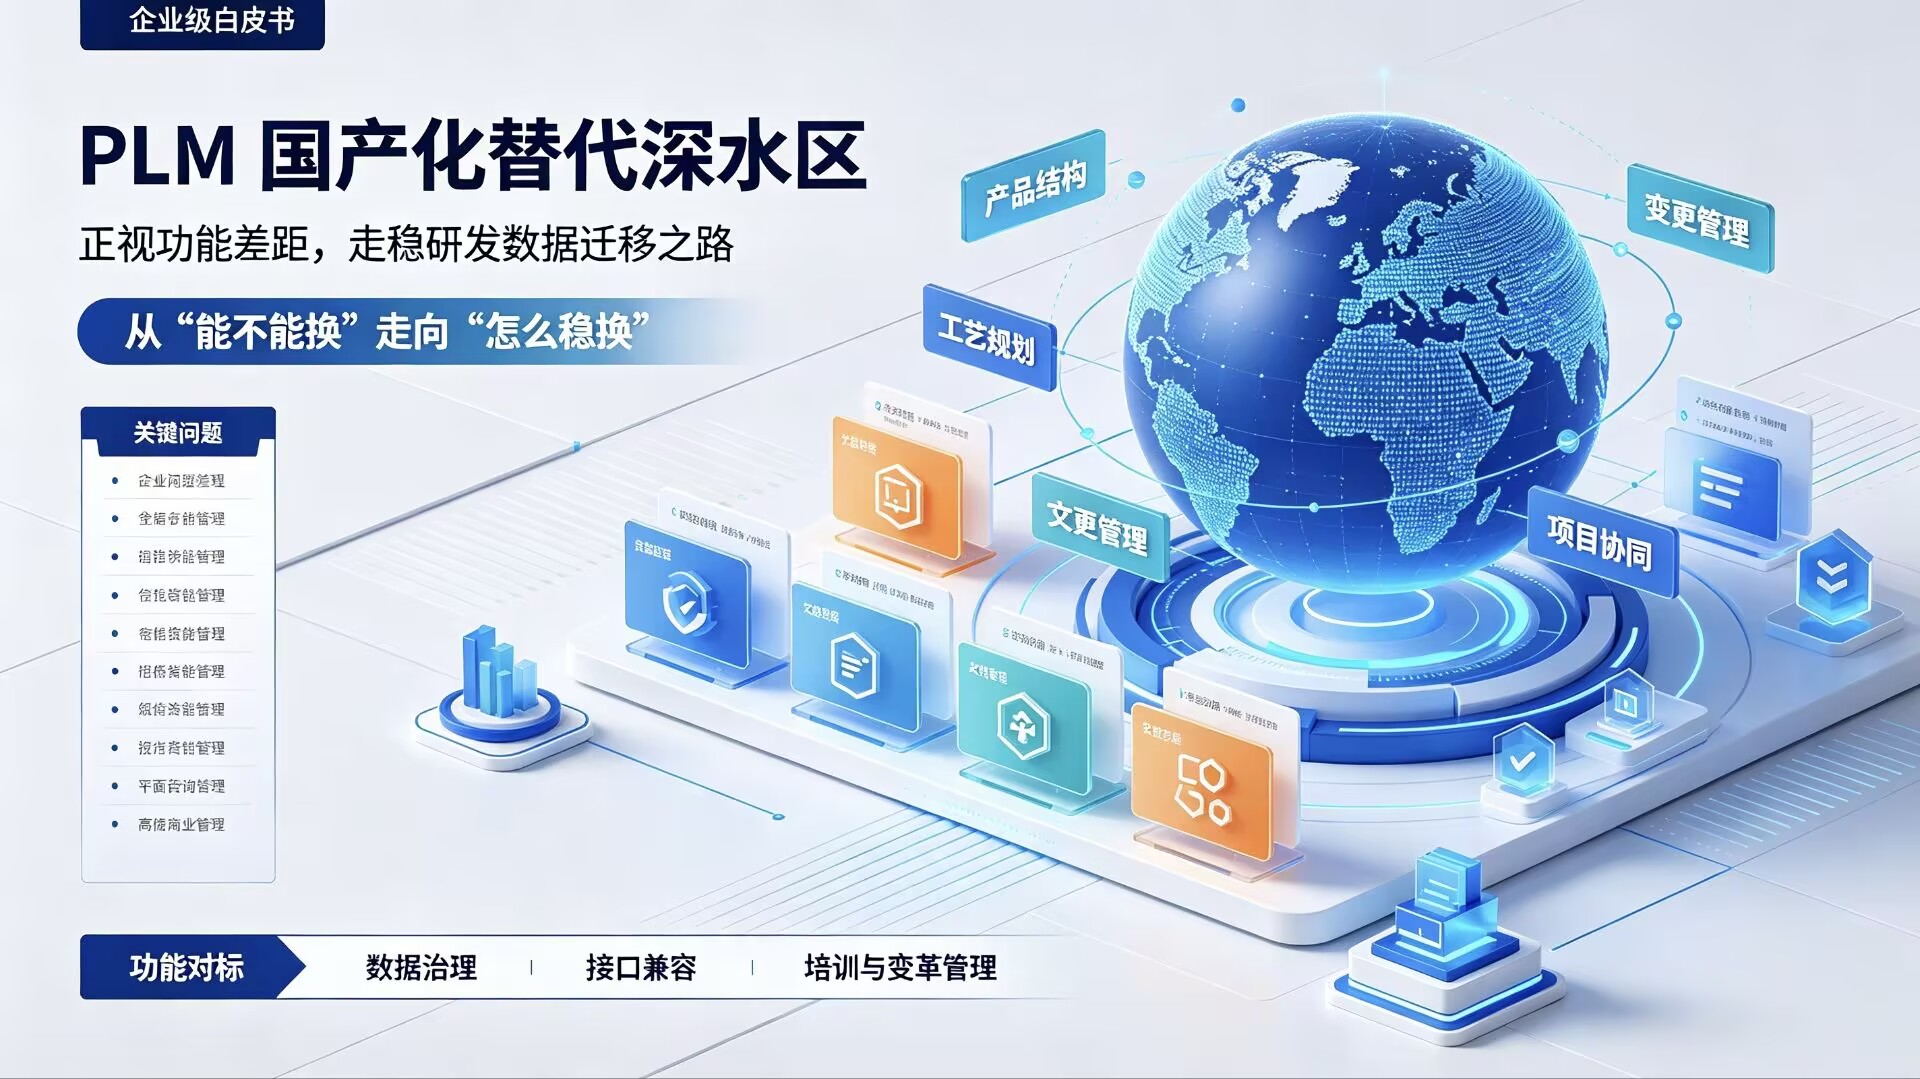
PLM 的信创替代不是一次软件采购,而是一场以数据为核心、以习惯迁移为难点、以生态适配为变量的系统工程。承认差距不丢人,回避差距才烧钱。把数据迁移做扎实、把二开盘点做彻底、把用户当队友,替代的深水区是可以安全渡过的。 当越来越多的制造企业把这份功课做到位,雁鹏 PLM 也在用三维 AI 检索、深度 CAD 集成与扎实的信创适配,帮他们真正 "掌握自己的研发数据底座"—— 替代完成之后值得骄傲的,从来不是换了一个 logo,而是企业第一次完全掌控了自己的研发数据。
联系方式:02089810161
网址:https://www.epon-soft.com/
 浙公网安备 33010602011771号