
【最小生成树】MST(Kruskal算法,Prim算法)
前言
此乃小 Oler 的一篇算法随笔,从今日后,还会进行详细的修订。
一、简单介绍(MST)
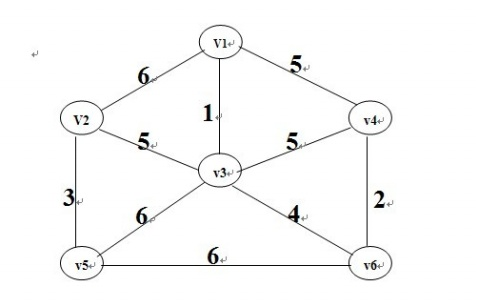
在一给定的无向图 \(G=(V,E)\) 中, \((u,v)\) 代表连接顶点 \(u\) 与顶点 \(v\) 的边,而 \(w(u,v)\) 代表此边的权重,若存在 \(T\) 为 \(E\) 的子集且为无循环图,使得连通所有结点的的 \(w(T)\) 最小,则此 \(T\) 为 \(G\) 的最小生成树。
最小生成树其实是最小权重生成树的简称。
二、概念 and 性质 and 证明
概念
最小生成树:
-
生成树:一个连通图的生成树包含图的所有顶点,并且只含尽可能少的边。对于生成树来说,若砍去它的一条边,则会使生成树变成非连通图;若给它增加一条边,则会形成图的一条回路。
-
最小生成树:对于一个带权连通无向图 \(G=(V,E)\) ,生成树不同,每棵树的权(即树中所有边上得权值之和)也可能不同。设 \(R\) 为 \(G\) 的所有生成树的集合,若 \(T\) 为 \(R\) 中边的权值之和最小的那棵生成树,则 \(T\) 称为 \(G\) 的最小生成树(Minimum-Spanning-Tree,MST)。
性质
-
最小生成树不是唯一的,即最小生成树的树形不唯一, \(R\) 中可能有多个最小生成树。当图 \(G\) 中的各边权值互不相等时, \(G\) 本身是一棵树时,则 \(G\) 的最小生成树就是它本身。
-
最小生成树的边的权值之和总是唯一的,虽然最小生成树不唯一,但其对应的边的权值之和总是唯一的,而且是最小的。
-
最小生成树的边数为树的顶点减 \(1\) 。
说明
MST性质:
- 设 \(G=(V,E)\) 是一个连通网络,\(U\) 是顶点集 \(V\) 的一个非空真子集。若 \((u,v)\) 是 \(G\) 中一条“一个端点在 \(U\) 中(如, \(u \in U\) ),另一个端点不在 \(U\) 中的边(如, \(v \in V-U\) ),且 \((u,v)\) 具有最小权值,则一定存在 \(G\) 的一棵最小生成树包括此边 \((u,v)\) 。
证明
为方便说明,先作以下约定:
①. 将集合 \(U\) 中的顶点看作是红色顶点;
②. 而 \(V-U\) (即非子集内的顶点)中的顶点看作是蓝色顶点;
③. 连接红点和蓝点的边看作是紫色边;
④. 权最小的紫边称为轻边(即权重最“轻”的边)。
于是,MST性质中所述的边 \((u,v)\) 就可简称为轻边。
用反证法证明MST性质:
假设 \(G\) 中任何一棵MST都不含轻边 \((u,v)\) 。则若 \(T\) 为 \(G\) 的任意一棵MST,那么它不含此轻边。
根据树的定义,则 \(T\) 中必有一条从红点 \(u\) 到蓝点 \(v\) 的路径 \(P\) ,且 \(P\) 上必有一条紫边 \((u',v')\) 连接红点集和蓝点集,否则 \(u\) 和 \(v\) 不连通。当把轻边 \((u,v)\) 加入树 \(T\) 时,该轻边和 \(P\) 必构成了一个回路。删去紫边 \((u',v')\) 后回路亦消除,由此可得另一生成树 \(T'\) 。
\(T'\) 和 \(T\) 的差别仅在于 \(T'\) 用轻边 \((u,v)\) 取代了 \(T\) 中权重可能更大的紫边 \((u',v')\) 。因为 \(w(u,v) \le w(u',v')\),所以 \(w(T')=w(T)+w(u,v)-w(u',v')\leq w(T)\)
即 \(T'\) 是一棵比 \(T\) 更优的MST,所以 \(T\) 不是 \(G\) 的MST,这与假设矛盾。
所以,MST性质成立。
三、代码实现
Prim 算法
I.初始化
\(acrs_{i,j}=+\infty\) :表示顶点 \(i\) 到顶点 \(j\) 的边权值。
\(dist_i=+\infty\):表示顶点 \(i\) 在真最小生成树中离它最近的节点的距离。
\(f_i=false\) :表示顶点 \(i\) 是否已经在最小生成树中。
II.算法流程
-
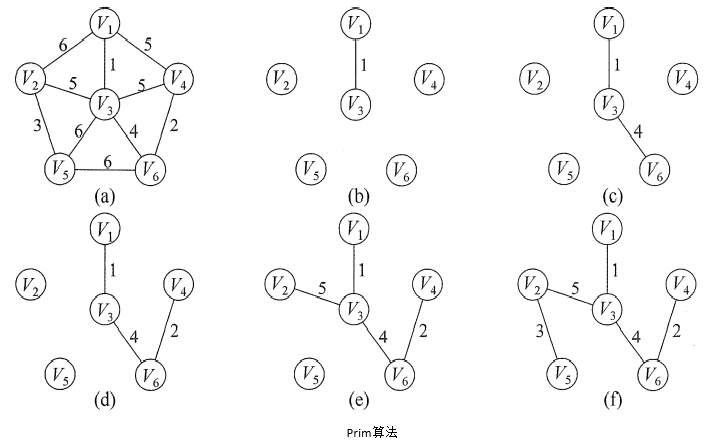
从图中任取一顶点加入树 \(T\) ,此时树中只含有一个顶点;
-
之后选择一个与当前 \(T\) 中顶点集合距离最近的顶点,并将该顶点和相应的边加入 \(T\) ;
-
每次操作后 \(T\) 中的顶点树和边数都增加 \(1\) ,并且把边权值加入记录权总和的 \(res\) 中。
-
以此类推,直至图中所有顶点都并入 \(T\),得到的 \(T\) 就是最小生成树,此时 \(T\) 中必然有 \(n-1\) 条边,若原本的图属于非连通图,那必然也会有若干个顶点无法找到依附于它的顶点,直接返回 \(\infty\) 。
Code(加点大法)
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int oo=0x3f3f3f3f;
const int N=520;
int n,m,s,u,v,w,res;
int dist[N],arcs[N][N];
bool f[N];    //标记数组标记点是否已经在生成树集合中
void prim() {
	dist[s]=0;
	for(int i=1;i<=n;i++) {
		int t=-1;
		for(int j=1;j<=n;j++) {    //选择最小距离的点
			if(!f[j]&&(t==-1||dist[j]<dist[t]))
				t=j;
		}
		if(dist[t]==oo) {
			res=oo;
			return ;
		}
		res+=dist[t];
		f[t]=1;
		for(int k=1;k<=n;k++) {    //更新最小距离
			if(f[k]==0&&dist[k]>arcs[t][k])
				dist[k]=arcs[t][k];
		}
	}
	return ;
}
signed main() {
	scanf("%lld%lld",&n,&m);
	memset(dist,oo,sizeof dist);
	memset(arcs,oo,sizeof arcs);   //初始化
	while(m--) {
		scanf("%lld%lld%lld",&u,&v,&w);
		arcs[u][v]=arcs[v][u]=min(arcs[u][v],w);   //输入权值取最小
	}
	s=1;
	prim();
	if(res==oo) printf("impossible\n");
	else printf("%lld\n",res);
	return 0;
}
Prim+堆优化 算法
Prim 的堆优化和 Dijkstra 的堆优化差不多。
I.邻接表存图
由于要使用到优先队列堆优化 Prim 的时间运行效率,在访问时遍历其相邻的边即可,所以只需要用到邻接表来存图。
struct Node {
	int to,w,nxt;
	Node() {
		to=nxt=w=0;
	}
	Node(int a,int b,int c) {
		to=a;
		nxt=b;
		w=c;
	}
}adj[N];
这确实非常容易理解,不必多说了。
II.流程
-
将优先队列定义成小根堆,优先队列元素为 \(pair<int,int>\) ,其中第一个元素含义为图中顶点 \(v_i\) 到真最小生成树中最近的节点 \(j\) 的距离 \(dist_j\) ,第二个元素为节点编号 \(v_j\) 。
-
初始化:\(dist_i=\infty\)
-
将源点 \(dist[v_0]\) 设置成 \(0\) ,并将 { \(dist[v_0],v_0\) } 放入优先队列。
-
去取出栈顶的元素,如果,堆顶节点 \(v_j\) 已经在集合 \(T\) 中,则舍弃该顶点,再次取出堆顶元素,否则把该节点 \(v_j\) 加入集合 \(T\) 中,修改从顶点 \(v_j\) 出发到集合 \(T\) 内最近的节点 \(v_k\) 的可达最短长度 \(dist[k]\) ;若 \(dist[k]>value<j,k>\) 则更新 \(dist[k]=value<j,k>\),其中 \(value<j,k>\) 代表 \(v_j\) 到 \(v_k\) 的边权值。并把节点 { \(dist[k],k\) } 加入队列当中。
Code2(堆优化大法)
#include<bits/stdc++.h>
#define int long long
#define M(x,y) make_pair(x,y)
using namespace std;
typedef pair<int,int> pll;    //稀疏图用邻接表来存
const int oo=0x3f3f3f3f;
const int N=1e6+10;
int n,m,s,x,y,z;
struct Node {
	int to,w,nxt;
	Node() {
		to=nxt=w=0;
	}
	Node(int a,int b,int c) {
		to=a;
		nxt=b;
		w=c;
	}
}adj[N];
int head[N],idx;
int dist[N],res;
int cnt;
bool st[N];    //如果true说明这个顶点i在集合T中
priority_queue<pll,vector<pll>,greater<pll> >heap;
inline void add(int x,int y,int z) {
	adj[++idx]=Node(y,head[x],z);
	head[x]=idx;
}
void prim() {
	for(int i=1;i<=n;i++)
		dist[i]=oo;
	dist[s]=0;
	heap.push(M(0,s));     //这个顺序不能倒
	while(!heap.empty()&&cnt<n) {
		pll k=heap.top();     //取不在集合T(V-T)中距离最近的点
		heap.pop();
		int u=k.second;
		int distance=k.first;
		if(st[u]) continue;
		cnt++,res+=distance;
		st[u]=1;        //把该点加入集合T
		for(int i=head[u];i;i=adj[i].nxt) {
			int v=adj[i].to,w=adj[i].w;     //取出和u相连的点和边权
			if(dist[v]>w) {
				dist[v]=w;     //更新最短距离
				heap.push(M(dist[v],v));     //放入优先队列中
			}
		}
	}
	return ;
}
signed main() {
	scanf("%lld%lld",&n,&m);
	while(m--) {
		scanf("%lld%lld%lld",&x,&y,&z);
		add(x,y,z),add(y,x,z);
	}
	s=1;
	prim();
	if(cnt!=n) printf("impossible\n");    //顶点个数不为n,构造不符,直接输出impossible
	else printf("%lld\n",res);      //反之,输出最小生成树的权和
	return 0;
}
Kruskal 算法
I.初始化 & 预处理
\(fa_i=i\) :表示顶点 \(i\) 当前所指向的父亲节点,用于并查集中。
II.并查集
此算法需要用到并查集进行判环,为了优化时间复杂度,我们需要对其进行松弛操作。
int findp(int x) {
	if(fa[x]==x) return x;
	return fa[x]=findp(fa[x]);
}
这里也就不多讲了,如需深入了解并查集的,博主亲自推荐自家的博客。
III.算法流程
-
初始时只有 \(n\) 个顶点而无边的非连通图 \(V \in T\) ;
-
由于本算法的思想是每次找最短的边权值进行更新操作,储存完图后,每个顶点自成一个连通分量,然后按照边权从小到大排序;
-
不断选取当前未被选取过且权值最小的边,若该边依附的顶点落在 \(T\) 中不同的连通分量上,则将此边加入 \(T\) ,否则舍弃此边而选择下一条权值最小的边;
-
再依次类推,直至 \(T\) 中所有顶点都在一个连通分量上。

IV.Code3(加边大发)
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=1e6+10;
int n,m,res,cnt;
struct Edge {
	int x,y,z;
}edge[N];
int fa[N];
void init_() {
	for(int i=1;i<=n;i++)
		fa[i]=i;
}
bool cmp(Edge x,Edge y) {
	return x.z<y.z;
}
int findp(int x) {     //并查集找祖先
	if(fa[x]==x) return x;
	return fa[x]=findp(fa[x]);
}
void kruskal() {
	for(int i=1;i<=m;i++) {
		int u=edge[i].x;
		int v=edge[i].y;
		int w=edge[i].z;
		int xp=findp(u);
		int yp=findp(v);
		if(xp!=yp) {     //是否存在环
			res+=w;
			cnt++;
			fa[xp]=yp;
		}
	}
	return ;
}
signed main() {
	scanf("%lld%lld",&n,&m);
	init_();
	for(int i=1;i<=m;i++)   //储存图
		scanf("%lld%lld%lld",&edge[i].x,&edge[i].y,&edge[i].z);
	sort(edge+1,edge+m+1,cmp);    //从小到大排序
	kruskal();
	if(cnt!=n-1) printf("impossible\n");
	else printf("%lld\n",res);
	return 0;
}
三、总结
-
Prim 算法,主要思想在于遍历时对每个点寻找最近的顶点进行更新,时间复杂度为 \(O(n^2)\) ,适用于稠密图。
-
Kruskal 算法,主要的流程时每次对于图中任意一点找与其的连边中最小的边权,因可能出现环,所以再用并查集 \(O(n)\) 来判环;预处理时 \(O(m \log m)\) 把边从小到大排序,所以总的时间复杂度为 \(O(n+m \log m)\) ,适用于稀疏图。
-
Prim 若加上堆优化的话时间复杂度为 \(O(n \log m)\) ,但代码量相较麻烦,时间复杂度和 Kruskal 算法差不多,一般选用 Kruskal 。
-
注:\(n\) 为图中的顶点数目,\(m\) 为图中边的数量。
题库
古有人云: 听君一席话,胜读十年书
此处留下我的入门练习题单洛谷【最小生成树】 ID:970993

 浙公网安备 33010602011771号