
模拟赛总结
- 2024.9.22 PYYZOJ
- 2024.9.24 33dai
- 2024.9.25 线下
- 2024.9.26 33dai
- 2024.9.28 代码源
- 2024.10.4 PYYZOJ
- 2024.10.5 代码源
- 2024.10.6 PYYZOJ
- 2024.10.9 33dai
- 2024.10.11 33dai
- 2024.10.12 代码源
- 2024.10.13 核桃OJ
- 2024.10.14 33dai
- 2024.10.16 PYYZOJ
- 2024.10.18 33dai
- 2024.10.19 代码源
- 2024.10.21 33dai
- 2024.10.22 PYYZOJ
- 2024.10.24 PYYZOJ
- 2024.10.29 PYYZOJ
- 2024.10.30 PYYZOJ
- 2024.11.01 核桃OJ
- 2024.11.02 代码源
- 2024.11.04 PYYZOJ
- 2024.11.05 核桃OJ
- 2024.11.06 33dai
- 2024.11.08 33dai
- 2024.11.09 代码源
- 2024.11.12 代码源
- 2024.11.13 33dai
- 2024.11.14 代码源
- 2024.11.16 代码源
- 2024.11.19 代码源
- 2024.11.20 33dai
- 2024.11.21 代码源
- 2024.11.23 代码源
NOIP模拟赛
2024.9.22 PYYZOJ
正因为没有翅膀,人们才会寻找飞翔的方法。
——《排球少年》
T1 挺基础的,但是感觉自己也没有多么十拿九稳?题解写了个单调队列优化,自己可能对这个不太熟练,直接码了个线段树😐,这题用单调队列优化写的快,跑的还快。
发现可以预处理出以 \(i\) 为结尾的最短匹配区间,然后设 \(f_{i,j}\) 为已经考虑到第 \(i\) 个字母,上一个替换的是 \(j\) 转移:
每层转移区间覆盖,单点修改,全局查询。
T2 考场上写了个并查集,但是最后才发现假了,像RZ一样,稍微动动脑子的就很难写对。
并查集太玄妙了,至今不太懂,写个线段树做法的。
根据题意,发现结构是森林,每次向一棵树上连一个子树,子树里活着的如果想继续活着,有 \(\frac{1}{3}\) 的概率,而原本的树想要活着有 \(\frac{2}{3}\) 的概率,把树拍成 \(dfn\) 序后,直接区间乘即可。
要是加入新的子树时,\(u\) 的子树还有没加进去的怎么办?这里需要用到一个 \(trick\)。确定 \(dfn\) 序时,可以按加子树的顺序遍历子树,这样需要区间乘的时候,编号就是连续的了(考场上SB了,这种小细节都想不清楚,曹操了)。
T3 直接大力写了 \(4\) 棵线段树,喜提 \(TLE\),挂了 \(40\) 分。但凡好好想想,把前两棵线段树换成 \(set\) 就 \(A\) 了,该有的卡常意识还是得有的,算是长教训了,能把线段树换掉的就换掉。
考虑第一次出现的数才会产生贡献,修改直接改第一次出现的数就可以了。
设当前这个数的下标为 \(i\),下一个与 \(a_i\) 相等的数为 \(nxt_i\) 。分情况讨论:
改成 \(1\le j< i\) 答案会减少 \(\frac{(i+nxt_i-1)(nxt_i-i)}{2}\)。
改为 \(i<j<nxt_i\) 答案会减少 \(\frac{(j+nxt_i-1)(nxt_i-j)}{2}\)。
可以进一步对式子化简,\(2\) 个 \(set\),\(2\) 个树状数组维护是目前最快的。
T4 比赛的时候,题都没时间看,这题感觉看了也不太能做的样子,需要观察总结性质。
旋转本质上是方向和模 \(4\) 相等,只需对每个方向赋一个 \(0~3\) 的权值即可。相邻的左脚右脚连边,跑一个左脚和右脚的二分图最大匹配。如果匹配的鞋的个数和总的鞋个数不相等,可以把剩下的没有匹配的鞋任意旋转,使得匹配的方向和模 \(4\) 和原图相等,直接就是答案;如果匹配的鞋的个数和总的鞋个数相等,和相等就是答案,不相等需要去掉一个匹配。
2024.9.24 33dai
真正重要的东西,总是没有的人比拥有的人清楚。
——《银魂》
T1 贪心太难了,根本不是我这种不爱动脑子的人做的,虽然差点就贪对了😅。
每个人是可以来回 \(\lfloor\frac{h_i-1}{2}\rfloor\) 的,这个来回是得是去了,然后回来又去了,所以需要减 \(1\)。能不能全部送过去有个充要条件就是 \(\frac{\sum{min(a_i, S)}}{L}\cdot(R-L)\ge n-R\) 其中 \(S\) 是需要运送多少次,\(a_i\) 是 \(i\) 这个人能来回多少次,然后这题就做完了。硬控我两个小时,最后还是个假的。
T2 这题纯纯的构思,树形 \(DP\),然后在环上做个线段树优化,然后下传答案。
T3 比赛的时候差点就做出来了,但是自己却把自己的想法否决了,也没仔细想想,凭直觉觉得自己的正解想法不对。
或和与直接在 \(Trie\) 上做合并就行了,异或打个标记,交换左右儿子即可。然后就做完了。考虑每合并完一个节点,除了下次再加进去,否则它的父亲节点只有它这一个儿子。注意给是否有 \(0/1\) 打个标记,补题的时候没加,过了,只能说数据太水了。
T4 hard
考虑一个数会被贡献多少次,顺便更改一下分割点的定义,我们把第 \(i\) 个位置和第 \(i+1\) 个位置中间的那条缝叫做第 \(i\) 个分割点,容易发现这样定义是不改变答案的。那么第 \(i\) 的位置的贡献其实就是第 \(i-1\) 个分割点和第 \(i\) 个分割点出现的时间的最大值。即设第 \(i\) 个分割点出现的时间为 \(t_i\),第 \(i\) 个位置的贡献就是 \(\max(t_{i-1}, t_i)\)。
\(t_i\) 其实就是 \(1\)~\(i\) 的数都出现在 \([1,i]\) 中的时间,考虑每进行一次冒泡排序,对于一个 \(i>a_i\) 的数就会往前移动一位,设 \(p_i\) 为小于等于 \(i\) 的数的最大位置,所以 \(t_i=p_i-i\),原本的 \(\max(t_{i-1}, t_i)\) 变成了 \(\max(p_{i-1}-i+1, p_i-i)\)。那总的贡献就是:
其实可以再把贡献拆一下,对于第 \(i\) 个位置,什么时候可以贡献 \(p_{i-1}-i+1\),什么时候可以贡献 \(p_i-i\)。枚举一下 \(p_{i-1}\) 或者 \(p_i\),然后组合数算一下其它位置可以填什么。
这两个式子作和:
我们把含 \(i\) 和 \(j\) 的式子分开求解:
把组合数拆开进一步化简:
直接算就可以了,时间复杂度 \(O(n)\)。
2024.9.25
T1
T2
T3 这题做法太巧妙了,感觉自己能想到,但是却没想到。
从 \(1\)~\(n\) 把每个节点相连的点拿出来,形成一个全新的序列,这个序列与原序列有多对一的映射关系。
考虑对这个新序列分块,然后分类讨论。
修改的散块 \(\longrightarrow\) 询问的散块
直接暴力扫修改的散块修改了哪些数,然后对询问暴力加就行。
修改的散块 \(\longrightarrow\) 询问的整块
预处理 \(f_{i,j}\) 表示第 \(i\) 个块与前 \(j\) 个位置的贡献,那么询问的时候枚举块 \(i\) 就能得到贡献。
修改的整块 \(\longrightarrow\) 询问的散块
修改的整块 \(\longrightarrow\) 询问的整块
T4
2024.9.26 33dai
T1 硬控我两个小时,打比赛脑子是不转的。
需要将交换这项操作的实质看出来,其实就是对 \(f(a)\),\(f(b)\) 分别异或 \(a_i\) \(xor\) \(b_i\),这样就使交换这个操作可以维护出来了,直接线性基就行了。
T2 每次取的 \(a_i\) 都比之前的和大,这样取一定是成倍数增长的,也就是最多取 $\log $ 个数。比赛的时候一点也没往这想😭。
这样就可以 区间 \(DP\) 了,时间复杂度是 \(O(n\log ^2n+q\log ^3n)\)。卡卡常,把 \(DP\) 换成 \(dfs\) 就过了。
T3 状压 \(DP\) 没想到是这场比赛最难的题😅。
这题就是求让整个图强连通的最小代价。设 \(f_{S,t,s,0/1}\) 表示已经走了 \(S\) 集合中的点,终点为 \(t\),现在已经在 \(s\),现在已经走了超过两给点或刚走一个点。没太消化,不往下写了,再看的时候自己想想吧😀。
T4 最不适合我这种 \(SB\) 做的,先需要转化一步的题。
发现 \(a_i\),\(b_i\) 贡献其实是可以拆开的。如果江桥的 \(A\)(第一面的数值),小于 \(a_i\) 或 \(b_i\) 都会产生 \(-\frac{w_i}{4}\) 的贡献,如果大于等于就会产生 \(\frac{w_i}{4}\)。\(B\) 是同理的。所以说枚举 \(A\),\(B\) 的时候直接树状数组搞一下就 \(45\) 了(竟然没想到可以分开算贡献,\(SB\) 的写了个二维前缀和😀)。
考虑优化。贡献式子长这样 \(Sum_i+Sum_j-c_i\cdot c_j\)。\(i\),\(j\) 对应离散化数组的下标,\(c_i\) 就是 \(A\),\(c_j\) 就是 \(B\)。到这里会发现你把任意一个加到李超树里,直接查询就行了。不过还有更简单的实现方式,这玩意是满足决策单调性的😦。
2024.9.28 代码源
T1 秒了😊
换根 \(DP\),设 \(f_{u,0/1/2}\) 分别表示: \(u\) 是第一个删的点的答案;在 \(u\) 的子树中,删到 \(u\) 的最大答案和次大答案。直接换根就行了,感觉没啥难的,防止自己以后想不起来了,还是写一下转移吧
为了严谨,式子写的史了一点😅
T2 秒了😊
算出每个点可以贡献的区间,对于相同两个数,可以在处理左端点的时候可以相等,右端点时必须严格小于即可。树状数组、笛卡尔树都可以做。
二分找第 \(L\) 和 \(R\) 小的数,然后用优先队列对所有可能的答案,一个个往外取,取 \(R-L+1\) 个就行了。
T3 做不出来一点,不过这种题必须得会,今天写下来希望下次见了能做出来。
考虑容斥。
T4 仔细思考什么时候一个人能活下来,感觉也不是很难。
考虑剪刀,前面和后面都得清空,什么时候会清空呢?
其实只有三种情况:
1.开头是布
2.结尾是布
3.出现\(...\)石头\(...\)布\(...\)石头\(...\)的结构
布和石头是类似的,于是这题就做完了。
2024.10.4 PYYZOJ
T1 现在是 2024年10月9日,我已经忘了当时的心境了,不过看 \(k\) 的范围是能感觉到这道题是可以倍增的。
设 \(f_{i,j}\) 表示 \(S\) 从第 \(j\) 个位置开始匹配,匹配 \(2^i\) 个 \(T\) 总共用了多少个 \(S\)。\(g_{i,j}\) 表示 \(S\) 从第 \(j\) 个位置开始匹配,匹配 \(2^i\) 个 \(T\) 匹配到 \(S\) 的哪个位置。转移如下:
T2 场切,开心😋
先分讨,得到暴力,然后再分讨,得到正解。
T3 牛魔的,三个子树的启发式合并就不会了是吧🤬。
先考虑两个点。求模 \(L\) 意义下的最大值,好像没有什么太能做的算法,能想到的比较暴力的就是把其中一个点的距离放序列里,然后枚举一个点,得到距离后在序列里二分一下。
这题也可以这么做,先把较大的子树里的所有距离放序列里,排完序后,枚举另外两个子树里的距离,加起来再在序列里二分,这样就可以更新这两个子树的点了。然后反过来枚举两个较小子树的点,把距离加到序列里,然后再枚举较大子树的点,再在序列里二分,更新较大子树的点的答案。
T4 还没补😭。
2024.10.5 代码源
T1 \(bfs\) 就行了,可能需要稍微灵活一点,把 \(queue\) 换成关键字是时间的 \(priority-queue\)就行了。
T2 最伤心的一集,明明已经想到很多了,要是当时头脑清醒一点就好了。
直接钦定 \(a_i=a_n-d_i\) 或 \(a_i=d_i-a_n\) 那么 \(\sum_{i=1}^na_i\) 就等于
\(kn+\sum_{i=1}^n\pm d_i\),显然我们让它小于 \(S\),且在模 \(n\) 意义下等于 \(S\) 就可以了。
设 \(f_{i,j}\) 表示考虑了前 \(i\) 个数,在模 \(n\) 意义下和为 \(j\) 的和的最小值,转移考虑每个 \(d_i\) 取正取负即可。同时为了还原每个数,记一下从哪里转移过来的,最后整体加 \(k\) 使得 \(f_{n, i}+kn=S\) 就行了。
T3 这种题直接做是很难做的,需要先把题面翻译一下。这题实质上是说,第一个序列选前 \(i\) 个,第二个序列选前 \(j\) 个,使得 \(i-\)配给第一个序列的个数\(=X\),\(j-\)配给第二个序列的个数\(=Y\),配给第一个序列的个数\(+\)配给第二个序列的个数\(=\)前\(i,j\)中重复出现的数的个数 的方案数。
还是没太有清晰的思路,冷静思考一下,发现其实有几个数需要分配是可以算出来的,设 \(cnt_{i,j}\) 表示前 \(i,j\) 中重复出现的数的个数,待分配的数的个数就是 \(cnt_{i,j}-(i-X)-(j-Y)\),翻译成白话就是第一个序列往后多加了 \(i-X\) 个数,即有 \(i-X\) 个重复出现的数分配给了第一个序列;第二个序列往后多加了 \(j-Y\) 个数,即有 \(j-Y\) 个重复出现的数分配给了第二个序列。思路一下明了了,当 \(cnt_{i,j}-(i-X)-(j-Y)>0\) 时:
考虑进一步优化,我们从 \(X\) 到 \(n\) 枚举 \(i\),发现能贡献答案的 \(j\) 是单调不升的,能贡献答案即 \(cnt_{i,j}-(i-X)-(j-Y)=0\)。那么小于 \(j\) 的 \(cnt_{i,j}-(i-X)-(j-Y)>0\),大于 \(j\) 的 \(cnt_{i,j}-(i-X)-(j-Y)<0\)。
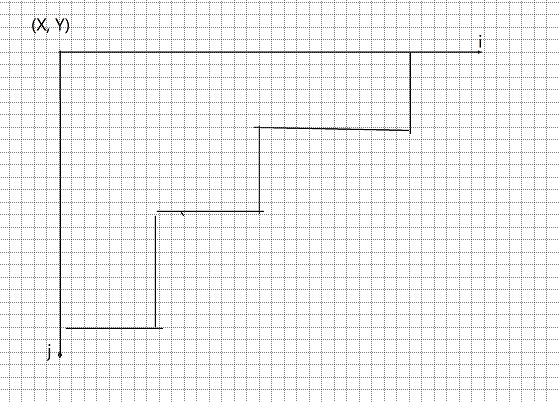
用双指针处理一下,然后类似路径计数的求就行了,需要注意的是已经碰到轮廓线就不能再走了,若以有时能走的步数要少一步。
T4 这题有点神奇。
加入一条边 \((x,y)\) 的贡献是:
分别算 \(x\) 和 \(y\) 的贡献:
枚举一个 \(x\) 因为需要取一个 \(max\),考虑把 \(A\) 放到一个桶里,存一个个数,存一个和。然后前缀和优化一下就行了。
2024.10.6 PYYZOJ
T1 不好好看样例,自己瞎几把分类讨论导致的。
打表看样例得,隔一行然后一行全零或隔一列然后一列全零。
先考虑隔一行然后一行全零的情况,判断每一行是哪种类型即可,要么全零,要么\(01\) 交替, 要么 \(10\) 交替。
隔一列然后一列全零的同理。
T2 数的种类数不会超过 \(4\) 个。颜色分布类似于中间一段区间顶上界或顶下界,左边全是一个数,右边全是一个数。发现这些性质转移就很简单了,预处理前缀和后缀全是一个数的方案数,设 \(f_{i,j,k,0/1}\) 表示考虑到第 \(i\) 个数其中一个界不管是上界还是下界是 \(j\),另一个是 \(k\),有没有选过这个 \(k\)。
转移挺神奇的,感觉这种转移的 \(DP\) 有难度又可做,但是不一定敢做。优化的话需要用一个 \(trick\) 就是只有 \(O(m)\) 个数会转移到,也只有 \(O(m)\) 数会被转移到,这样 \(O(n)\) 就变成了 \(O(m)\) 了。
T3
T4
2024.10.9 33dai
T1 被卡常卡成 20 了,曹操🤬。
从每个根据地开始 \(bfs\),记一下到每个点的最小距离,和从哪个根据地转移过来的,分别设为 \(dis_{i,j}\),\(vis_{i,j}\)。
如果走到一个之前走到过的点,就把两个 \(vis\) 并查集一下,最后如果只有一个连通块,这时的 \(dis\) 就是答案,需要注意的是,它不仅要去一下较大值,还得判一下相等的时候。
T2 用 \(fflush(stdout)\) \(50\to0\)🤬。归并排序,但是不会最后交换,\(100\to50\)。
T3 考虑从前 \(i\) 个牌里选 \(n_1\) 个填 \(A\),再选 \(j\) 个填 \(B\),\(i-n_1-j\) 个 \(C\),要求 \(j\le n_2,i-n_1-j\le n_3\),即 \(i-n_2-n_3\le j\le n2\)。于是我们就有了 \(70\) 分的好成绩。
\(\sum_{j=\max(0,i-n_2-n_3)}^{n_2}\binom{i-n_1}{j}\) 这个式子感觉就很可以优化,但是它的优化方式又很与众不同。考虑把这个式子记为 \(sum_i\),\(2sum_2\) 可以化成 \(\binom{i+1-n_1}{i+1-n_1-n_3}+\binom{i+1-n_1}{i+1-n_1-n_3+1}+...+\binom{i+1-n_1}{n_2}+\binom{i-n_1}{i-n_1-n_3}+\binom{i-n_1}{n_2}\),把后两项减掉不就是要求的 \(sum_{i+1}\) 了吗。
T4 \(n=2\) 显然就是一个卡特兰数,考虑有没有类似卡特兰数但是能求好几维的东西,还真有,但是我不会😄。
这题就是个杨表,可以用勾长公式直接求解:
不想解释了,贴个图举个例子就明白了。
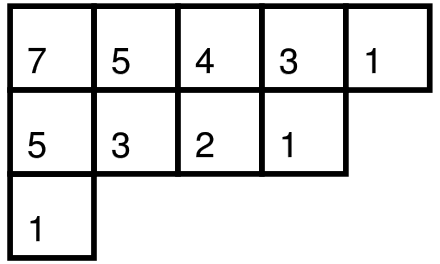
这张图的格子里的数就是这个格子的勾长,对于这个图的方案就是 \(\frac{10!}{7\cdot5\cdot4\cdot3\cdot5\cdot3\cdot2}=288\)。
2024.10.11 33dai
T1 考虑什么时候 \(f_i\) 会更新,是前面小于 \(a_i\) 的 \(f_j\) 更新来的,那我们让它从我们想让它更新的地方更新。首先相同的 \(f\) 对应的 \(a\) 是要递减的,这样就不会使 \(f+1\),我们还不能让它从比 \(f\) 大的地方更新,那就要求我们从 \(f\) 小的填到大的。还得判断前面有没有 \(f-1\),有的话,它肯定会比 \(f\) 填的早。
T2 根号分治,分治真是充满了人类智慧🤯。
首先第 \(k\) 小值,\(k\) 很大,总不能一个一个算吧,考虑可不可以二分答案。容易得到一个 \(O(n^3\log V)\) 的,其中一个数二分,可以优化到 \(O(n^2\log n\log V)\)。好像看不到什么优化空间了,这时候就得上神奇的根号分治了。
我们考虑二分的那个第 \(k\) 小值,以后称为 \(num\),如果小于等于 \(num-a_B\) 的 \(b_p+c_q\) 个数大于等于 \(\frac{k}{B}\) ,前面还有 \(B-1\) 个,并且一个比一个个数多,那是不是就意味着这个 \(num\) 一定合法了?!干脆直接把 \(1\)~\(B\) 的 \(a\) 全算了,这样就可以 \(O(Bn\log n)\) 的判断这种情况。
那小于呢?小于是不是意味着 \(B+1\)~\(n\) 的 \(a\) 所产生的贡献都小于 \(\frac{k}{B}\),也就是说只有 \(\frac{k}{B}\) 个 \(b_p+c_q\) 是有用的,我们再算的时候就可以先把前 \(\frac{k}{B}\) 小的 \(b_p+c_q\) 存下来,然后枚举 \(a\) 后二分。这部分预处理和计算的时间复杂度是 \(O(\frac{k}{B}\log \frac{k}{B}+(n-\frac{n}{B})\log \frac{k}{B})\),把无关紧要的去一下 \(O(\frac{k}{B}\log +n\log )\)。平衡一下,\(B\) 取 \(\sqrt{\frac{k}{n}}\) 就能通过了,时间复杂度是 \(O(\sqrt{nk}\log n\log V)\)。
T3
T4
2024.10.12 代码源
T1 \(a_{i-1}+a_{i+1}\ge 2a_i\) 这东西好像不太好维护,我们移一下项,把它变成一个对称的形式 \(a_{i+1}-a_i\ge a_i-a_{i-1}\),也就是说我们要求一个不降的差分数列的概率,好像还是不是很好求,我们再观察这个式子,发现一个合法的数列,长得像个 \(V\) 字形,也就是说,我们把最小的放中间,然后往左右两边加数。这样就可以得到一个朴素的 \(DP\),状态为 \(f[i][j][k][p][q]\),表示把 \(a\) 从小到大考虑到第 \(i\) 个数,当前拼成的数列长成 \(a_j,a_k...a_p,a_q\) 的方案数。然后
我们发现存两个数就够了,因为这四个数里必定有两个是 \(a_i,a_{i-1}\)。
T2 很神奇的 区间 \(DP\),发现数组 \(b\) 有点类似一个树的结构,差不多长这样:

我们直接从下往上构造,最底下是第 \(0\) 层,如果 \(m\) 二进制下的第 \(d\) 位是 \(1\),就意味着我们的树当前层,右子树顶上界,左子树因为这一位是 \(0\),所以不会顶上界,可以随便填。于是我们就可以得到 \(f[d][l][r][0/1]\) 表示考虑到第 \(d\) 层,区间为 \([l,r]\),顶没顶上界。
T3 这题首先得把题读懂,然后注意一下题面里给的限制条件,然后再好好思考一下有什么用,已经不太会了😅
T4 没订
2024.10.13 核桃OJ
2024.10.14 33dai
T1
T2
T3
T4
2024.10.16 PYYZOJ
2024.10.18 33dai
T1 设 \(f_{i,j,k}\) 表示 \(a\) 序列前 \(j\) 个和 \(b\) 序列前 \(k\) 个数,能组成多少个长度为 \(i\) 的满足条件的子序列对,前缀和优化dp即可。
T2 涉及二进制运算的答案算的时候可以考虑考虑拆位。
如果 \(2^i\) 可以划分出来,我们再考虑 \(2^i+2^{i-1}\) 是否可以划分出来,以此类推。求个异或前缀和,可以 \(O(n^2)\) 的可行性 \(DP\),用 \(map\) 存一下,\(O(n\log n)\),用 \(unordered-map\) 可以更快(需要考虑顺序时用 \(map\),只是查找时 \(unordered-map\) 就可以了)。
T3 写了个神秘随机化,刚开始 \(90\),赢!然后改数据了,\(50\)😥。玄学题。
我们可以选一批数值相近的多个数来组合,根据抽屉原理 \(24\) 个就能组合出方案。
T4 给了 \(60\) 分的部分分😋。
发现只有 \(f_{j}=f_{i-1}-1\),\(f_{k}=f_{i-1}-2\),\(f_{l}=f_{i-1}-3\) 对于 \(f_i\) 的转移是有用的,因为每组之间相差一定是大于等于 \(20\) 的,\(60\)分 的简单 \(DP\) 枚举的最短点 \(j\) 也是 \(\max(i-75,1)\le j\le i\),我们发现这东西其实挺等价的。
我们还发现 “\(?\)” 的取值对后续转移是有影响的,可能需要把它放到状态里,所以考虑 \(DP\)套\(DP\)。
重要的不是 “\(?\)” 填什么,而是上一个区间的位置。有一种做法是把 \(f_{j}=f_{i}-1\),\(f_{k}=f_{i}-2\),\(f_{l}=f_{i}-3\) 中 \(j\)到\(i\),\(k\)到\(i\),\(l\)到\(i\) 的距离存下来,这样我们转移的时候就清楚当前如果是 “\(1\)” 该不该放新的区间了。
具体的,我们设 \(f_{i,j,k,l}\) 表示考虑到第 \(i\) 个位置,\(j\),\(k\),\(l\) 和上述同理。如果当前是 “\(1\)”,\(j\ge20\) 并且 \(l\ge 75\) 就意味着从 \(j\) 开始的长 \(20\) 的区间覆盖不到 \(i\),且从 \(l\) 开始的长为 \(75\) 的区间也覆盖不到,那我们就不得不新开个长 \(20\) 的区间把 \(i\) 覆盖上,这时 \(j\) 变为 \(0\),\(k\) 变为 \(j\),\(l\) 变为 \(k\),就实现了状态的转移。对于代价总和的计算,我们只需要在需要新开区间的地方加上方案数就行了。
2024.10.19 代码源
T1 直接从每个点出发跑一遍 \(01bfs\),然后 \(O(n^2)\) 的枚举点对,统计答案即可。
T2 看着就很贪心,考虑怎么贪,来多试几种排序方式,发现可以把这 \(N+M\) 个区间放一块,然后 \(a\) 的排序的权值是 \(r\),\(b\) 的排序的权值是 \(l\),然后从左往右扫,扫到一个 \(b\),然后放堆里,扫到一个 \(a\),如果之前选的 \(b\) 没覆盖到,就选堆里 \(r\) 最大的,这时这个 \(b\) 一定和这个 \(a\) 重叠,做完了。
T3 首先可以得到一个朴素 \(DP\),枚举 \(a_1\),然后做 \(O(m)\) 的 \(DP\),具体的就是用 \(unordered-map\) 优化一下。当 \(n\ge 200\) 时,这东西复杂度是对的,如果我们让 \(|A_i|\) 最小,那它最大只能是 \(\frac{\sum_{i=1}^N|Ai|}{n}=10^3\)。
考虑 \(n<200\) 时,\(n\) 一小,首先想到容斥。我们要求 \(f(\{a_1,a_2,...,a_n\})\),发现 \(f(\{A_1,A_2,...,A_n\})=g(\{A_1,A_2,...,A_n\})-f(\{A_2,...,A_1\cap A_n\})\)。\(f\) 为环的答案,\(g\) 为链的答案。得:
链的答案是好求得,复杂度为 \(O(nm)\)。分类讨论一下,这题就做完了。
T4 可持久化李超树,是用分块实现的可持久化,记得自己当时听完就糊出来了😎。
具体的,我们按 \(k\) 对这 \(n\) 天分块,这样它查询最多查两个块,一个是后缀一个是前缀,修改变成只需要添加,维护个后缀的李超树,维护个前缀的李超树就做完了。
2024.10.21 33dai
T1
T2
T3
T4
2024.10.22 PYYZOJ
2024.10.24 PYYZOJ
2024.10.29 PYYZOJ
2024.10.30 PYYZOJ
2024.11.01 核桃OJ
2024.11.02 代码源
T1 当时没做出来,直接给干自闭了😰,其实这题一点都不难。
正常的 \(LIS\) 和 \(LDS\) 都是 \(DP\) 来的,我们知道,既然是 \(DP\) 来的,那它就是个 \(DAG\),其实从差分约束的角度想更符合一些。我们根据 \(a\) 和 \(b\) 能把数列合法的必要条件通过边的形式表达出来,然后发现当所有的大小关系都得到满足的时候,就是合法的了。
具体的,对于一个 \(1\le i<j\le n,a[i]=a[j]\),那么 \(p[i]>p[j]\),如果 \(a[i]+1=a[j]\),我们让最后一个满足这个条件的 \(i\) 满足 \(p[i]<p[j]\) 就行了,因为对于 \(i\) 而言,和它 \(a\) 相等的,在 \(j\) 之前的,\(p[i]\) 是最小的。对于 \(b\) 是同理的。因为题目保证存在一个合法情况,所以图中不可能出现环,我们直接拓扑排序一遍就求出每个位置 \(p\) 最小可以取什么,其实实现的时候直接在出队的时候赋上编号就行了,这样直接就构造出了一个合法方案。
T2 这题我直接一遍糊出来的,我真厉害🤤。
首先贪心的考虑,左边和右边能匹配的先匹配上,这样一定是优的。然后这时左边或右边就会出现一段你必须得删的。这图画的有点丑,但是挺清晰的。红的代表删掉的,然后就可能有下面的两种情况,蓝的竖杠是回稳中心,横着的是匹配的部分,
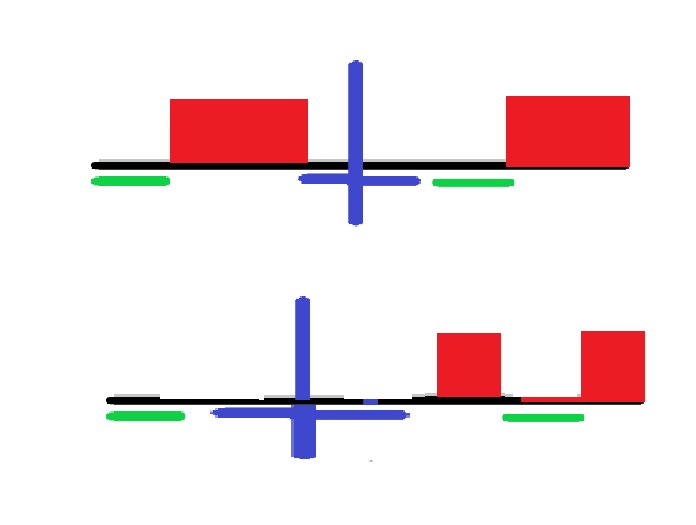
我们可以用 \(manacher\) 求从回文中心开始的最长长度,然后用 \(KMP\) 求一个从某一位开始的一段前缀反过来,能和整个字符串的前缀匹配多少。然后把字符串反过来再做一遍就行了。注意特判下面那种情况,其实也是好处理的。
T3 这题比 T2 好写。我们发现得分是正数的位置除了停脚以外,它的得分是不重要的,因为一定能拿到这个得分,所以我们把所有正数先加到答案上,再赋成 \(0\),然后从前往后做 \(dijkstra\) 就行了。需要注意的是,每个格子第一次被更新的时候就一定是最优的了,这样枚举转移的时候直接从上一次枚举到的位置的下一个开始就行了,这样就可以把复杂度降到 \(O(n\log n)\) 了。
T4 推式子的题,感觉不太好想,但是可能比较套路?
\(H(x)\) 是 \(x\) 的深度的期望,\(P(x)\) 是 \(x\) 是 \(lca\) 的概率,\(W_u(v)\) 表示 \(u\) 是 \(v\) 的祖先的概率。
还是看看代码吧,不想手打公式了😋。
    f[1]=cnt[1]=1;
	for(int i=1; i<=n; ++i)
	{
		if(i>1)
			f[i]=Cadd(1ll, Cmul(f[i], Ginv(cnt[i])));
		for(int j=i+i; j<=n; j+=i) Madd(f[j], f[i]), cnt[j]++;
	}
	for(int i=1; i<=n; ++i)
	{
		g[i].resize(n/i+2);
		g[i][1]=1;
		for(int j=1; j<=n/i; ++j)
		{
			if(j>1) Mmul(g[i][j], Ginv(cnt[i*j]));
			for(int k=j+j; k<=n/i; k+=j) Madd(g[i][k], g[i][j]);
		}
	}
	for(int i=n; i>=1; --i)
	{
		int sum=0;
		for(int j=i; j<=n; j+=i)
			Madd(sum, g[i][j/i]);
		h[i]=Cmul(sum, sum);
		for(int j=i+i; j<=n; j+=i)
			Mdel(h[i], Cmul(h[j], g[i][j/i], g[i][j/i]));
	}
	int ans=0;
	for(int i=1; i<=n; ++i)
	{
		Madd(ans, Cmul(f[i], n, 2ll));
		Mdel(ans, Cmul(f[i], h[i], 2ll));
	}
2024.11.04 PYYZOJ
今天有两个重要的常用 \(trick\) !!!
抽屉原理和根号分治
抽屉原理在找合法方案时,我们先钦定都不合法,然后发现如果都不合法值域一定会超,发现只要很少的数就可以超过值域,即通过很少的数就可以得到合法的。
根号分治在处理关于序列的次数时,总共 \(n\) 个,出现次数超过 \(\sqrt n\) 的一定在 \(\sqrt n\) 内,出现次数没超过 \(\sqrt n\) 的可以暴力枚举。
T1
T2
T3
T4
2024.11.05 核桃OJ
2024.11.06 33dai
T1
T2
T3
T4
2024.11.08 33dai
T1
T2
T3
T4
2024.11.09 代码源
T1 发现谁和谁打是固定的,线段树维护一下每个区间赢的那个人的赢的概率。(线段树真是万能啊😀)
T2 比较简单的 \(dp\) 套 \(dp\),记一个 \(set<pair<int,int>>\) 类型的 \(f[i]\) 表示总共填了 \(i\) 个数,然后 \(first\) 为能匹配 \(S\) 的哪些前缀,\(second\) 存方案数。
显然对于 \(first\ \&\ 2^n=2^n\) 那么剩下的 \(i-n\) 个字符就必须匹配 \(t\) 的 \(1\) ~ \(i-n\)。
T3 分治求每个区间的 \(f(l,r)\),具体的,我们求出从 \(mid\) 到 \(l\) ~ \(mid\) 的选 \(mid\) 与不选 \(mid\) 的答案,同理能求出 \(mid+1\) 到 \(mid+1\) ~ \(r\) 的答案,然后考虑合并这两个东西,也就是我们要求对于每个左半部分的位置,当 \(mid\) 选时,右边怎么选更优,不选 \(mid\) 时,右边怎么选更优。
void solve(int l, int r)
{
	if(l==r)
	{
		Madd(ans, a[l]%P);
		return;
	}
	int mid=(l+r)>>1;
	solve(l, mid);
	solve(mid+1, r);

	f[mid]=f[mid-1]=a[mid];
	f[mid+1]=f[mid+2]=a[mid+1];
	for(int i=mid-2; i>=l; --i)
		f[i]=max(f[i+1], f[i+2]+a[i]);
	for(int i=mid+3; i<=r; ++i)
		f[i]=max(f[i-1], f[i-2]+a[i]);

	g[mid]=g[mid+1]=0;
	g[mid-1]=a[mid-1];
	g[mid+2]=a[mid+2];
	for(int i=mid-2; i>=l; --i)
		g[i]=max(g[i+1], g[i+2]+a[i]);
	for(int i=mid+3; i<=r; ++i)
		g[i]=max(g[i-1], g[i-2]+a[i]);

	int sum1=0, sum2=0;
	q1.clear(); q2.clear();
	for(int i=l;   i<=mid; ++i) q1.push_back(i);
	for(int i=mid+1; i<=r; ++i) q2.push_back(i), sum1+=f[i];
	sort(q1.begin(), q1.end(), [&](int x, int y){return max(f[x]-g[x], 0ll)<f[y]-g[y];});
	sort(q2.begin(), q2.end(), [&](int x, int y){return max(f[x]-g[x], 0ll)<f[y]-g[y];});
	for(int i=0, j=0; i<q1.size(); ++i)
	{
		while(j<q2.size() && max(f[q1[i]]-g[q1[i]], 0ll)>=f[q2[j]]-g[q2[j]])
			sum1-=f[q2[j]], sum2+=g[q2[j]], j++;
		Madd(ans, Cmul((int)q2.size()-j, g[q1[i]]%P), sum1%P);
		Madd(ans, Cmul(j, max(f[q1[i]], g[q1[i]])%P), sum2%P);
	}
}
T4 二分答案,考虑怎么 \(check\)。我们把 曼哈顿距离 转换成 切比雪夫距离,这样一个点可到达的区域就变成了一个平行于 \(x\) 轴, \(y\) 轴的矩形。如果没有传送阵,就是看这些矩形有没有交集。再考虑有传送阵的情况,我们发现,我们根本不关心我们要传送到哪里,我们只需要让一个人去离他最近的传送阵,最后看那些不走传送阵的人构成的矩形的交集扩大边长后,有没有传送阵就行了。具体的,我们求出每个人到离他最近的传送阵的距离,按距离从小到大排个序,我们钦定 \(1\) ~ \(i\) 走传送阵,\((i+1)\) ~ \(n\) 不走传送阵,那么我们对后 \((i+1)\) ~ \(n\) 个人求出交集,边长扩大第 \(i\) 个人可以多走的长度,判这个矩形中有没有传送阵就行了。我们直接从后往前枚举,然后矩阵求交,最后用主席树做一下二维数点。需要注意的是 曼哈顿距离 转 切比雪夫距离 时,这两东西是相等的,但是 切比雪夫距离 转 曼哈顿距离 的时候是不相等的,这题延伸边长的时候本质是 切比雪夫距离 转 曼哈顿距离 需要特判一下,详见代码。
bool check(int lim)
{
	int Lx=-V, Rx=V;
	int Ly=-V, Ry=V;
	for(int i=1; i<=n; ++i)
	{
		int id=a[i].se;
		if(lim>=a[i].fi)
		{
			int t=lim-a[i].fi;
			if(calc(Lx-t, Ly-t, Rx+t, Ry+t))
				return 1;
		}
		cmax(Lx, px[id]-lim);
		cmax(Ly, py[id]-lim);
		cmin(Rx, px[id]+lim);
		cmin(Ry, py[id]+lim);

		if(Lx==Rx)
		{
			Ly+=(Lx+Ly)&1;
			Ry-=(Lx+Ry)&1;
		}
		if(Ly==Ry)
		{
			Lx+=(Ly+Lx)&1;
			Rx-=(Ly+Rx)&1;
		}

		if(Lx>Rx || Ly>Ry) return 0;
	}
	return 1;
}
2024.11.12 代码源
T1 题意可以转换成给你 \(n\),让你构造一组 \(2^{a_1}3^{b_1}+2^{a_2}3^{b_2}+...+2^{a_k}3^{b_k}\) 且 \(\forall i<j, a_i<a_j\ and\ b_i>b_j\)。还需要有一个观察,就是我们如果 \(\frac{n}{2}\),最后给所有 \(a+1\),方案一样是合法的,也就是说我们可以不断的对 \(n\) 除以 \(2\),如果二进制下最低位是 \(1\),这时再考虑用 \(3\),我们直接取最大的 \(3^b\),因为 \(n\) 是在不断减少的,所以这就保证了 \(a\) 递增,\(b\) 递减。考虑这为什么是对的,其实仔细思考一下,如果这东西只有两个地方存疑,一个是 \(b\) 一定是递减的吗,二是如果强行保证 \(b\) 递减,最后如果 \(b_k=0\) 能把 \(n\) 减成 \(0\) 吗。
对于第一种情况,假设现在 \(n\ge 3^x\) 此时 \(x\) 是最大的满足条件的,如果我们要让下一个 \(y\) 与 \(x\) 相等,就得满足 \(\frac{n-3^x}{2}\ge 3^x\) 即 \(n\ge 3\times 3^x\),与 \(x\) 最大不符,假设不成立,所以这样做 \(b\) 一定是递减的。
对于第二种情况,对于减掉 \(3^x\) 后的 \(n\le 2\times3^{x-1}\),也就是说我们只要不停的减,迟早 \(n\le 2\times3^0\),此时我们一定是有解的了。
T2 根据题意会得到一个暴力,但是我考场上连这个根据题意模拟的暴力都没写出来😢...
for(int i=1; i<=n; ++i)
	cnt+=(s[i]=='1');
for(int i=1; i<=n; ++i)
	if(s[i]=='1') ans+=2*i+1;
for(int i=1; i<=cnt; ++i)
	ans-=i*2;
然后直接线段树维护一个 \(1\) 的位置的下标和就做完了。
T3 先按左端点排序,维护两个 \(DP\) 数组,\(f[i][j]\) 表示考虑到第 \(i\) 个区间,还不是点支配集的,没 满足条件的区间的最靠左的右端点为 \(j\) 的方案数,\(g[i][j]\) 表示考虑到第 \(i\) 个区间,已经是点支配集的,选了的区间的最靠右的右端点为 \(j\) 的方案数。
不想手打式子了,直接贴个代码。
for(PII x : f[i-1])
	if(x.fi>=a[i].fi)
	{
		Madd(g[i][a[i].se], x.se);
		Madd(f[i][min(x.fi, a[i].se)], x.se);
	}
for(PII x : g[i-1])
	if(x.fi>=a[i].fi)
	{
		Madd(g[i][x.fi], x.se);
		Madd(g[i][max(x.fi, a[i].se)], x.se);
	}
	else
	{
		Madd(f[i][a[i].se], x.se);
		Madd(g[i][a[i].se], x.se);
	}
这玩意其实就是个区间乘,单点加,线段树维护就行了。
int tmp1=F.query(rt_f, 0, 1e9, a[i].fi, 1e9);
int tmp2=F.query(rt_f, 0, 1e9, a[i].se+1, 1e9);

int tmp3=G.query(rt_g, 0, 1e9, a[i].fi, a[i].se-1);
int tmp4=G.query(rt_g, 0, 1e9, 0, a[i].fi-1);

F.change(rt_f, 0, 1e9, 0, a[i].fi-1, 0);
F.change(rt_f, 0, 1e9, a[i].se+1, 1e9, 0);
F.update(rt_f, 0, 1e9, a[i].se, Cadd(tmp2, tmp4));

G.change(rt_g, 0, 1e9, 0, a[i].fi-1, 0);
G.change(rt_g, 0, 1e9, a[i].se, 1e9, 2);
G.update(rt_g, 0, 1e9, a[i].se, Cadd(tmp1, tmp3, tmp4));
时间复杂度是 \(O(n\log V)\) 的。
T4 没订😋。
2024.11.13 33dai
T1
T2
T3
T4
2024.11.14 代码源
T1 先在从左往右每个数和一个下标对应上,整个序列会形成若干个段,只要不跨过这些段,怎么拍都是对的。因为它同时要求字典序最小,所以直接模拟就可以了。虽然在场上并没有做出来。
void solve(int op)
{
	for(int i=1; i<=n; ++i)
	{
		if((i&1)==op)
			vis[i]=1;
		else vis[i]=0;
	}

	vector <int> res;
	res.resize(n+2);

	int now=0, sum=0, last=1;

	for(int i=1; i<=n; ++i)
	{
		res[i]=a[i];
		if(a[i]%2==0 && vis[i])
		{
			now--;
			if(!now)
			{
				while(q.size()) q.pop();
				for(int j=i; j>=last; --j)
				{
					if(a[j]%2==0)
						q.push({a[j], j});
					if(!vis[j])
					{
						res[j]=q.top().fi;
						sum+=abs(q.top().se-j);
						q.pop();
					}
				}
				while(q.size()) q.pop();
				for(int j=last; j<=i; ++j)
				{
					if(a[j]%2==1)
						q.push({-a[j], j});
					if(vis[j])
					{
						res[j]=-q.top().fi;
						sum+=abs(q.top().se-j);
						q.pop();
					}
				}
				last=i+1;
			}
		}
		if(a[i]%2==1 && !vis[i])
		{
			now++;
			if(!now)
			{
				while(q.size()) q.pop();
				for(int j=i; j>=last; --j)
				{
					if(a[j]%2==1)
						q.push({a[j], j});
					if(vis[j])
					{
						res[j]=q.top().fi;
						sum+=abs(q.top().se-j);
						q.pop();
					}
				}
				while(q.size()) q.pop();
				for(int j=last; j<=i; ++j)
				{
					if(a[j]%2==0)
						q.push({-a[j], j});
					if(!vis[j])
					{
						res[j]=-q.top().fi;
						sum+=abs(q.top().se-j);
						q.pop();
					}
				}
				last=i+1;
			}
		}
	}

	if(sum<ans)
	{
		ans=sum;
		tmp=res;
	}
	else if(sum==ans)
		cmin(tmp, res);
}
T2 我们按怀疑度从大到小加边,注意到如果想走一条边,必须把一个连通块内所有怀疑度大于这条边的边都走了,也就是把整个连通块里的点都访问一遍,这样我们就确定了每条边的权值,然后跑遍 \(dijkstra\) 就行了。
for(int d=9; ~d; --d)
{
	for(int i=1; i<=n; ++i)
		for(int j=1; j<=n; ++j)
			if(f[i][j]==d+1) merge(i, j);
	for(int i=1; i<=n; ++i)
		for(int j=1; j<=n; ++j)
			cmax(f[get(i)][j], f[i][j]);
	for(int i=1; i<=n; ++i)
		for(int j=1; j<=n; ++j)
			if(f[get(i)][j]==d)
				g[i][j]=siz[get(i)];
}

memset(ans, 0x3f, sizeof(ans));

ans[1]=0;
for(int i=1; i<=n; ++i)
{
	int t=0;
	for(int j=1; j<=n; ++j)
		if(!vis[j] && ans[j]<ans[t])
			t=j;
	vis[t]=1;
	for(int j=1; j<=n; ++j)
		if(!vis[j])
			cmin(ans[j], ans[t]+g[t][j]);
}
2024.11.16 代码源
T1 当时首先想到 \(01\) 分数规划,但是发现不太可做,然后又发现压根不用 \(01\) 分数规划,直接做就行了,不想写了,代码写的过于清晰了。
for(int i=1; i<=n; ++i)
{
	a[i]=a[i-1]+s[i]-'0'-f;
	b[i]=b[i-1]+s[i]-'0';
}

for(int i=n; ~i; --i)
{
	if(i!=n)
	{
		auto t=st.lower_bound({a[i], 0});
		PII res=*t;

		ld sum=(b[res.se]-b[i])/(res.se-i);
		if(!id || fabs(f-sum)<=fabs(f-ans))
		{
			id=i;
			ans=sum;
		}

		if(t!=st.begin())
		{
			t--; res=*t;

			ld sum=(b[res.se]-b[i])/(res.se-i);
			if(!id || fabs(f-sum)<=fabs(f-ans))
			{
				id=i;
				ans=sum;
			}
		}
	}
	if(i) st.insert({a[i], i});
}

printf("%lld", id);
T2 很牛的 \(DP\),设 \(f[l][r]\) 表示在 \(r\) 处放一条边,内部到 \(l\) 的最小最大距离,\(g[l][r]\) 表示在 \(l\) 处放一条边,内部到 \(r\) 的最小最大距离,\(s[l][r]\) 表示在 \(l\) 和 \(r\) 各放一条边,内部的最小最大距离。预处理完这些后,二份答案,\(check\) 时, 设 \(dp[i][j]\) 表示考虑到 \(i\),加了 \(j\) 条边,且最后一天边在 \(i\) 上,还是直接上代码吧。
bool check(int lim)
{
	memset(dp, 0x3f, sizeof(dp));

	for(int i=0; i<=n; ++i)
		if(sum_a[i]+sum_b[i]<=lim)
			dp[i][1]=max(sum_a[i], sum_b[i]);

	for(int i=1; i<=n; ++i)
		for(int j=0; j<i; ++j)
			for(int k=0; k<=m; ++k)
			{
				if(s[j][i]>lim) break;
				if(dp[j][k]+f[j][i]>lim) continue;

				cmin(dp[i][k+1], max(dp[j][k]+min(sum_a[i]-sum_a[j], sum_b[i]-sum_b[j]), g[j][i]));
			}

	for(int i=0; i<=n; ++i)
		if(max(dp[i][m]+max(sum_a[n]-sum_a[i], sum_b[n]-sum_b[i]),
							 sum_a[n]-sum_a[i]+sum_b[n]-sum_b[i])<=lim)
			return 1;
	return 0;
}
T3 有点难,忘了咋推的了。
sort(a+1, a+n+1);
for(int i=1; i<=n; ++i)
	b[i]=a[i], f[n]+=a[i];
f[n]=f[n]/n-C;
for(int i=n-1; i>=1; --i)
{
	for(int j=1; j<=i; ++j)
		c[j]=b[j]*(i+1-j)/(i+1)+b[j+1]*j/(i+1);
	for(int j=1; j<=i; ++j)
		f[i]+=max(f[i+1], c[j]);
	f[i]=f[i]/i-C;
	for(int j=1; j<=i; ++j) b[j]=c[j];
}
printf("%.9Lf", f[1]);
T4 没订。
2024.11.19 代码源
T1 场切😋。直接根据 \(bfs\) 的层数编号就行了,感觉没啥难的。
T2 场切😋。线段树维护长度为 \(l\) 的权值之和,因为它的修改,对长度为 \(k\) 的询问的影响是连续的,并且这种修改是固定的值,然后用 \(set\) 维护下一个与它颜色相同的位置,就可以直接修改了。对于一个长度为 \(k\) 的答案,贡献是 \(\max(nxt-\max(i,k),0)\),然后分类讨论 \(\max\) 怎么取,线段树维护一下就做完了。
T3 首先有一个观察,就是去了就必须加油,否则就没必要去。贪心的想,一个点去另一个点之前,要么加满,要么加到另一个点的距离的油。这样一个点对应的状态就是 \(O(n)\) 个,并且每对点之间的转移是固定的,只有两种。
cmin(f[(d+1)&1][mp[j][0]],   f[d&1][mp[i][dist(i, j)]]);
cmin(f[(d+1)&1][mp[j][W-dist(i, j)]], f[d&1][mp[i][W]]);
还有点内转移。
cmin(f[d&1][id[i][j+1].se], f[d&1][id[i][j].se]+(id[i][j+1].fi-id[i][j].fi)*c[i]);
两个部分都是 \(O(n^2)\) 的。总的复杂度就是 \(O(dn^2)\)。
T4 没订。
2024.11.20 33dai
T1
T2
T3
T4
2024.11.21 代码源
T1 发现整个序列的最大值一定能赢,这就启发我们根据最大值,把序列分成两部分。对于分治后的部分,求出最大值,如果把整个序列的全吃了,如果比上一个最大值大,就可以吃掉最大值后,把上一个区间里的全吃掉,如果还能把之前的最大值吃掉,就赢了,这里是好实现的,具体的。
solve(l, res-1, max(a[res], mx-r+res-1));
solve(res+1, r, max(a[res], mx-res+l-1));
\(res\) 就是最大值所在位置。用笛卡尔树理解也是容易的。
T2 区间 \(DP\),枚举最大值所在位置 \(k\),条件是 \(min(k-l, r-k)=a[k]\),这时我们就可以从原本 \(r-l+1\) 个数中挑出 \(k-l\) 个放左边,然后最大值放中间,剩下 \(r-k\) 个在右面。
T3 喝的。
T4 喝的。
2024.11.23 代码源
T1 我们令 \((a+b)(a-b)=n\),\(a+b=q,a-b=p\),化简一下,\(a^2=n+b^2\),此时 \(a\) 最小等于 \(\sqrt n\),并且如果 \(n\) 取值较大,那么此时 \(b\) 的取值就会增长较快,此时对应的 \(a-b\) 就会更快的出 \([10^9,2\times10^9]\),所以直接暴力枚举 \(a\) 就行了。
T2 小 \(dp\) 套 \(dp\),有一个观察,就是 \(f[u][1]-f[u][0]\le1\)。
T3 线段树合并。
T4 没订。

 浙公网安备 33010602011771号