
Fourier Features Let Networks Learn High Frequency Functions in Low Dimensional Domains
Fourier Features Let Networks Learn High Frequency Functions in Low Dimensional Domains
原文:从理论层面解释位置编码在隐式神经表示中对MLP的性能增益。
注:本文内容远超笔者的知识储备,仅简单记录个人理解。
动机
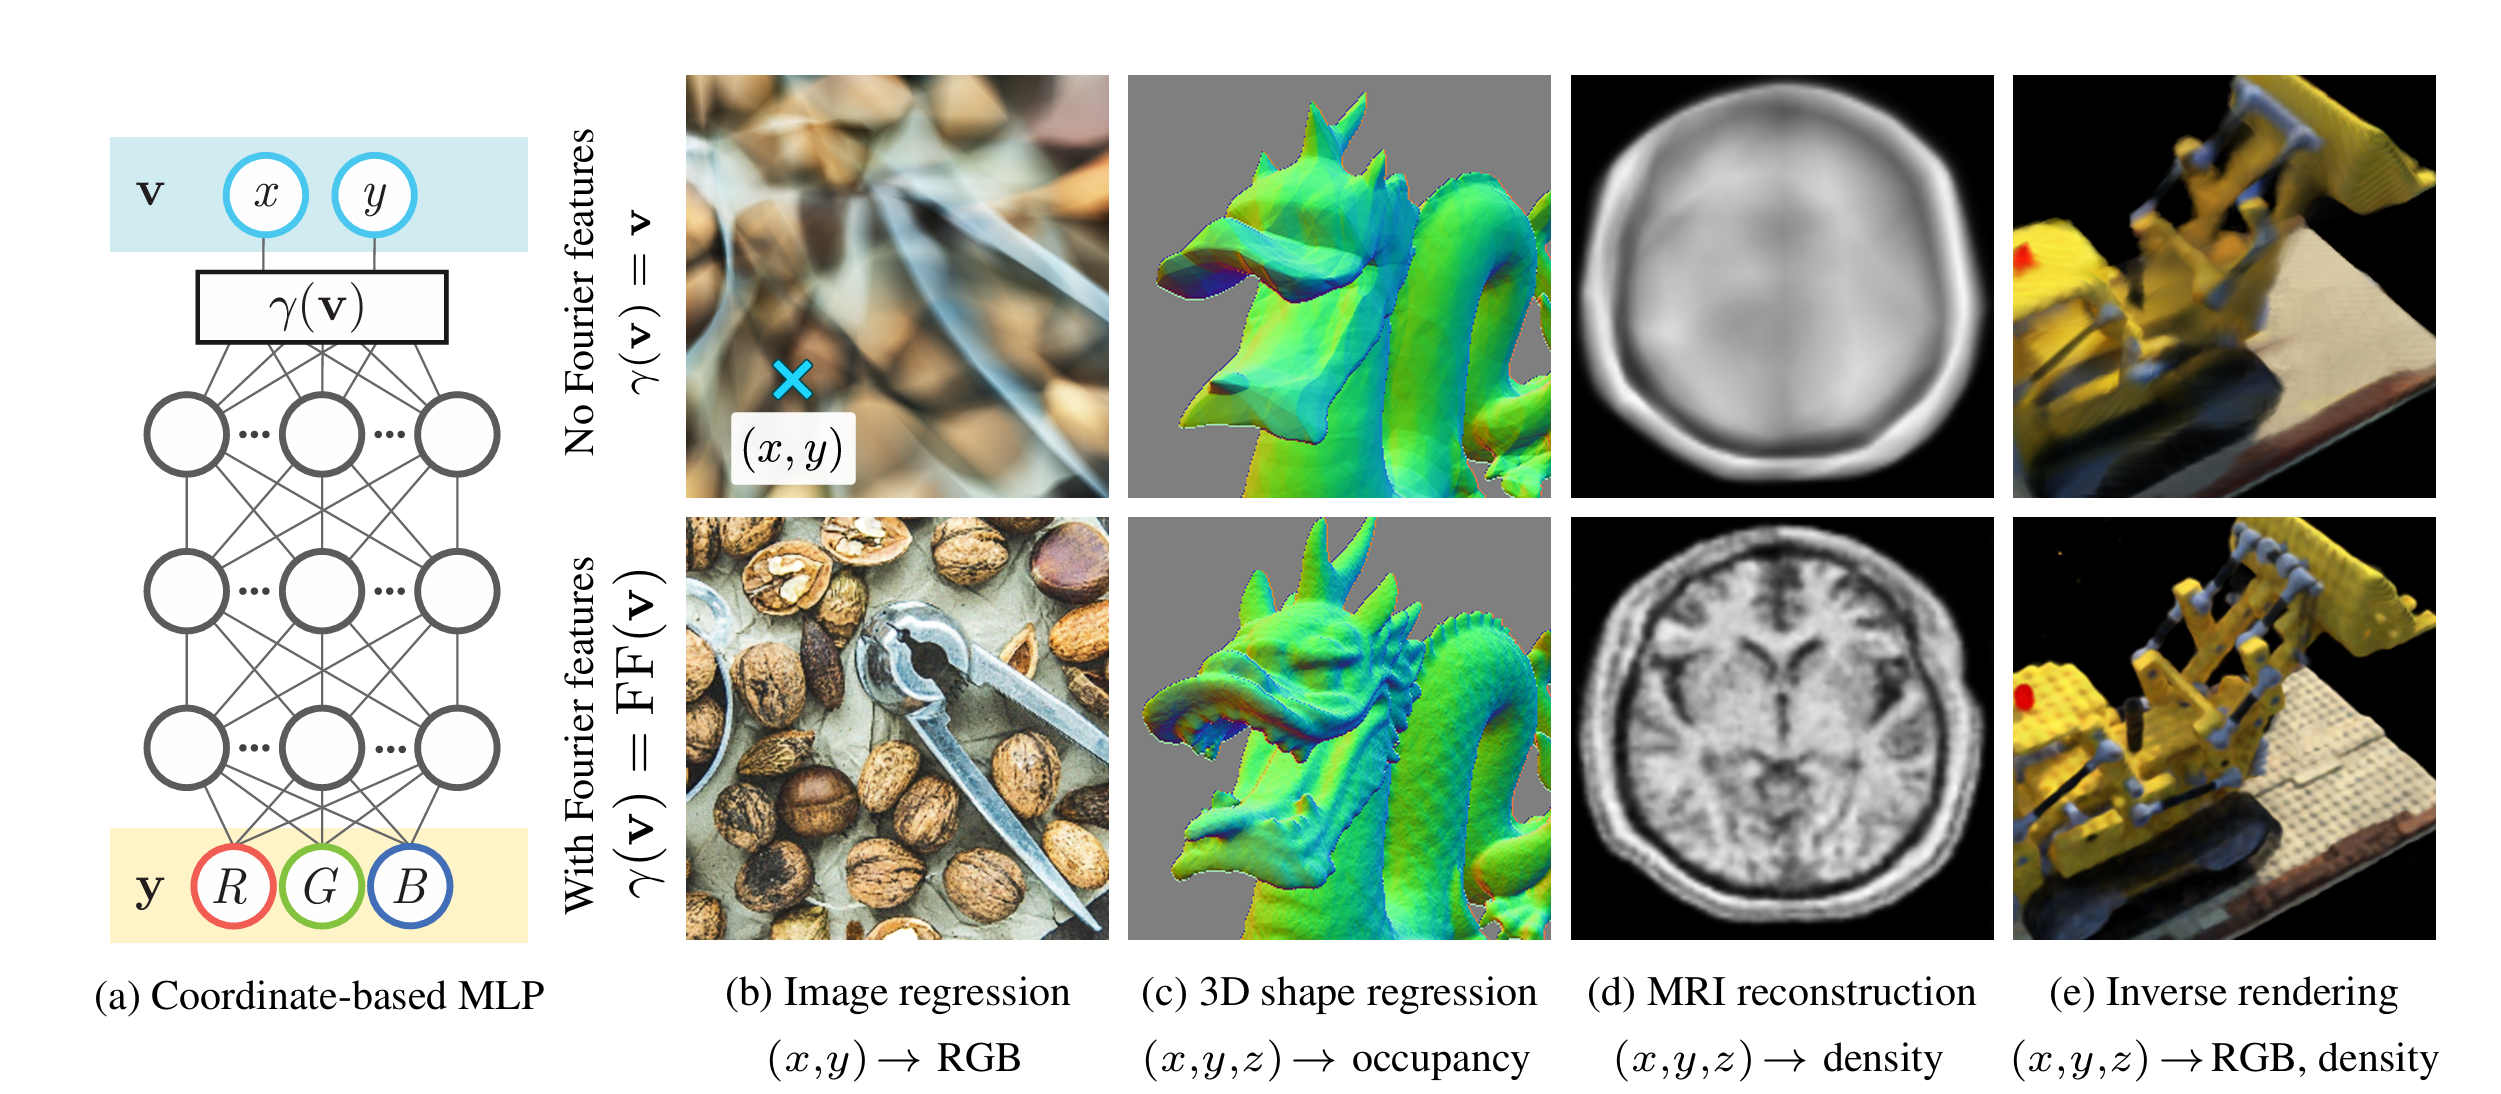
基于隐式神经表示(Implicit Neural Representation,INR)的框架,利用MLP对位置坐标进行映射在二维图像、三维模型上已经很广泛。本文作者发现,如果不对坐标进行傅里叶特征处理,则会出现过度平滑的结果。
核回归
作者首先基于核回归(Kernel Regression)的理论对其进行了解释。给定一个数据集\((\mathbf{X},\mathbf{y})=\{(\mathbf{x}_i, y_i)\}^n_{i=1}\),其中\(\mathbf{x}_i\)是输入数据且\(y_i=f(\mathbf{x_i})\)是输出的标量标签。此时核回归的目标就是在任意数据点\(\mathbf{x}\)上构建\(f(\cdot)\)的估计\(\hat{f}(\cdot)\):
其中\(\mathbf{K}\)是一个\(n \times n\)的核(Gram)矩阵,其中\(\mathbf{K}_{ij}=k(\mathbf{x}_i,\mathbf(x)_j)\),\(k\)是一个对称半正定的核函数用以衡量输入数据之间的相似性。
因此,核回归的过程可以视为基于输入数据与数据集中各数据点的相似性对数据集标签的加权和。
用核回归近似深度网络
注:这部分理论笔者并没有完全理解,仅根据原文进行个人总结。
将目标函数\(f\)设定为一个全连接深度网络,其参数为以高斯分布\(\mathcal{N}\)初始化的\(\theta\)。当\(f\)中的层内宽度趋于无限且SGD的学习率趋于0时,\(f(\mathbf{x};\theta)\)在训练中通过Neural Tangent Kernel(NTK)收敛到核回归解(kernel regression solution):
(中间的推导不太明白略过)当网络通过L2损失函数及学习率\(\eta\)进行训练时,\(t\)轮训练迭代后网络对测试数据\(\mathbf{X}_{test}\)的输出可以近似为:
训练神经网络时的频谱偏差
注:这部分理论笔者并没有完全理解,仅根据原文进行个人总结。
由于NTK的\(\mathbf{K}\)矩阵时对称半正定的,可对其进行特征值分解\(\mathbf{K}=\mathbf{Q}\mathbf{\Lambda}\mathbf{Q}^T\),其中\(\mathbf{Q}\)是正交的且特征值\(\lambda_i \geq 0\)。然后,由于\(e^{-\eta \mathbf{K} t } = \mathbf{Q} e^{-\eta \mathbf{\Lambda} t} \mathbf{Q}^T\),可得:
这意味着,训练误差的第\(i\)项\(|\mathbf{Q}^T(\hat{\mathbf{y}^{(t)}_{train}} - y)|_i\)可近似看作以\(\eta \lambda_i\)的速率指数衰减。也就是说,特征值大的项学习更快。在INR场景下,这就导致了MLP在高频部分收敛慢,也就表现出过度平滑的拟合结果。
方法
在上述理论分析的基础上,则有以下解决思路:
- 由于坐标的分布比较均匀,和传统机器学习中的输入数据分布不同。因此需要引入稳定的(平移不变的)核。
- MLP的收敛过程与\(\mathbf{K}\)的特征值有关,因此希望通过控制带宽(bandwidth)提高模型训练速度与泛化性。
一种符合上述要求的编码方式就是基于三角函数构造的傅里叶特征:
根据三角函数公式\(\cos(\alpha-\beta)=\cos\alpha\cos\beta+\sin\alpha\sin\beta\),可以推导得到:
可见,该核具有平移不变性,即计算得到的相似性仅和输入位置的差有关。并且,参数\(a\)和\(\mathbf{b}\)的设置能够控制频谱的带宽。
实验
文中对比了三种傅里叶特征的设置:
- Basic:\(\gamma(\mathbf{v})=[\cos(2\pi\mathbf{v}),\sin(2\pi\mathbf{v})]^T\)
- Positional Encoding:\(\gamma(\mathbf{v})=[\cdots, \cos(2\pi\sigma^{j/m}\mathbf{v}),\sin(2\pi\sigma^{j/m}\mathbf{v}), \cdots]^T\) for \(j=0,\cdots,m-1\)
- Gaussian:\(\gamma(\mathbf{v})=[\cos(2\pi\mathbf{B}\mathbf{v}),\sin(2\pi\mathbf{B}\mathbf{v})]^T\),其中\(\mathbf{B}\in\mathbb{R}^{m\times d}\)的各个元素从\(\mathcal{N}(0,\sigma^2)\)中进行采样

根据实验结果,傅里叶特征映射后有明显提升,其中Gaussian效果最好。
总结
本文从理论上证明了三角函数构造的映射对MLP的帮助,实验结果上也验证了理论的正确性,是一项非常扎实的工作。笔者也是受本文的启发,对自己的工作进行了改进,确实有非常明显的提升。

 浙公网安备 33010602011771号