第一次个人编程作业
作业 GitHub 链接:https://github.com/LB-CC-summer/software-engineering-plagiarism-check/tree/main/3124004429
| 这个作业属于哪个课程 | 软件工程 |
|---|---|
| 这个作业要求在哪里 | https://edu.cnblogs.com/campus/gdgy/Class78-Grade2024-CS/homework/15702 |
| 这个作业的目标 | 使用 Python 完成支持命令行文件输入输出的论文查重程序,并通过 PSP、GitHub、单元测试、分支覆盖率、代码质量分析和性能分析实践个人软件开发流程。 |
| 学号 | 3124004429 |
第一次个人编程作业——论文查重
学号:3124004429
开发语言:Python 3
运行环境:Python 3.10 或更高版本
一、PSP 表格
开发前先记录预估时间,程序、测试、性能分析和报告完成后补充实际耗时。
| PSP2.1 | Personal Software Process Stages | 预估耗时(分钟) | 实际耗时(分钟) |
|---|---|---|---|
| Planning | 计划 | — | — |
| · Estimate | · 估计这个任务需要多少时间 | 20 | 18 |
| Development | 开发 | — | — |
| · Analysis | · 需求分析(包括学习新技术) | 40 | 45 |
| · Design Spec | · 生成设计文档 | 30 | 35 |
| · Design Review | · 设计复审 | 20 | 20 |
| · Coding Standard | · 代码规范(为目前的开发制定合适的规范) | 20 | 20 |
| · Design | · 具体设计 | 40 | 40 |
| · Coding | · 具体编码 | 120 | 150 |
| · Code Review | · 代码复审 | 30 | 35 |
| · Test | · 测试(自我测试,修改代码,提交修改) | 70 | 85 |
| Reporting | 报告 | — | — |
| · Test Report | · 测试报告 | 40 | 35 |
| · Size Measurement | · 计算工作量 | 15 | 15 |
| · Postmortem & Process Improvement Plan | · 事后总结,并提出过程改进计划 | 30 | 25 |
| 合计 | 475 | 523 |
实际总耗时比预估多 48 分钟。主要偏差出现在具体编码阶段,原因是课程
样例中的 orig_0.8_del.txt 和 orig_0.8_dis_*.txt 被浏览器保存成了
HTML 页面,需要额外实现正文提取和对应测试。性能优化和测试阶段基本
符合预估,最终按时完成全部材料。
二、需求分析
程序从命令行接收三个参数:原文文件绝对路径、抄袭版论文绝对路径和
答案文件绝对路径。程序读取前两个文本文件,计算 [0.0, 1.0] 区间内的
重复率,并在答案文件中写入保留两位小数的浮点数。
程序入口固定为 main.py,运行方式如下:
python main.py <原文文件> <抄袭版文件> <答案文件>
以课程样例为例:
python main.py samples\orig.txt samples\orig_0.8_add.txt samples\ans.txt
示例输出为:
0.80
Python 没有单独的编译产物,因此我使用 py_compile 对全部源文件进行
语法编译检查,再实际运行命令行程序。下图同时包含语法检查和运行结果。

)
程序运行过程中不访问网络,只读取三个参数指定的文件,并且只写答案
文件。对于参数数量错误、输入文件不存在、编码错误和答案路径不可写等
情况,程序会输出可读错误信息并返回非零退出码。
三、计算模块接口的设计与实现
3.1 代码组织
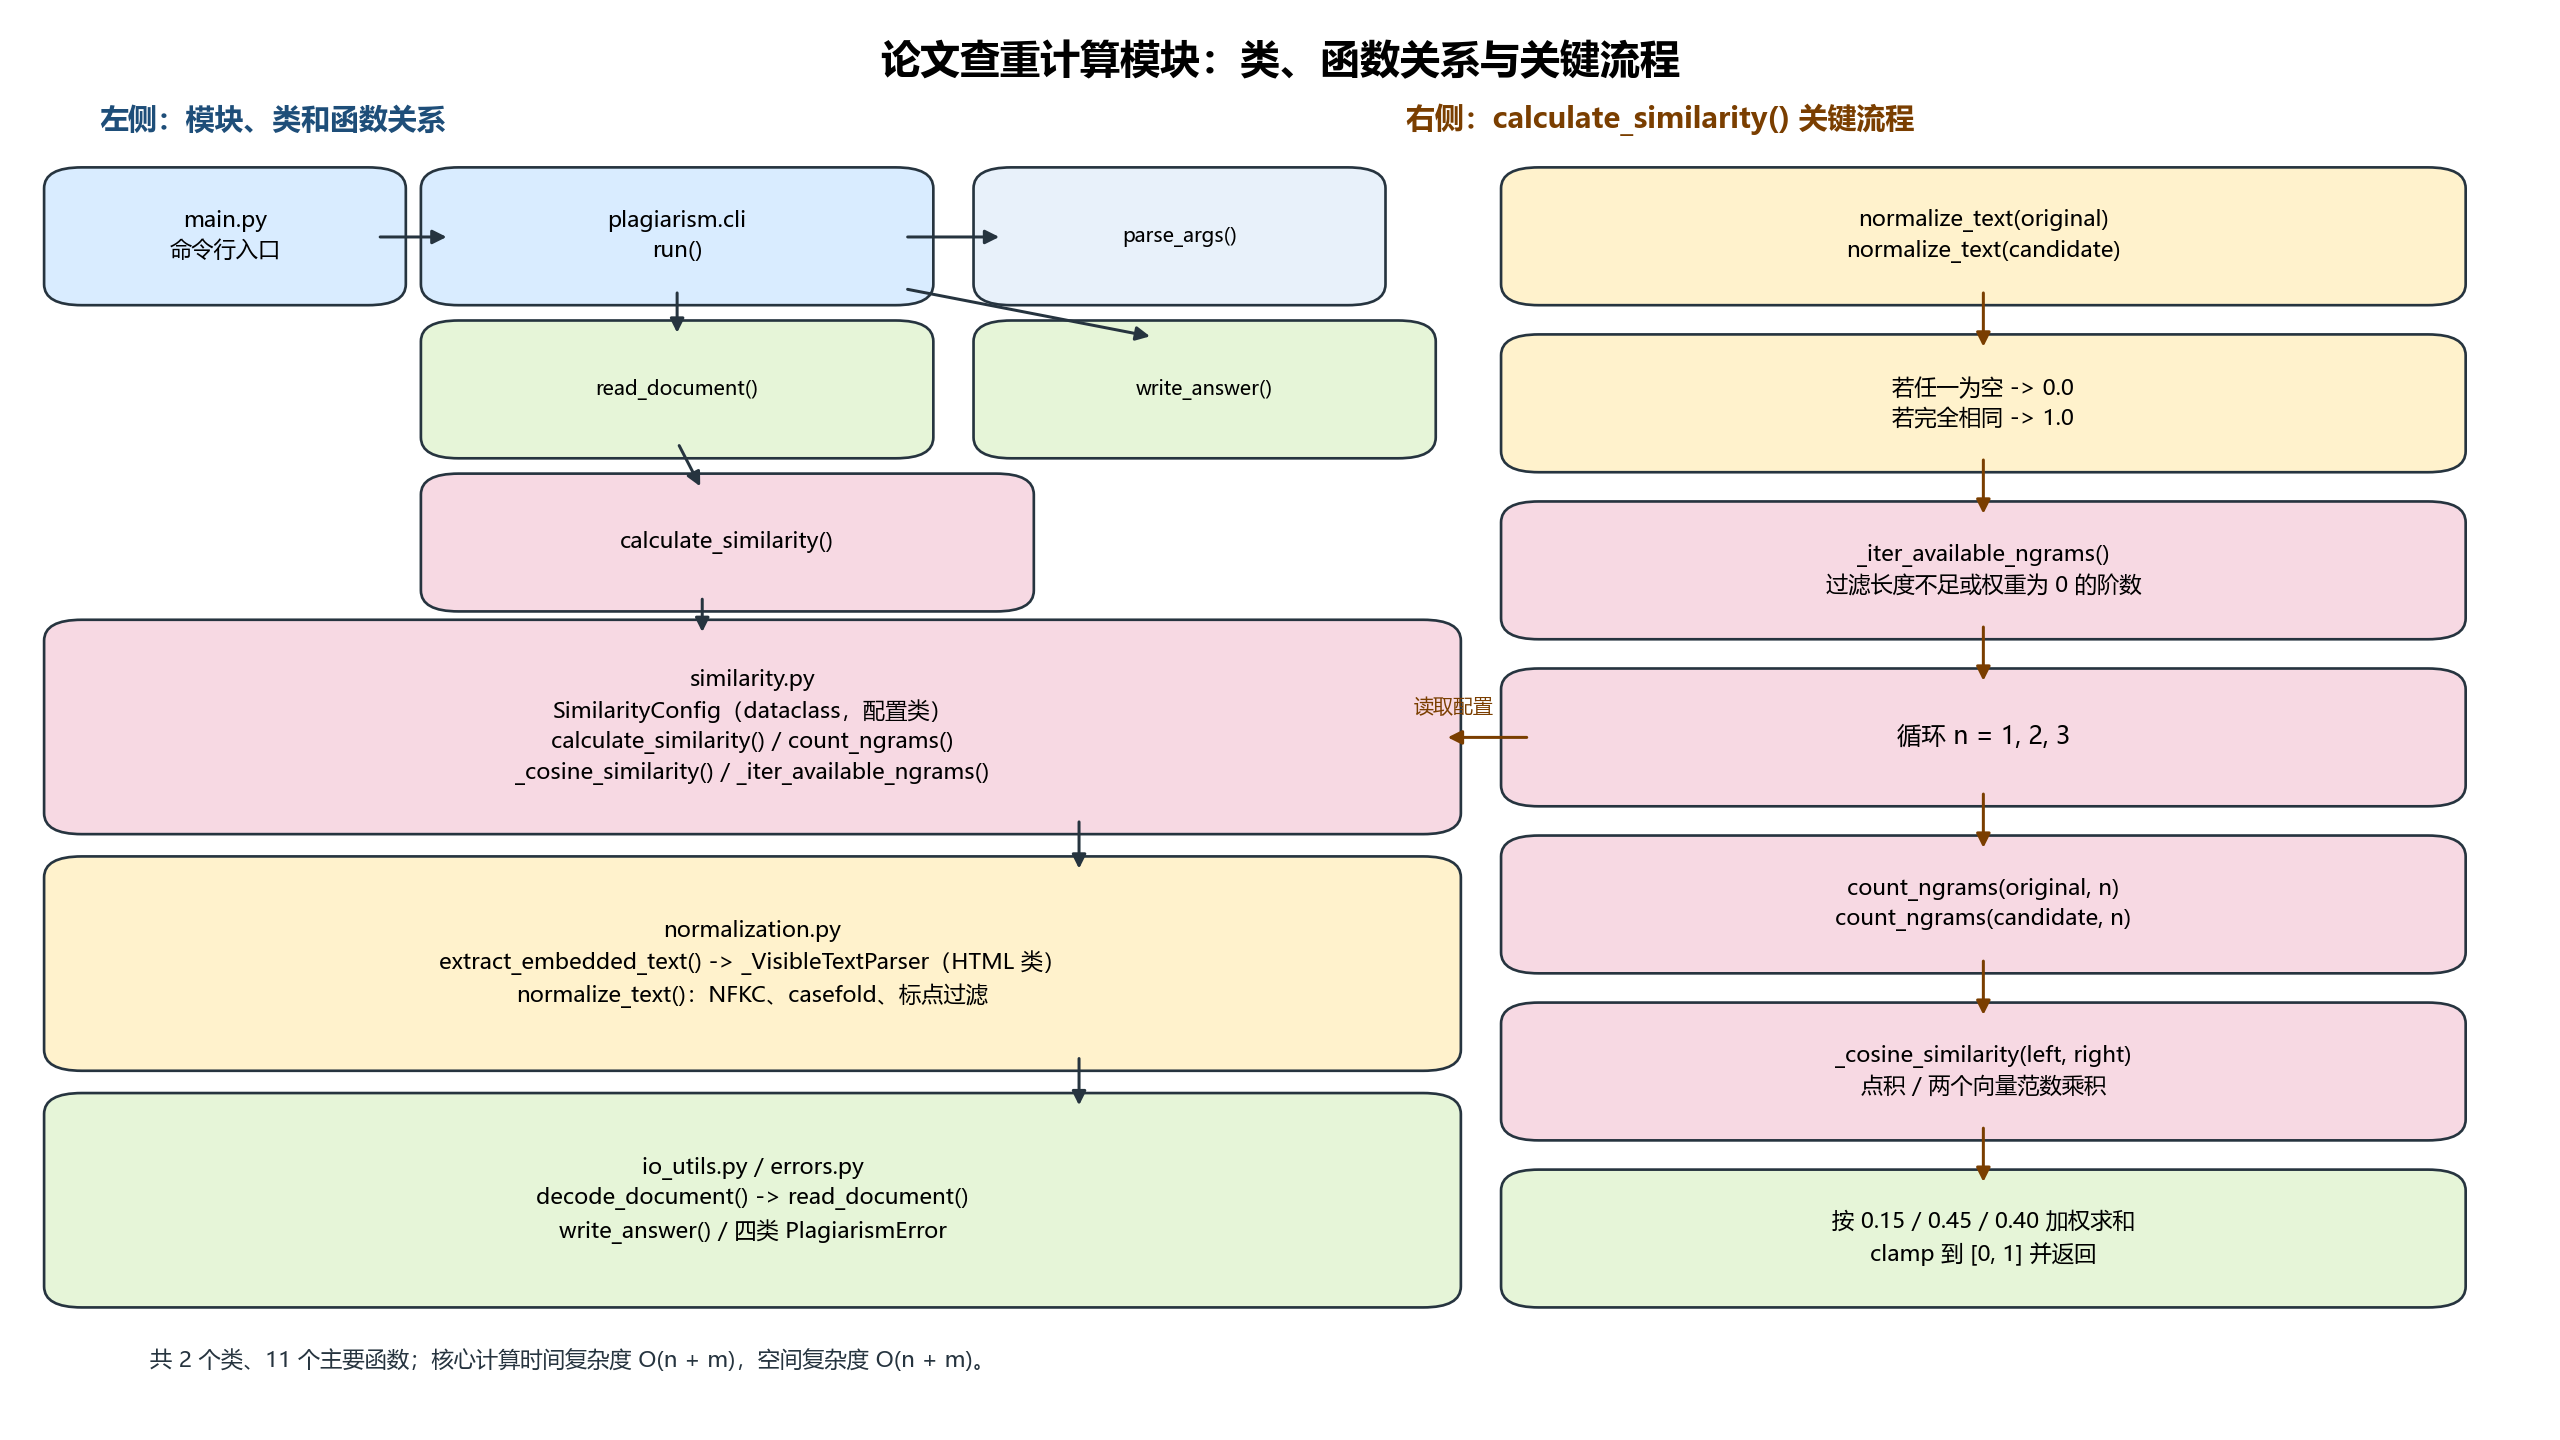
项目将命令行文件处理与相似度计算分离,主要模块如下:
命令行参数
    ↓
main.py
    └── plagiarism.cli.run()
          ├── parse_args():检查三个路径参数
          ├── read_document():读取并解码文本
          ├── calculate_similarity():计算重复率
          └── write_answer():写入两位小数
                    ↓
plagiarism.similarity
    ├── count_ngrams():统计字符 n-gram
    ├── _cosine_similarity():计算稀疏向量余弦相似度
    └── calculate_similarity():加权融合 1/2/3-gram
                    ↓
plagiarism.normalization
    ├── extract_embedded_text():提取 HTML 正文
    └── normalize_text():归一化文本
模块职责如下:
| 文件 | 主要职责 |
|---|---|
main.py |
命令行入口 |
plagiarism/cli.py |
参数校验、组织流程、统一异常处理 |
plagiarism/io_utils.py |
文件读取、编码识别、答案写入 |
plagiarism/normalization.py |
HTML 提取、Unicode 归一化、标点过滤 |
plagiarism/similarity.py |
n-gram 统计和余弦相似度 |
plagiarism/errors.py |
定义四类用户级异常 |
核心相似度函数接收两个字符串并返回 [0.0, 1.0] 的浮点数,因此不需要
为每个算法测试都创建文件。
项目共有 2 个类 和 11 个主要函数:
SimilarityConfig:不可变的 n-gram 权重配置类。_VisibleTextParser:提取网页另存文件中可见正文的 HTML 解析类。run()、parse_args():负责命令行参数和流程组织。read_document()、decode_document()、write_answer():负责文件输入输出。extract_embedded_text()、normalize_text():负责正文提取和文本归一化。count_ngrams()、_cosine_similarity()、_iter_available_ngrams()、
calculate_similarity():负责核心查重计算。
函数之间的调用关系是:run() 调用 parse_args() 和
read_document(),随后调用 calculate_similarity();后者调用
normalize_text(),再对 1/2/3-gram 分别调用 count_ngrams() 和
_cosine_similarity(),最后按权重融合并调用 write_answer()。
3.2 程序入口和执行流程
main.py 只负责调用命令行入口:
from plagiarism.cli import run

if __name__ == "__main__":
    raise SystemExit(run())
run() 的工作流程如下:
读取命令行参数
    ↓
检查参数数量是否为 3
    ↓
读取原文和抄袭版文本
    ↓
提取 HTML 正文并归一化
    ↓
生成 1-gram、2-gram、3-gram
    ↓
计算余弦相似度并加权融合
    ↓
保留两位小数写入答案文件
参数数量错误返回退出码 2;文件和编码错误返回退出码 2;正常完成
返回退出码 0。
3.3 文本规范化
中文文本没有天然空格,使用第三方分词器又会增加依赖和模型加载时间,
因此本项目采用语言无关的字符级比较。规范化步骤如下:
- 如果输入是浏览器保存的 GitHub HTML 页面,先提取代码行表格中的正文。
- 使用 Unicode
NFKC统一全角字符和兼容字符。 - 使用
casefold()统一英文大小写。 - 删除空格、换行、标点和下划线。
- 保留汉字、英文字母和数字。
关键代码如下:
def normalize_text(text: str) -> str:
    if not text:
        return ""
    source = extract_embedded_text(text)
    normalized = unicodedata.normalize("NFKC", source).casefold()
    return "".join(character for character in normalized if character.isalnum())
因此,只有标点、空白、全角字符或英文大小写不同的文本会被视为相同
内容;被另存为 HTML 的课程样例也可以直接作为输入。
3.4 字符 n-gram
以“今天是星期天”为例,二元组为:
今天、天是、是星、星期、期天
三元组为:
今天是、天是星、是星期、星期天
程序同时使用 1-gram、2-gram 和 3-gram:
- 1-gram 对局部增删更宽容。
- 2-gram 保留词语搭配和局部顺序。
- 3-gram 对语序变化更敏感。
统计函数如下:
def count_ngrams(text: str, n: int) -> Counter[str]:
    if n <= 0:
        raise ValueError("n must be positive")
    if len(text) < n:
        return Counter()
    return Counter(text[index : index + n] for index in range(len(text) - n + 1))
3.5 余弦相似度
程序使用 Counter 统计每个 n-gram 的出现次数,将文本表示为稀疏频率
向量。余弦相似度公式为:
cos(A, B) = (A · B) / (||A|| × ||B||)
最终分数采用如下权重:
重复率 = 0.15 × 1-gram 相似度
       + 0.45 × 2-gram 相似度
       + 0.40 × 3-gram 相似度
2-gram 和 3-gram 合计占 85%,因此算法能够感知语序变化;保留 15% 的
1-gram,使分数不会因为少量删除或替换而急剧下降。
计算点积时只遍历较小的字典:
def _cosine_similarity(
    left: Counter[str],
    right: Counter[str],
) -> float:
    if not left or not right:
        return 0.0
    if len(left) > len(right):
        left, right = right, left

    dot_product = sum(count * right.get(ngram, 0) for ngram, count in left.items())
    left_norm = sqrt(sum(count * count for count in left.values()))
    right_norm = sqrt(sum(count * count for count in right.values()))
    return dot_product / (left_norm * right_norm)
对于长度分别为 n 和 m 的两篇文本,核心算法的时间复杂度为
O(n + m),空间复杂度为 O(n + m)。
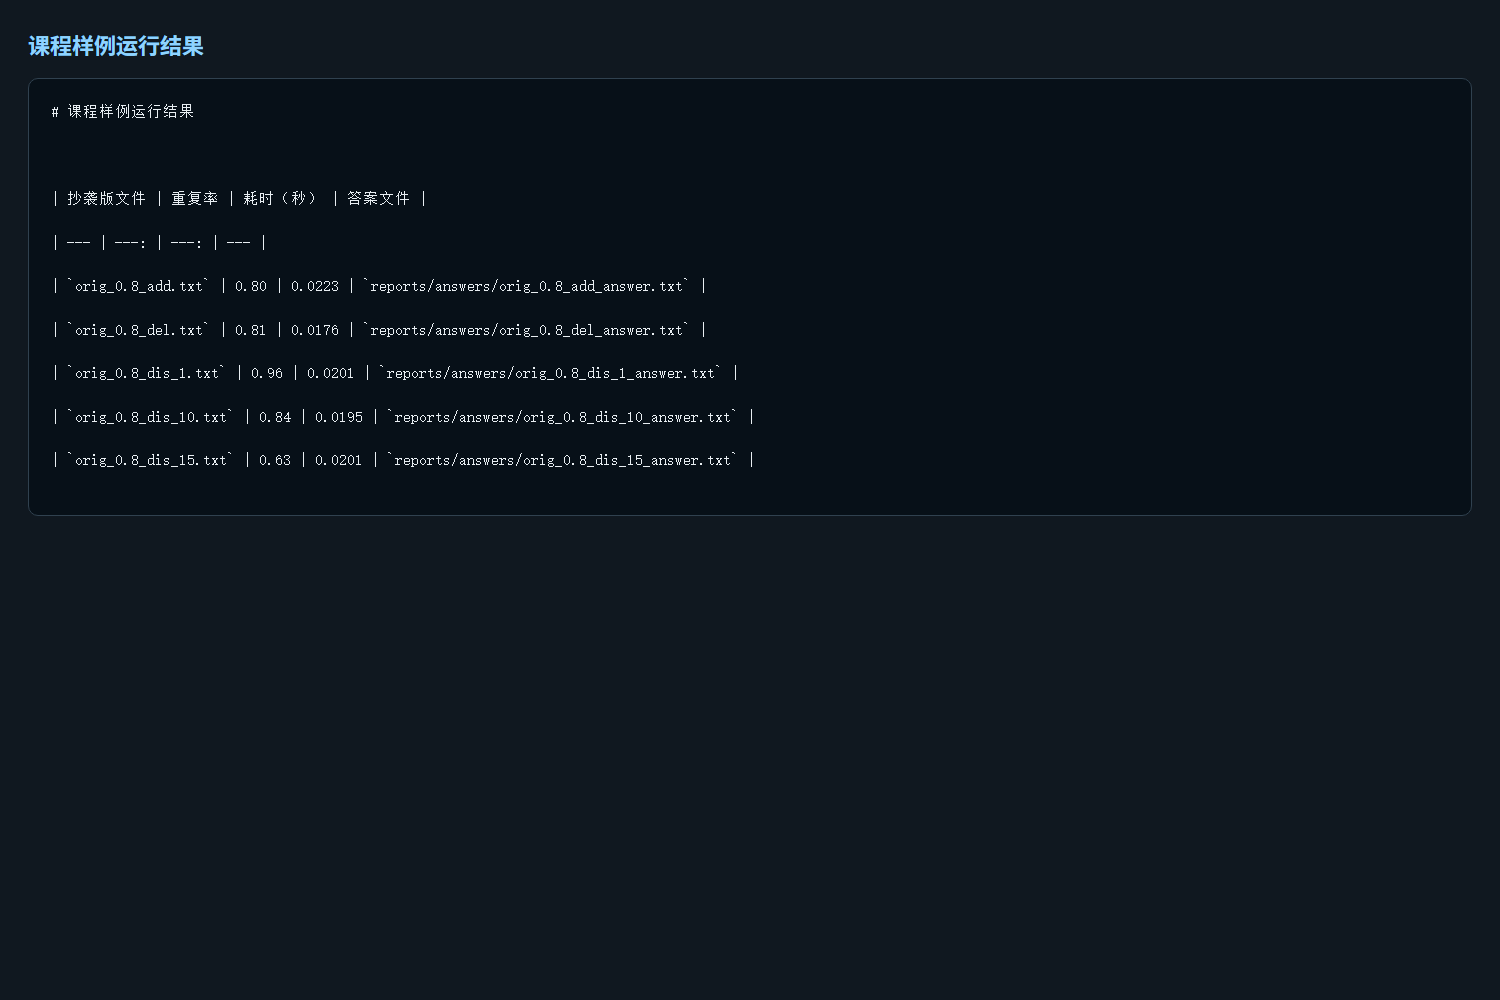
3.6 课程样例结果
| 抄袭版文件 | 重复率 |
|---|---|
orig_0.8_add.txt |
0.80 |
orig_0.8_del.txt |
0.81 |
orig_0.8_dis_1.txt |
0.96 |
orig_0.8_dis_10.txt |
0.84 |
orig_0.8_dis_15.txt |
0.63 |
结果符合样例文件表达的趋势:增加和删除内容后约为 0.80,轻度打乱仍
接近 1.00,打乱程度越大,重复率越低。
四、计算模块性能分析与改进
4.1 优化前的性能分析
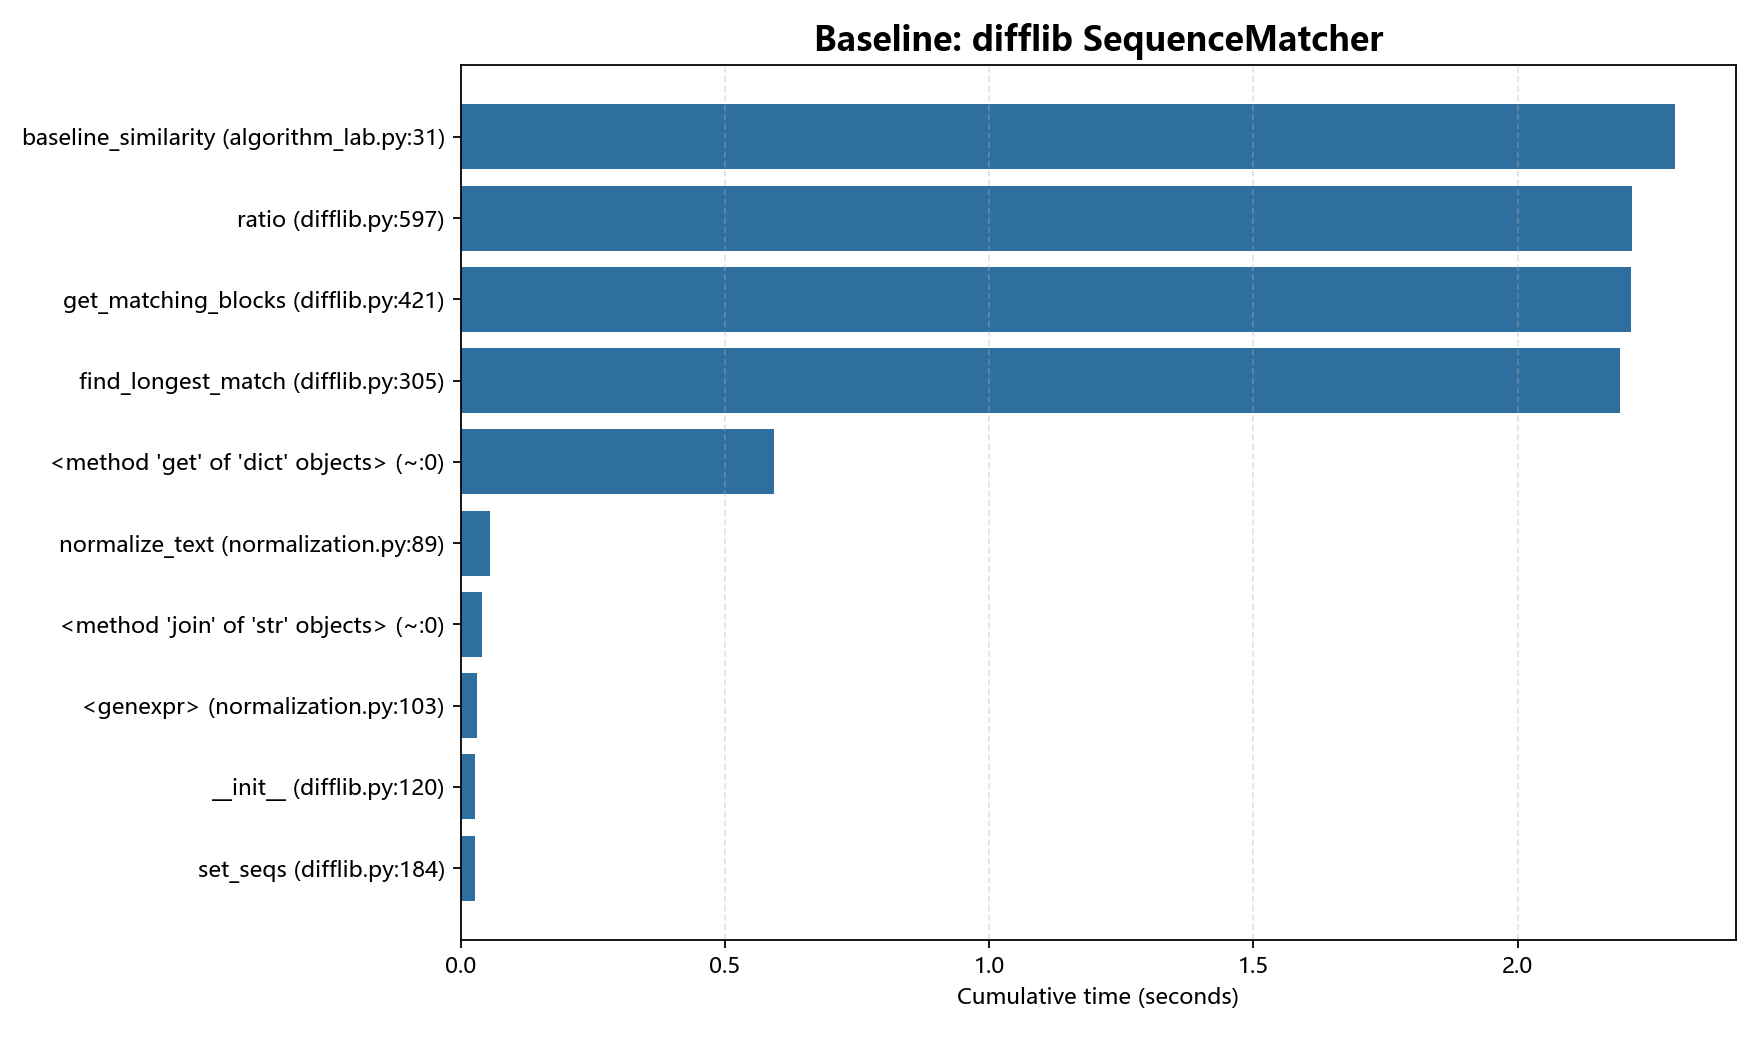
第一个可运行版本使用 difflib.SequenceMatcher 计算最长匹配块。该实现
代码短、容易验证,但 find_longest_match() 在大文本上会退化为平方级
复杂度,无法稳定满足 5 秒限制。
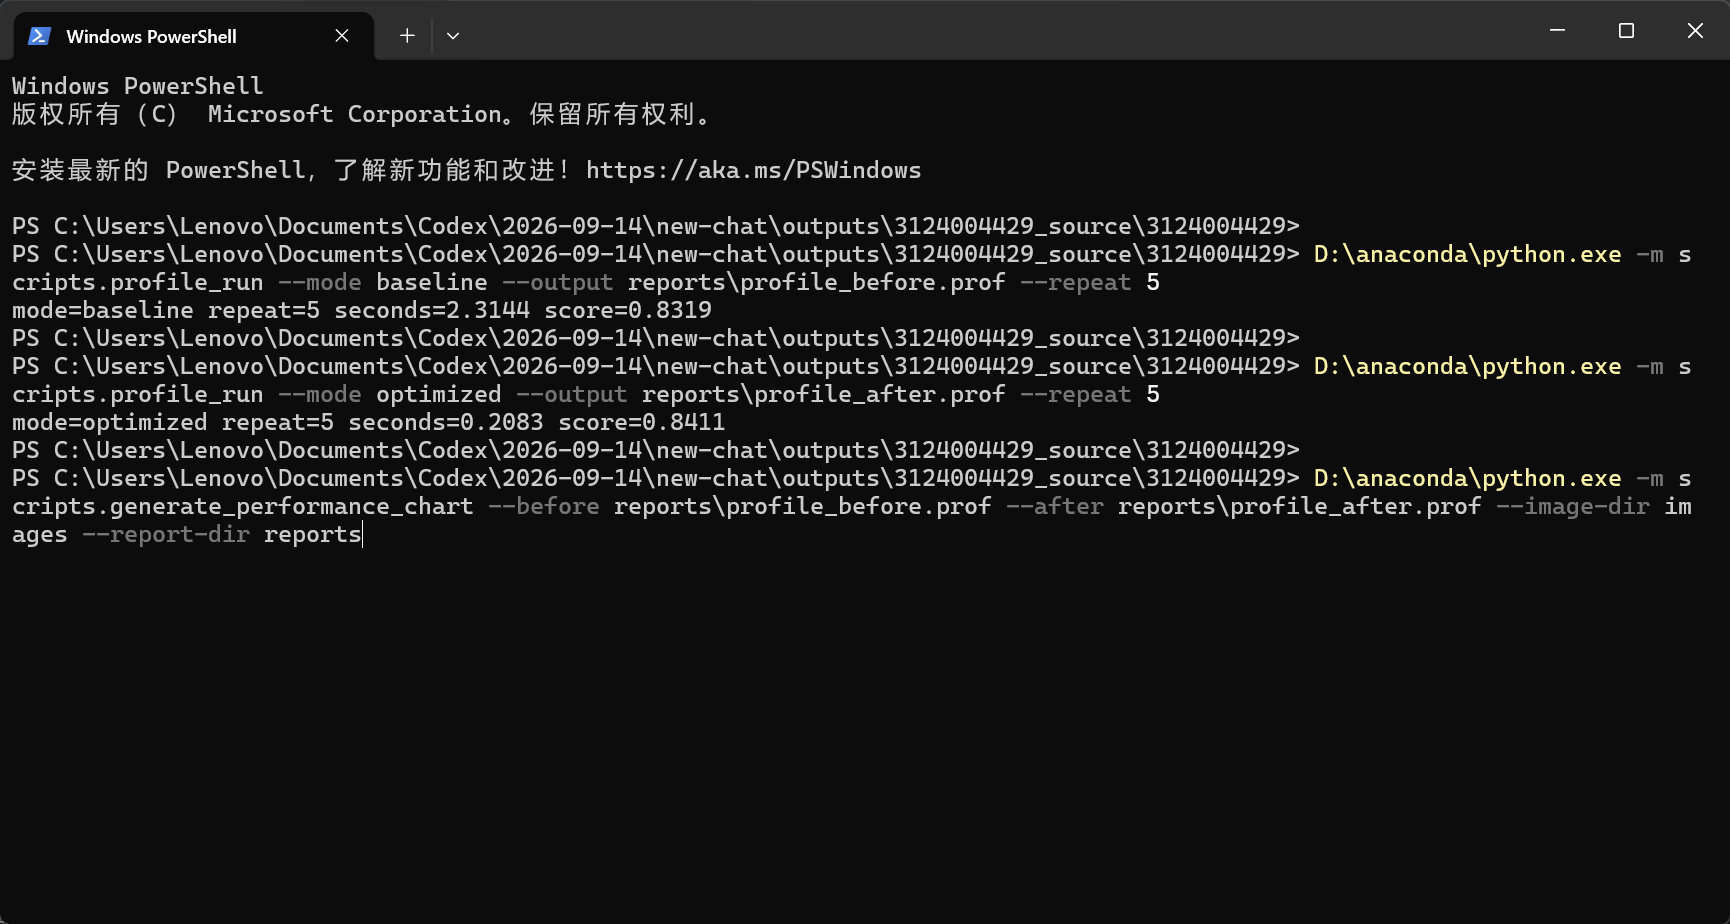
使用 cProfile 对核心函数执行 5 次,优化前累计耗时最高的函数为:
difflib.py:305(find_longest_match)   cumtime 2.194s
difflib.py:421(get_matching_blocks)  cumtime 2.215s
difflib.py:597(ratio)                cumtime 2.216s
这说明瓶颈不在文本读取或归一化,而在序列匹配算法本身。
4.2 优化方法
我把算法替换为线性时间的多阶字符 n-gram 余弦相似度,并进行了以下改进:
- 使用 1-gram、2-gram、3-gram 的稀疏词频向量,不再维护匹配块。
- 使用
Counter统计特征,避免构造稠密矩阵。 - 计算余弦时只遍历较小的字典,减少哈希查询。
- 对长度不足的 n-gram 自动跳过,避免空向量。
- 对空文本、完全相同文本提前返回,减少无效计算。
性能分析入口脚本为 profile_checker.py:
python profile_checker.py
脚本连续执行 10 次查重,输出累计耗时最高的函数,并生成 profile.prof
文件。
4.3 优化后的结果
优化后,计算热点转移到真正必要的 n-gram 统计和余弦计算:
calculate_similarity   cumtime 0.199s
count_ngrams           cumtime 0.091s
_cosine_similarity     cumtime 0.054s
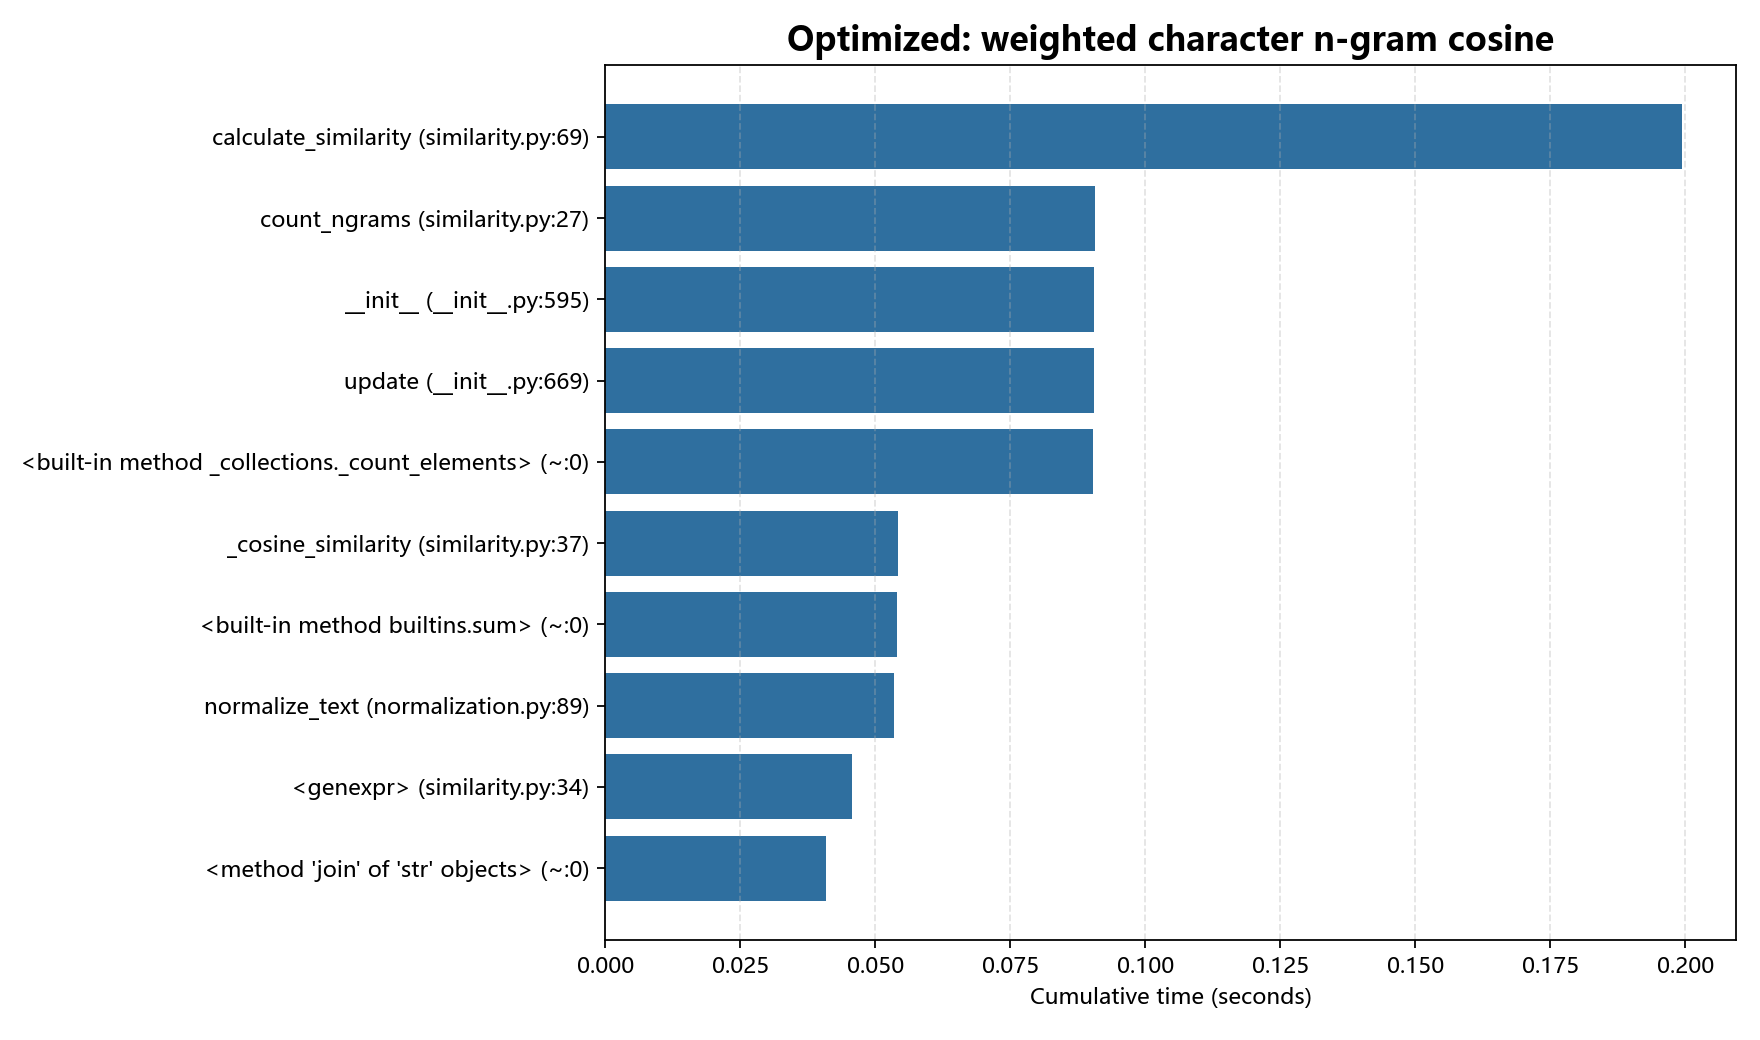

相同输入下的实测结果如下:
| 算法 | 文本规模 | 耗时(秒) |
|---|---|---|
difflib 基线 |
8,493 字符 | 0.2345 |
| n-gram 优化版 | 8,493 字符 | 0.0193 |
difflib 基线 |
16,986 字符 | 0.8621 |
| n-gram 优化版 | 16,986 字符 | 0.0347 |
difflib 基线 |
42,465 字符 | 10.5560 |
| n-gram 优化版 | 42,465 字符 | 0.1571 |
表中为每个组合运行 3 次后的最佳耗时。在 42,465 字符输入上,耗时从
10.5560 秒降到 0.1571 秒,约加速 67 倍,从超时变为远低于 5 秒限制。

五、单元测试与覆盖率
5.1 测试设计
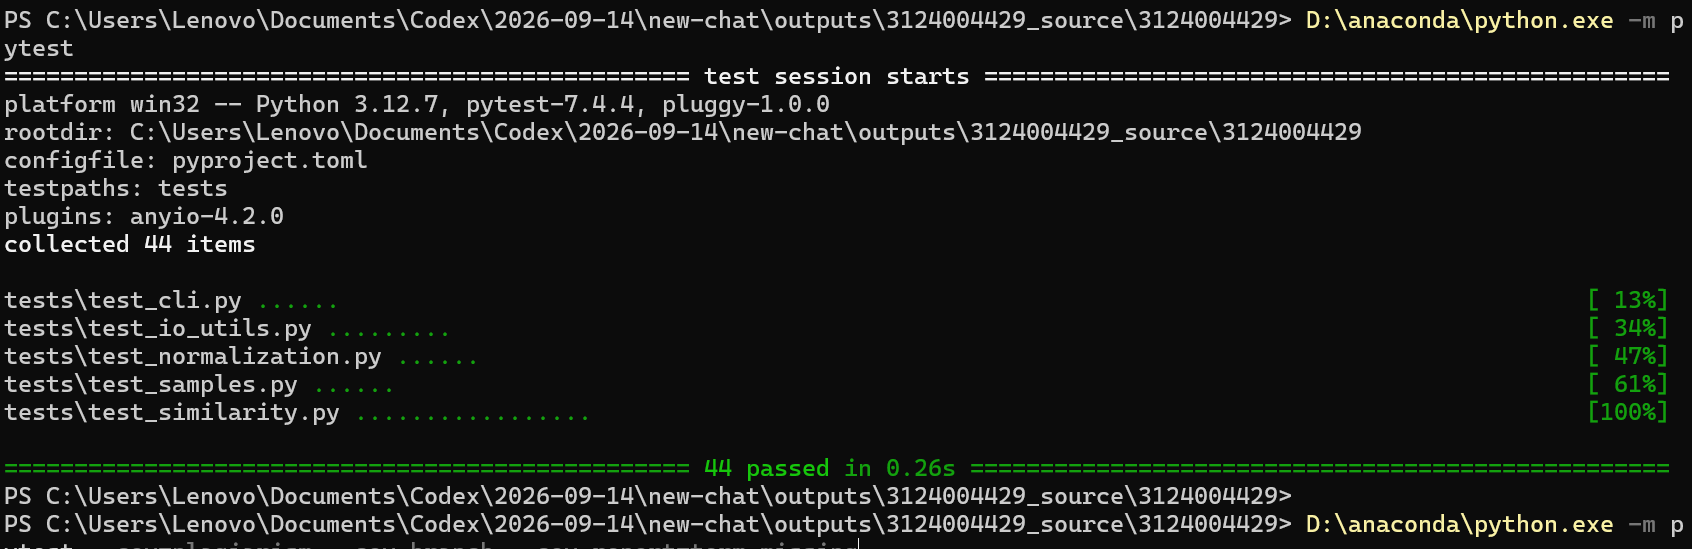
项目使用 pytest 编写了 44 个单元测试,按职责分为五个文件:
| 测试文件 | 覆盖内容 |
|---|---|
test_similarity.py |
算法、边界、对称性、自定义权重 |
test_normalization.py |
Unicode、HTML 正文提取、标点过滤 |
test_io_utils.py |
UTF-8/GB18030、缺失文件、写入异常 |
test_cli.py |
参数、答案文件、退出码 |
test_samples.py |
课程样例集成结果和性能 |
代表性的算法测试如下:
def test_synonym_example_is_detected_as_similar() -> None:
    original = "今天是星期天,天气晴,今天晚上我要去看电影。"
    candidate = "今天是周天,天气晴朗,我晚上要去看电影。"
    assert calculate_similarity(original, candidate) > 0.5
文件输入输出测试如下:
def test_cli_writes_answer_and_prints_score(tmp_path, capsys):
    original = tmp_path / "orig.txt"
    candidate = tmp_path / "copy.txt"
    answer = tmp_path / "answer.txt"
    original.write_text("今天是星期天,天气晴。", encoding="utf-8")
    candidate.write_text("今天是星期天,天气晴朗。", encoding="utf-8")

    exit_code = run([str(original), str(candidate), str(answer)])

    captured = capsys.readouterr()
    assert exit_code == 0
    assert answer.read_text(encoding="utf-8").strip() == captured.out.strip()
测试构造了完全相同、完全不同、标点差异、大小写差异、局部增加、局部
删除、语序打乱、同义改写、空文本、单字符、全角字符、重复内容、HTML
输入、编码回退和所有异常分支。
5.2 测试结果
执行命令:
python -m pytest
最终结果为:
44 passed in 1.13s
5.3 分支覆盖率
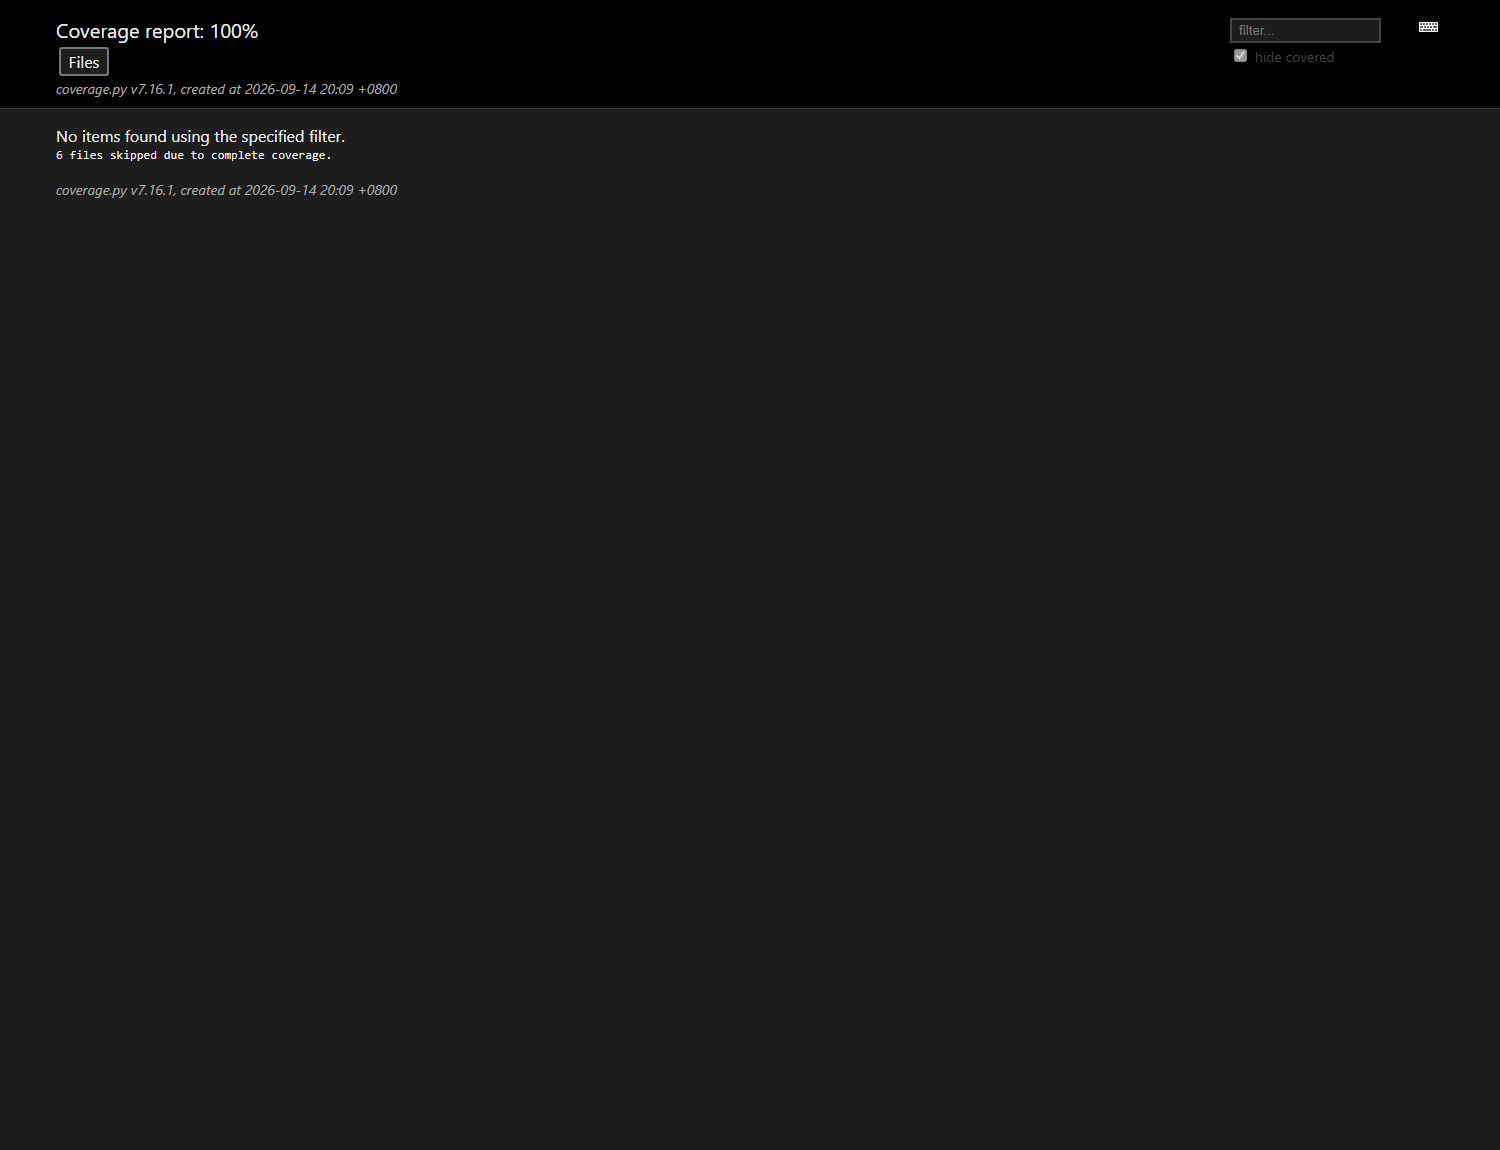
执行以下命令统计语句覆盖率和分支覆盖率:
python -m pytest --cov=plagiarism --cov-branch --cov-report=term-missing
python -m pytest --cov=plagiarism --cov-branch --cov-report=html
最终结果:
TOTAL 165 statements 0 miss 48 branches 0 partial 100%
HTML 报告保存在 htmlcov/index.html,其中项目全部模块均达到 100% 覆盖。
六、异常处理
所有可预期异常都继承自 PlagiarismError,由 plagiarism/cli.py 统一
捕获。程序不打印冗长堆栈,而是输出带 error: 前缀的可读信息,并返回
退出码 2。错误发生时不创建答案文件,避免产生误导性结果。
6.1 参数数量错误
当参数不是恰好三个时,程序输出 usage 并返回退出码 2。
def test_cli_requires_exactly_three_arguments(capsys) -> None:
    exit_code = run(["only-one.txt"])
    captured = capsys.readouterr()
    assert exit_code == 2
    assert "usage:" in captured.err
6.2 输入文件不存在或无法读取
路径不存在、不是普通文件或读取失败时,read_document() 抛出
DocumentReadError:
if not path.exists():
    raise DocumentReadError(f"输入文件不存在:{path}")
if not path.is_file():
    raise DocumentReadError(f"输入路径不是文件:{path}")
对应测试场景为 test_missing_document_raises_read_error 和
test_read_error_is_wrapped。
6.3 文件编码错误
程序优先识别 UTF-8、UTF-8 BOM 和 UTF-16,随后回退到 GB18030。如果
UTF-16 BOM 损坏或所有编码均无法解码,则抛出 DocumentDecodeError,
提示无法解码,并返回退出码 2。
if raw.startswith(_UTF16_BOMS):
    try:
        return raw.decode("utf-16")
    except UnicodeDecodeError as exc:
        raise DocumentDecodeError(f"无法按 UTF-16 解码文件:{source}") from exc
对应测试为 test_malformed_utf16_bom_raises_decode_error。
6.4 答案文件无法写入
答案路径是目录、父目录不存在或没有写权限时,write_answer() 抛出
AnswerWriteError,程序返回退出码 2,并且不会输出错误结果。
def test_write_answer_to_directory_raises_write_error(tmp_path: Path) -> None:
    with pytest.raises(AnswerWriteError, match="无法写入"):
        write_answer(tmp_path, 0.5)
七、代码质量分析
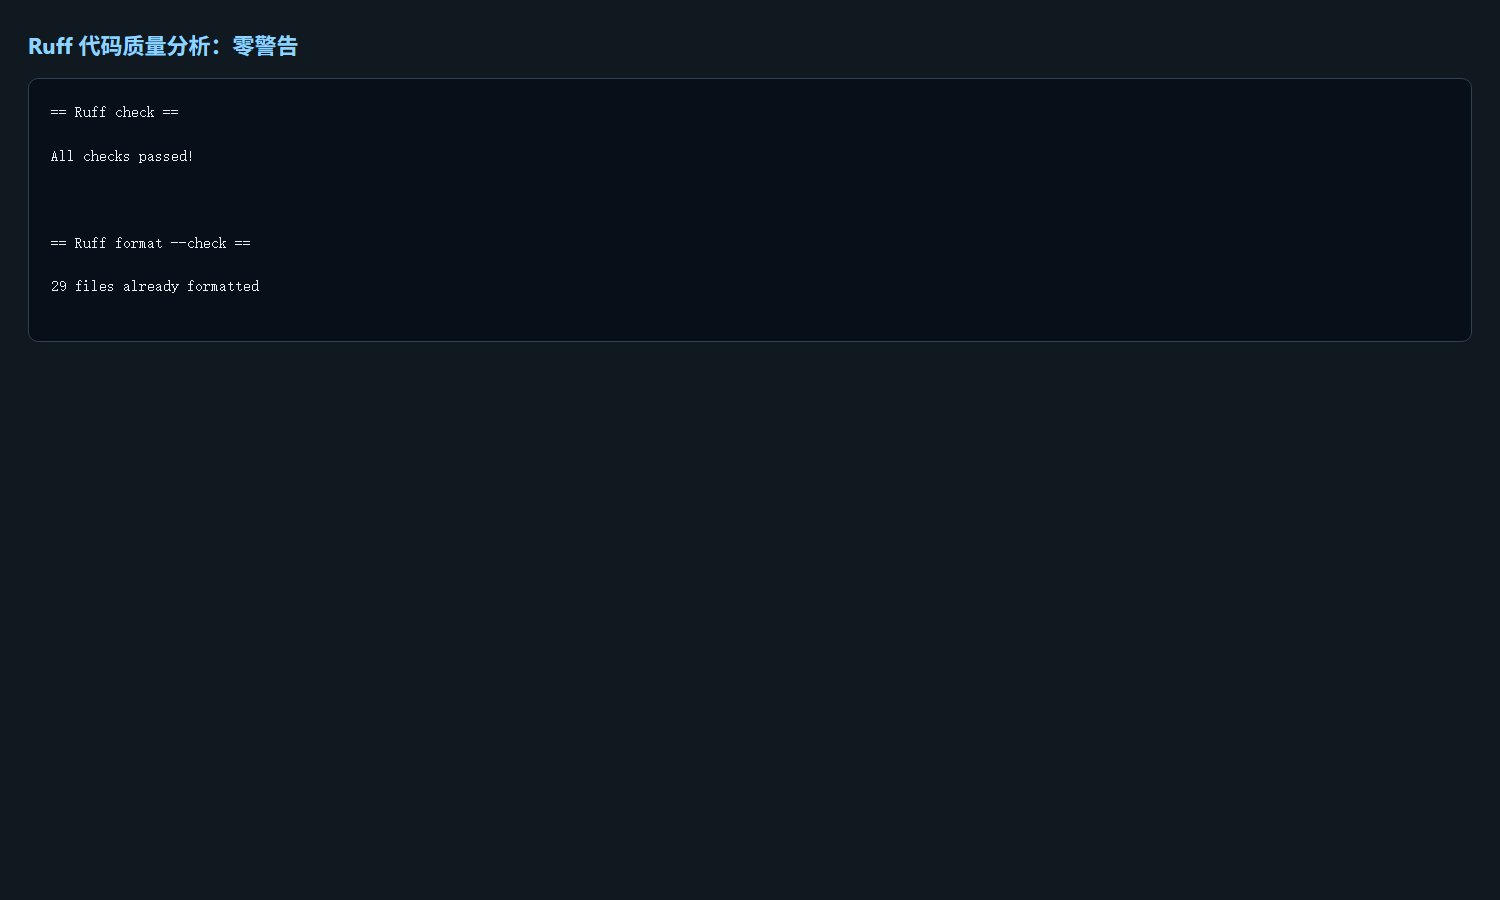
项目使用 Ruff 进行静态代码质量分析,检查规则包含 E、F、I、
N、UP、B、SIM、C4、PTH 和 RUF。
python -m ruff check .
python -m ruff format --check .
第一次检查发现导入顺序和一个嵌套 with 警告,修复后结果为:
All checks passed!
29 files already formatted
八、项目结构
3124004429
├── main.py                    # 命令行入口
├── plagiarism
│   ├── cli.py                 # 参数、流程和异常处理
│   ├── errors.py              # 异常类型
│   ├── io_utils.py            # 文件读写和编码识别
│   ├── normalization.py       # HTML 提取和文本归一化
│   └── similarity.py          # n-gram 和余弦相似度
├── profile_checker.py         # cProfile 性能分析脚本
├── tests                      # 44 个单元测试
├── samples                    # 课程样例和答案示例
├── scripts                    # 基准测试、图表和截图脚本
├── reports                    # 测试、覆盖率、性能和样例报告
├── images                     # 博客使用的截图和图表
├── docs                       # 设计、测试报告和博客草稿
├── README.md                  # 项目运行说明
├── PSP.md                     # PSP 2.1 记录
├── requirements.txt           # 测试和质量工具依赖
└── pyproject.toml             # pytest、coverage 和 Ruff 配置
完整源代码已经提交到 GitHub,可以直接在本地运行:
python -m pip install -r requirements.txt
python main.py samples\orig.txt samples\orig_0.8_add.txt samples\ans.txt
python -m pytest
python profile_checker.py
九、总结与改进计划
本次实现完成了从命令行输入、文本规范化、n-gram 特征提取、余弦相似度
计算、答案文件输出到异常处理的完整流程。最终程序在课程样例上给出了
0.80、0.81、0.96、0.84、0.63 的结果,44 个测试全部通过,分支覆盖率
达到 100%,Ruff 静态检查零警告。
性能优化是本次项目中收获最大的部分。基线 difflib 算法在 42,465
字符输入上最佳耗时 10.5560 秒,无法满足 5 秒要求;改为稀疏 n-gram
余弦后最佳耗时降到 0.1571 秒,约加速 67 倍。这说明性能问题必须依靠真实分析
数据定位,而不能只凭主观判断。
后续可以继续改进以下方面:
- 使用滚动哈希替代字符串切片,进一步减少 n-gram 内存分配。
- 对超长文本增加分块统计和并行计算。
- 在保留标准库快速算法的同时,提供可选的语义相似度模型。
- 增加更多真实论文样例,评估算法在不同学科文本上的准确度。

 浙公网安备 33010602011771号