
 组合计数与DP
- Combinatorics Problem
- [COCI2019-2020#5] Zapina
- [POI 2021/2022 R3] 小矮人派对 2 / Impreza krasnali 2
- [HAOI2011] Problem c
- 「NOIP2021」数列
- Piratski kod
- 「HAOI2018」苹果树
- 「JOISC 2018 Day 1」帐篷
- agc005D - ~K Perm Counting
- 「HEOI2014」平衡
- [USACO 2020 December, Platinum] Problem 1. Sleeping Cows
- [ZJOI2010] 排列计数
- P2606 [ZJOI2010] 排列计数 详解
- 「PA 2020」Malowanie płotu
- 「PA 2024」Bardzo Ulubiony Ciąg
Combinatorics Problem
设 \(f[t][i]=\sum_{j=1}^{i}\binom{i-j+1}{t}a_j\),答案就是 \(f[k][i]\)。
\(t=1\):两次前缀和
pre[i]=pre[i-1]+a[i];
f[1][i]=f[1][i-1]+pre[i];
\(t\ge2\):递推
代入得:
(因为 \(\binom{1}{t}=0\),\(t\ge2\) 时 \(a_i\) 那项消失。)
直觉:\(f[t]\) 就是 \(f[t-1]\) 再做一次前缀和(错一位)。
[COCI2019-2020#5] Zapina
思路:
分类讨论第 \(i\) 个人
情况 1:第 \(i\) 个人开心(恰好得 \(i\) 道题)
- 从 \(j\) 道题里选 \(i\) 道给他:\(\binom{j}{i}\)
- 剩下 \(j-i\) 道题分给前 \(i-1\) 个人,每人任意(不要求他们开心):\((i-1)^{j-i}\)
情况 2:第 \(i\) 个人不开心(得 \(k\) 道,\(k\ne i\))
- 从 \(j\) 道题里选 \(k\) 道给他:\(\binom{j}{k}\)
- 剩下 \(j-k\) 道给前 \(i-1\) 人,且他们中至少一人开心:\(dp[i-1][j-k]\)
两者相加就是 \(dp[i][j]\),不重不漏。
边界
dp[1][1]=1,其余 dp[1][j]=0(第 1 人开心当且仅当得 1 道)。
答案 dp[n][n]。
[POI 2021/2022 R3] 小矮人派对 2 / Impreza krasnali 2
一、核心转化:窗口约束
小矮人 \(i\) 说「\(h_i\) 是我、左邻或右邻的帽子」,等价于:
对每个值 \(v\),把它在 \(h\) 中出现的所有位置求交,得到窗口 \([L_v,R_v]\)。合法排列 ⟺ 每个 \(v\) 恰好放在自己的窗口内,且每位置恰放一个值。
二、开头的合法性检查
if(cnt[i]>3)gg();
if(cnt[i]==3&&(vec[i][2]-vec[i][1]>1||vec[i][1]-vec[i][0]>1))gg();
if(cnt[i]==2&&vec[i][1]-vec[i][0]>2)gg();
| 情况 | 窗口 | 说明 |
|---|---|---|
| 出现 1 次 \(i\) | \([i-1,i+1]\) | 长 3 |
| 出现 2 次相邻 \(i,i+1\) | \([i,i+1]\) | 长 2 |
| 出现 2 次隔一 \(i,i+2\) | \(\{i+1\}\) | 长 1(强制) |
| 出现 3 次连续 \(i,i+1,i+2\) | \(\{i+1\}\) | 长 1(强制) |
- 出现 >3 次:窗口必空 → 0
- 出现 3 次不连续:窗口必空 → 0
- 出现 2 次距离 >2:窗口必空 → 0
这三个检查过后,每个值的窗口都非空。 这是无解判定的完整条件。
三、DP 状态
f[i][0..4]
f[i][s] = 处理完前 \(i\) 个位置、当前"局部配置"为 \(s\) 的方案数。
根据转移反推(下面用 n=3, a=[1,2,3] 追踪验证),状态大致表示:
| 状态 | 含义(近似) |
|---|---|
| 0 | \(p_i\) 已确定且与 \(a_i\) 的重复块合并完毕(稳定态) |
| 1 | \(p_i=a_{i-1}\),用"上一个待定值",解除待定 |
| 2 | \(p_i=a_i\),用"自己",单次值 |
| 3 | \(p_i=a_{i+1}\),但 \(a_i\) 不属于待定(\(a_i\) 是重复块的一部分) |
| 4 | \(p_i=a_{i+1}\),用"下一个",\(a_i\) 待定 |
初始:
f[1][2]=f[1][4]=1;
位置 1 有两种起步:\(p_1=a_1\)(状态 2)或 \(p_1=a_2\)、\(a_1\) 待定(状态 4)。
四、转移按 \(a[i-2],a[i-1],a[i]\) 的相等模式分类
Case 1:三连续 \(a_{i-2}=a_{i-1}=a_i\)
值 \(x\) 窗口 \(\{i-1\}\),强制 \(p_{i-1}=x\)。于是 \(p_i\) 不能用 \(x\),只能取 \(a_{i+1}\) 或后续,转为稳定态:
f[i][0]=f[i-1][2];
Case 2:隔一相等 \(a_{i-2}=a_i\ne a_{i-1}\)
值 \(x=a_{i-2}=a_i\) 窗口 \(\{i-1\}\),强制 \(p_{i-1}=x\)。这消耗掉一个"待定",同时产生新的:
f[i][0]=f[i-1][1];   // 用上一个待定值满足强制位
f[i][1]=f[i-1][3];   // 新待定延续
Case 3:双块开始 \(a_{i-1}=a_i\)(且 \(a_{i-2}\ne a_i\))
值 \(x\) 窗口 \([i-1,i]\),二选一:
f[i][0]=f[i-1][2];            // 若 p_{i-1}=a_{i-1},则 p_i 必须换别的
f[i][2]=f[i-1][3]+f[i-1][4];  // 若 p_{i-1}=a_i(用了"下一个"),则 p_i 用自己
Case 4:全不等
f[i][0]=f[i-1][0];                          // 稳定态延续
f[i][1]=f[i-1][4];                          // 用上一个待定
f[i][2]=f[i-1][1]+f[i-1][0]+f[i-1][2];      // 用自己
f[i][3]=f[i-1][3]+f[i-1][4];                // 用下一个(非待定)
f[i][4]=f[i-1][0]+f[i-1][1]+f[i-1][2];      // 用下一个(待定)
这是经典的"每位置偏差 ≤1 的排列"转移,对应 Fibonacci 结构。
五、答案与无约束值
ans=f[n][0]+f[n][1]+f[n][2];
for(int i=1;i<=n-sum;i++)ans=1ll*ans*i%mod;
- 终止只取状态 0,1,2:位置 \(n\) 不能"用下一个"(没有 \(a_{n+1}\)),所以状态 3,4 作废。
sum= 不同值个数 = 有约束值个数;\(n-sum\) = 无约束值个数。- 有约束值放完后,剩余 \(n-sum\) 个无约束值在剩余 \(n-sum\) 个位置任意排列:乘 \((n-sum)!\)。
[HAOI2011] Problem c
无解
如果一个人的编号为\(i\),那么他只能坐\(i,i+1...n\)的位置上,这里一共有\(n−i+1\)个座位
可是如果这\(n−i+1\)个座位都挤满了人,这道题就无解了
那么我们可以用 \(sum_i\) 是编号必须 \(>=i\) 的人数,即若\(sum_i>n−i+1\),直接输出NO
有解
设 \(f[i][l]\) 表示剩余 \(n−m\) 人中编号 \(≥i\) 的人已经确定 \(j\) 个人的编号的方案数,则:
即表示在已经确定 \(j−k\) 人编号的情况下,再选择 \(k\) 人确定编号为 \(i\) 。
答案即为 \(f[1][n−m]\)
「NOIP2021」数列
一、题意重述
给定 \(n,m,k\) 和 \(v_0,\dots,v_m\)。统计所有长度为 \(n\)、每项 \(a_i\in[0,m]\) 的序列,满足
的二进制中 \(1\) 的个数 \(\le k\),求所有合法序列的权值 \(\prod v_{a_i}\) 之和,模 \(998244353\)。
\(n\le30\),\(m\le100\),\(k\le n\)。
二、核心转化:从“枚举序列”到“枚举次数”
直接枚举 \(a_i\) 是 \((m+1)^n\) 级别,\(31^{100}\) 不可行。
关键观察:\(S\) 只依赖每个值 \(x\) 出现了多少次,不关心具体位置。设值 \(x\) 出现 \(c_x\) 次,则:
- 序列个数:\(\dfrac{n!}{\prod c_x!}\),等价于依次从剩余位置里选 \(\binom{n-y}{c_x}\)。
- 权值:\(\prod v_x^{c_x}\)。
所以只需枚举 \((c_0,c_1,\dots,c_m)\) 且 \(\sum c_x=n\)。
三、为什么按“值”逐位处理
\(S=\sum_x c_x\cdot2^x\),这是按二进制位加权的形式。从低位到高位处理 \(x=0,1,\dots,m\) 时,每一位的“数量”会向高位进位:
其中 \(b\) 是低位传上来的进位。这样可以把“\(S\) 的 popcount”边处理边统计。
四、状态设计
int f[N][M][M][M];
int dfs(int x,int y,int a,int b)
| 参数 | 含义 |
|---|---|
x |
当前处理到值 \(x\)(\(0\le x\le m\)) |
y |
已分配 \(y\) 个位置(\(\sum_{t<x}c_t=y\)) |
a |
已确定的二进制 \(1\) 的个数(低位已固定) |
b |
当前位的进位 |
终止条件:
if(y>=n) return (a+popcount(b))<=k;
if(x>m) return 0;
y>=n:所有位置分完,剩余进位b的每个二进制 \(1\) 最终都会成为 \(S\) 的 \(1\),所以总数是a+popcount(b)。x>m但y<n:值用完了位置没填满,非法。
记忆化:
if(f[x][y][a][b]!=-1) return f[x][y][a][b];
...
return f[x][y][a][b]=res;
五、转移逐项拆解
for(int i=0;i<=n-y;i++)
    res=(res+((dfs(x+1,y+i,a+((b+i)&1),(b+i)>>1)%mod
         *p[x][i])%mod*c[n-y][i]%mod)%mod)%mod;
枚举值 \(x\) 出现 \(i\) 次(\(0\le i\le n-y\))。四项含义:
5.1 y+i:位置推进
已分配位置从 \(y\) 增加到 \(y+i\)。
5.2 a+((b+i)&1):第 \(x\) 位的二进制位
第 \(x\) 位的总数是 b+i,其最低位 (b+i)&1 就是 \(S\) 在第 \(x\) 位的值(0 或 1),加到已确定的 \(1\) 的个数 a 上。
5.3 (b+i)>>1:向高位的进位
b+i 除以 2 的商,作为传给下一位 \(x+1\) 的进位。
5.4 \(p[x][i] = v_x^i\):权值贡献
预处理:
for(int i=0;i<=m;i++)
{
    p[i][0]=1;
    for(int j=1;j<=n;j++) p[i][j]=p[i][j-1]*v[i]%mod;
}
5.5 \(c[n-y][i] = \binom{n-y}{i}\):位置分配
从剩余 \(n-y\) 个位置中选 \(i\) 个放值 \(x\)。预处理组合数:
for(int i=0;i<=30;i++)
{
    c[i][0]=c[i][i]=c[0][i]=1;
    for(int j=1;j<i;j++) c[i][j]=(c[i-1][j]+c[i-1][j-1])%mod;
}
注:
c[0][i]=1是多余且错误的初始化(c[0][i>0]应为 0),但本代码只用c[n-y][i]且n-y>=i,不会访问c[0][i>0],所以无影响。严格写法是只写c[i][0]=c[i][i]=1。
Piratski kod
一、核心定义
整块:末尾恰好为 11、且此前没有任何连续 1 的字符串(即一个合法的海盗表示)。
散块:整个串中不含任何连续 1 的字符串(可以是空串)。
为什么这样定义?观察贪心解码的过程:每次切出一个尽可能短的海盗表示(即一个整块),切到不能切为止,剩下的部分一定不含 11,即一个散块。
因此,任意一个海盗代码 = 若干个整块拼接 + 一个散块(散块长度可以为 \(0\),此时串恰好由整块组成;如果没有整块,则整串就是一个散块,代码值为 \(0\))。
二、状态定义
- \(f[i][0/1]\):所有长度为 \(i\)、结尾为
0/1的散块的价值之和; - \(num[i][0/1]\):长度为 \(i\)、结尾为
0/1的散块的个数; - \(dp[i]\):所有长度为 \(i\)、由若干整块拼接而成(不含散块)的串的价值之和;
- \(cnt[i]\):长度同上,这样的串的个数。
三、状态转移
1. 散块转移
\(num\) 的转移(在末尾追加一位):
直观理解:末尾放 0,前面可以接任意合法散块;末尾放 1,则前面必须以 0 结尾,否则会出现 11。
\(f\) 的转移:
下标说明:海盗表示的公式中,第 \(k\) 位(从 0 开始)的贡献是 \(Fib[2+k]\)。散块长度为 \(i\)、末位为 1 时,这个 1 位于位置 \(i-1\),对应 \(Fib[2+(i-1)]=Fib[i+1]\)。共 \(num[i-1][0]\) 种前缀,每种都加上 \(Fib[i+1]\),故乘起来累加。
2. 整块转移
把长度为 \(i\) 的整块拆成:前面若干个整块 + 最后一个整块。最后一个整块可写成"长度为 \(j\) 且末位为 1 的散块 + 末尾的 1",因此它的:
- 长度为 \(j+1\);
- 价值之和为 \(f[j][1]\);
- 个数为 \(num[j][1]\)。
前面部分长度为 \(i-j-1\)。因此:
\(dp\) 的转移采用"卷积式"思路:总价值 = (前面部分的价值 × 最后一块的个数) + (最后一块的价值 × 前面部分的个数)。
边界:\(cnt[0]=1\)(空串视为"零个整块拼接"的唯一方式),其余为 \(0\);\(dp[0]=0\)。
四、最终答案
长度为 \(i\) 的海盗代码 = 一个由若干整块拼接的串(长度 \(j\)) + 一个散块(长度 \(i-j\))。
散块可以是长度为 \(i-j\) 的任意合法串(末位 0 或 1 均可),共 \(num[i-j][0]+num[i-j][1]\) 种,且不改变总价值。因此:
\(j\ge 2\) 是因为最短的整块为 11,长度为 2;\(j=0\) 或 \(1\) 时 \(dp[j]=0\),写不写等价。
「HAOI2018」苹果树
一、题意与模型转化
第 1 天,长出根节点。此后每天,从当前所有尚未长出节点的分支中随机选一个,在该分支上长出一个新节点。
每个节点有恰好两个分支(左、右),所以这是一个带左右区分的二叉树生成过程。
\(N\) 天后共有 \(N\) 个节点。定义不便度为树上任意两点间距离之和。求不便度的期望 \(E\),输出 \(E\times N!\bmod P\)。
关键观察:第 \(i\) 天(\(i\ge 2\))时,树上有 \(i-1\) 个节点,总分支数 \(2(i-1)\),其中已占用的分支数为 \(i-2\)(除根外每个节点占一个分支)。所以可用分支数为
第 1 天只有 1 种选择,所以生成方案总数为
因此
题目真正要求的是:所有生成方案的不便度之和。
二、不便度的边贡献拆解
树上任意两点距离之和可以按边拆解:一条边 \((u,\text{fa}(u))\) 被经过的次数 = 子树 \(u\) 内的点数 × 子树外的点数。
设第 \(i\) 个节点(\(i\ge 2\),保证有父节点)的子树大小为 \(j\),则它的边贡献为
于是问题变成:对每个 \(i\ge 2\) 和每个可能的子树大小 \(j\),计算子树 \(i\) 大小恰为 \(j\) 的方案数,乘上 \(j(N-j)\) 累加。
三、子树方案数拆解
固定 \(i\ge 2\) 和 \(j\)(\(1\le j\le N-i+1\))。把整棵树拆成三部分:
(1) 前 \(i\) 个节点
第 \(1\) 到第 \(i\) 天的生成过程,方案数为 \(i!\)(每天的选择数分别为 \(1,2,\dots,i\))。
(2) 以 \(i\) 为根的子树内部
子树共 \(j\) 个节点:根 \(i\),加上从 \(\{i+1,\dots,N\}\) 中选出的 \(j-1\) 个节点。
- 选出这 \(j-1\) 个节点:\(\binom{N-i}{j-1}\) 种;
- 子树内部的生成形态:把这 \(j\) 个节点看作独立过程,第 1 个是根 \(i\)(\(2\) 个可用分支),之后每加入一个点可用分支数递增 \(1\),所以方案数为
(3) 子树外部的其他节点
除前 \(i\) 个节点和子树内其他 \(j-1\) 个节点外,还有 \(N-i-(j-1)=N-i-j+1\) 个点,加上前 \(i\) 个节点中的节点已经计入 \(i!\)。
子树外部方案数为
为什么是 \((N-j-1)!/(i-2)!\)? 直观理解:外部点的生成过程相当于在"去掉子树后的树"上继续生长。可以证明外部剩余 \(N-j\) 个位置(含前 \(i\) 中的节点和后面非子树节点)的排列贡献恰好化简为上式。这个结论在两道同模型题目中已被验证(下面用样例验证)。
四、最终公式
约束:\(j\le N-i+1\),因为子树除根外还有 \(j-1\) 个点要从 \(i+1,\dots,N\)(共 \(N-i\) 个)中选。
五、代码逐段解释
int n,p;
cin>>n>>p;
if(p==1)
{
    cout<<0<<"\n";
    return 0;
}
特判 \(P=1\):任何数模 1 都是 0,直接输出,避免 \(1\bmod P=0\) 导致组合数、阶乘全为 0 时出现异常。
vector<int> jie(n+1,0);
jie[0]=1;
for(int i=1;i<=n;i++) jie[i]=jie[i-1]*i%p;
预处理阶乘 \(\text{jie}[k]=k!\bmod P\)。
vector<vector<int>> c(n+1,vector<int>(n+1,0));
c[0][0]=1;
for(int i=1;i<=n;i++)
{
    c[i][0]=c[i][i]=1;
    for(int j=1;j<i;j++) c[i][j]=(c[i-1][j-1]+c[i-1][j])%p;
}
组合数用杨辉三角递推,而不是阶乘逆元。原因:\(P\) 不保证是质数,无法求逆元。递推式
在任何模数下都成立。
int ans=0;
for(int i=2;i<=n;i++)
{
    for(int j=1;j<=n-i+1;j++)
    {
        int num=(j%p*((n-j)%p)%p)%p;
        num=num*c[n-i][j-1]%p;
        num=num*jie[j]%p;
        num=num*(i%p)%p;
        num=num*((i-1)%p)%p;
        num=num*jie[n-j-1]%p;
        ans=(ans+num%p)%p;
    }
}
cout<<ans%p<<"\n";
逐项对应公式:
| 代码 | 公式 |
|---|---|
j%p*((n-j)%p) |
\(j(N-j)\) |
*c[n-i][j-1] |
\(\times\binom{N-i}{j-1}\) |
*jie[j] |
\(\times j!\) |
*(i%p) |
\(\times i\) |
*((i-1)%p) |
\(\times(i-1)\) |
*jie[n-j-1] |
\(\times(N-j-1)!\) |
即
「JOISC 2018 Day 1」帐篷
一、观察结构
仔细分析条件后,可以发现每个合法布局中,任意一行、任意一列都只会出现下列三种基本结构之一:
结构 A(单帐篷):一个帐篷独占它所在的行和列。此时这一行、这一列都没有其他帐篷,因此它的入口朝四个方向都可以,共 \(4\) 种朝向。
结构 B(同行两帐篷):同一行放两个帐篷,它们彼此相对(左侧帐篷朝东、右侧帐篷朝西)。这两列被这两顶帐篷占满,不能再出现其他帐篷。
结构 C(同列两帐篷):同一列放两个帐篷,它们彼此相对(上方帐篷朝南、下方帐篷朝北)。这两行被这两顶帐篷占满,不能再出现其他帐篷。
为什么只有这三种? 考虑任意一行:如果这一行放了 \(\ge 3\) 顶帐篷,那么根据条件,最左的必朝东、最右的必朝西,而中间的帐篷无论朝哪边都会与条件冲突——因为它的东边和西边都已经有帐篷。所以一行至多两顶帐篷;且两顶时必然互相朝向。一列同理。两种对称结构即结构 B、C。
因此,一个合法布局等价于:把部分行列用结构 A、B、C 覆盖(可以是空布局)。
二、状态与转移
设 \(dp[i][j]\) 表示在 \(i\) 行 \(j\) 列的子矩形中搭帐篷的方案数(允许空布局)。
按最后一行 \(i\) 的情况分类:
- 第 \(i\) 行不放帐篷:
2.第 \(i\) 行放 1 顶帐篷,且这一列没有其他帐篷(结构 A):
这一列有 \(j\) 种选法,帐篷入口有 \(4\) 种朝向:
3.第 \(i\) 行放 1 顶帐篷,且这一列的前 \(i-1\) 行也放一顶帐篷(结构 C):
这一列有 \(j\) 种选法,与之配对的另一行有 \(i-1\) 种选法:
4.第 \(i\) 行放 2 顶帐篷(结构 B):
从 \(j\) 列中选 2 列,共 \(\binom{j}{2}\) 种;这 2 列被占满:
边界:\(dp[0][j]=dp[i][0]=1\)(空布局只有一种)。
答案:\(dp[H][W]-1\)(去掉全空布局)。
agc005D - ~K Perm Counting
设 \(f(m)\) 表示先指定 \(m\) 个位置,强制它们满足 \(|P_i-i|=k\),剩下 \(n-m\) 个位置随便排的方案数。
那么答案就是
详细解释:
\(n\)个数的情况,
只看1,3,4三个数
\(f(0)=n!\)
\(-f(1):\)
- 强制选择1,有\((n-1)!\)种情况
- 强制选择3,有\((n-1)!\)种情况
- 强制选择4,有\((n-1)!\)种情况
此时会发现13,14,34这三种情况。
- 在\(f(1)\)中,都算了\(2×(n-2)!\)种方案,
- 在\(f(0)\)中,都算了\((n-2)!\)种方案,
一共算了\(-(n-2)!\)种方案,应该是\(0\)种,所以要\(+f(2)\)
\(+f(2):\)
- 强制选择13,有\((n-2)!\)种情况
- 强制选择14,有\((n-2)!\)种情况
- 强制选择34,有\((n-2)!\)种情况
发现134这种情况,
- 在\(f(2)\)中,算了\(+3\times (n-3)!\)种方案,
- 在\(f(1)\)中,算了\(-3\times (n-3)!\)种方案,
- 在\(f(0)\)中,算了\(+(n-3)!\)种方案
一共算了\((n-3)!\)种方案,题目要求是不能出现任何不符合要求的情况,所以要\(-f(3)\)
\(-f(3):\)
\(...\)
原题可以看成一个二分图的形式:(\(n=5,k=1\) 时)
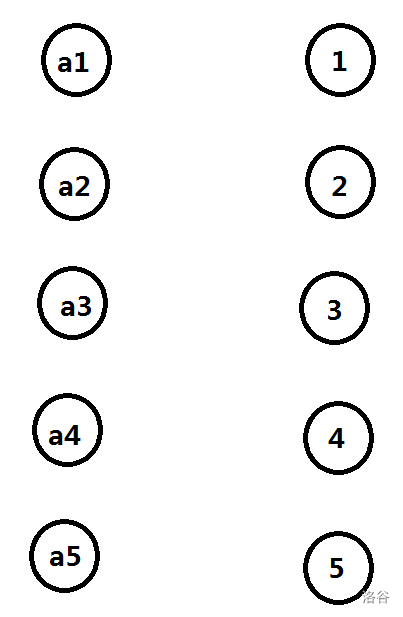
左边是排列的编号,右边是权值,那么现在要做的就是连 n 条边,补全这个二分图,使得每个点的度数都是 1。
如图,连出上图中的任意一条边都会使得\(|P_i-i|=k\)
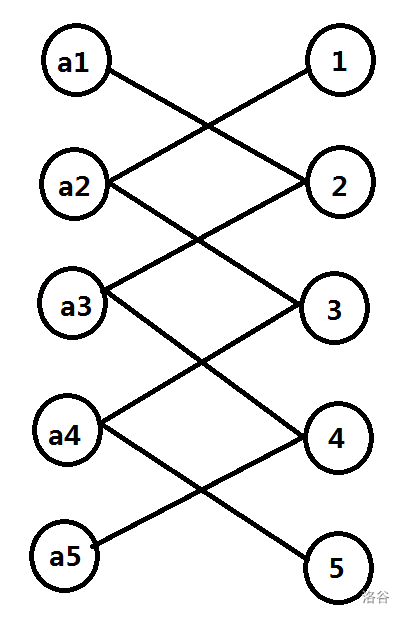
我们考虑选出一些边,而且任意两条边都不能接在同一个端点上(因为每个点的度数要为 \(1\))。
发现图中的边构成了若干条链且互不影响,于是把他们拿出来铺平:
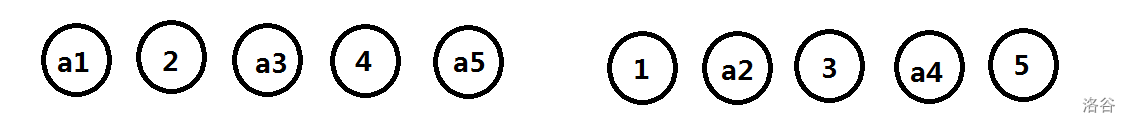
此时如果要使得\(|P_i-i|=k\),只有相邻两个点之间才会连边,如图
设 \(dp[i][j][0][0/1]\) 表示已经考虑了前 \(i\) 个点,其中连了 \(j\) 条边,第 \(i−1\) 个点和第 \(i\) 个点之间是/否连边的方案数。
那么容易得到:
但是还有一种特殊情况,那就是 \(i=6\) 时,第 \(5\) 个点和第 \(6\) 个点之间不能连边,所以此时 \(dp[i][j][1]\) 不存在。
所以我们需要开一个数组判断一下某一个点是否是链的开头。
按着这个 \(dp\),那么有
(\(tot=2\times n\))
意思就是先把满足有 \(m\) 个 \(|P_i−i|=k\) 的方案数算出来,剩下的数随便排列。
jie[0] ← 1
对于 i = 1 到 N:
    jie[i] ← jie[i-1] * i mod mod

tot ← 0
对于 i = 1 到 k:
    对于 t = 0 到 1:
        对于 j = i 到 n 步长 k:
            tot ← tot + 1
            如果 i ≠ j:
                vis[tot] ← 真

dp[0][0][0] ← 1

对于 i = 1 到 tot:
    对于 j = 0 到 n:
        dp[i][j][0] ← (dp[i-1][j][0] + dp[i-1][j][1]) % mod
        如果 vis[i] 为真 且 j > 0:
            dp[i][j][1] ← dp[i-1][j-1][0]

ans ← 0
对于 i = 0 到 n:
    方案数 ← (dp[tot][i][0] + dp[tot][i][1]) % mod
    项     ← 方案数 * jie[n-i] % mod
    如果 i 为奇数:
        ans ← (ans - 项 + mod) % mod
    否则:
        ans ← (ans + 项) % mod

输出 ans
「HEOI2014」平衡
[USACO 2020 December, Platinum] Problem 1. Sleeping Cows
一、题意
有 \(N\) 头奶牛(大小 \(s_i\))和 \(N\) 个牛棚(大小 \(t_j\))。奶牛 \(i\) 能睡进牛棚 \(j\) 当且仅当 \(s_i\le t_j\)。每个牛棚至多睡一头奶牛,每头奶牛至多睡一个牛棚。
一个匹配(奶牛→牛棚的分配)是极大的,当且仅当:
- 每头已分配的奶牛都能进入其牛棚;
- 每头未分配的奶牛,都无法进入任何未分配的空牛棚。
求极大匹配的数量,模 \(10^9+7\)。\(N\le 3000\)。
二、核心观察:极大性的等价刻画
2.1 混合排序
把 \(2N\) 个对象(\(N\) 头奶牛 + \(N\) 个牛棚)放一起按大小升序排序。大小相同时,奶牛排在牛棚前面。
为什么这样排?因为如果奶牛和牛棚同大小,奶牛是能进这个牛棚的,所以奶牛应该先"等待",让后来的同大小牛棚有机会匹配它。如果牛棚排在前面,就会出现"牛棚空着、同大小奶牛在后面进不来"的合法情况,这与极大性一致,但排序规则需要让 DP 能正确处理——奶牛在前可以统一处理两种情况。
排序后序列形如:
从左向右扫描,维护一个"等待匹配的奶牛集合"(已出现、尚未匹配、将来必须匹配的奶牛)。
2.2 两条关键性质
1.性质 A(放弃奶牛后,牛棚必须全满):
若某头奶牛最终不匹配(被放弃),则它之后出现的所有牛棚都必须被匹配。
证明:被放弃的奶牛大小 \(\le\) 之后任何牛棚(排序保证),所以它能进入之后任何空牛棚。若之后有牛棚空着,该奶牛就能进入它,与极大性矛盾。
2.性质 B(空牛棚之后不会再有能进它的奶牛):
若某牛棚空着,则它之后出现的所有奶牛大小都严格大于它(因为同大小时奶牛在前),所以之后任何奶牛都进不了这个空牛棚。
性质 B 说明:空牛棚是"安全"的,只要它前面没有未被匹配的、能进它的奶牛即可。这正是性质 A 的逆否。
2.3 统一成一个标记
用一个标记 \(k\) 表示:
- \(k=1\):尚未放弃任何奶牛——之后还可以空牛棚,也可以放弃奶牛;
- \(k=0\):已经放弃过至少一头奶牛——之后所有牛棚都必须匹配,不允许空牛棚。
这就是 DP 的第三维。
三、DP 状态设计
- \(i\):已处理排序序列的前 \(i\) 个元素;
- \(j\):当前等待匹配的奶牛数(这些奶牛必须被未来牛棚匹配);
- \(k\in\{0,1\}\):是否已经放弃过奶牛(含义见上)。
初值
即:处理 \(0\) 个元素、等待 \(0\) 头奶牛、还没放弃任何奶牛——唯一初始状态。
四、转移推导
按第 \(i\) 个元素的类型分类。
4.1 第 \(i\) 个是奶牛
这头奶牛有两种命运:
1.(A) 让它等待匹配
等待数从 \(j-1\) 变为 \(j\),\(k\) 保持不变:
2.(B) 放弃它(最终不匹配)
等待数保持 \(j\),\(k\) 必须变成 \(0\)(如果原来就是 \(0\),保持 \(0\)):
注意:这两种命运是互斥的,各自累加到对应状态即可,不需要"相加后再判断"。代码中先处理 (A) 的累加,再处理 (B) 的累加,两个分支独立。
4.2 第 \(i\) 个是牛棚
这个牛棚也有两种命运:
1.(A) 空着
只有 \(k=1\) 时允许(否则违反性质 A)。等待数保持 \(j\):
2.(B) 匹配一头等待的奶牛
上一状态有 \(j+1\) 头等待奶牛,从中任选一头(\(j+1\) 种选择),匹配后等待数变为 \(j\),\(k\) 保持不变:
注意:这里 \(k\) 的两个分支都会汇入,因为匹配操作对 \(k\) 没有限制(无论是否放弃过奶牛,牛棚都可以匹配)。
五、最终答案
处理完 \(2N\) 个元素后,等待奶牛数必须为 \(0\)(所有"将来必须匹配"的奶牛都已经匹配完),\(k\) 两种都合法:
六、为什么这个 DP 恰好刻画极大匹配?
需要验证:DP 计数的每个方案都是极大匹配,反之每个极大匹配都被计数一次。
DP → 极大匹配:
- 每头奶牛要么等待后匹配、要么被放弃,覆盖了所有奶牛命运;
- 每个牛棚要么匹配、要么空着,覆盖了所有牛棚命运;
- 每个匹配都满足 \(s_i\le t_j\)(因为扫描顺序下,奶牛在等待队列中时,任何能匹配它的牛棚都 \(\ge\) 它);
- 若某奶牛被放弃,\(k\) 变 \(0\),之后牛棚全部匹配,性质 A 满足;
- 若某牛棚空着,它出现时 \(k=1\),之前没有放弃过奶牛,所以之前出现的等待奶牛都已经匹配完了,之后出现的奶牛都严格大于该牛棚(同大小奶牛在前),性质 B 满足。
因此 DP 方案 ↔ 极大匹配。
极大匹配 → DP:
任意极大匹配,按扫描顺序:
- 奶牛被匹配的,就"等待 + 后来匹配";
- 奶牛不被匹配的,就"放弃",并标记 \(k=0\);
- 牛棚被匹配的,就"匹配一头等待奶牛";
- 牛棚空着的,因为极大性,它前面一定没有未匹配的能进它的奶牛(否则不极大),所以它出现时等待队列为空,且此时一定还没放弃过奶牛(否则性质 A 被违反),所以 \(k=1\),转移合法。
因此每个极大匹配都被 DP 唯一计数一次。双射成立。
七、代码逐段解释
dp[0][0][1]=1;
for(int i=1;i<=(n<<1);i++)
{
    bool flag=s[i].second;
    for(int j=0;j<=n;j++)
    {
        if(!flag)   // 当前是奶牛
        {
            if(j)   // (A) 让它等待匹配
            {
                dp[i][j][1]=(dp[i][j][1]+dp[i-1][j-1][1])%mod;
                dp[i][j][0]=(dp[i][j][0]+dp[i-1][j-1][0])%mod;
            }
            // (B) 放弃它
            dp[i][j][0]=(dp[i][j][0]+(dp[i-1][j][0]+dp[i-1][j][1])%mod)%mod;
        }
        else        // 当前是牛棚
        {
            // (B) 匹配一头等待奶牛
            dp[i][j][0]=dp[i-1][j+1][0]*(j+1)%mod;
            // (A) 空着(只有 k=1)+ (B) 匹配(k=1 分支)
            dp[i][j][1]=(dp[i-1][j][1]+dp[i-1][j+1][1]*(j+1)%mod)%mod;
        }
    }
}
cout<<(1ll*dp[n<<1][0][0]+dp[n<<1][0][1])%mod<<"\n";
逐行要点:
if(!flag)处理奶牛;else处理牛棚。- 奶牛分支中,
if(j)保证j-1>=0;(B)的dp[i-1][j][0]+dp[i-1][j][1]都汇入dp[i][j][0],因为现在处于"已放弃"状态。 - 牛棚分支中,
dp[i][j][0]只能来自"匹配"(因为 \(k=0\) 时不能空着);dp[i][j][1]来自"空着"和"匹配"两项之和。 - 最终答案取 \(j=0\),\(k=0\) 和 \(k=1\) 两个状态相加。
[ZJOI2010] 排列计数
P2606 [ZJOI2010] 排列计数 详解
一、题意与模型
给定 \(n\),统计 \(1\sim n\) 的排列 \(p\) 中,满足
的排列个数,模质数 \(m\)。
把下标关系 \(i\to\lfloor i/2\rfloor\) 看作一棵完全二叉树(根为 \(1\),左儿子 \(2i\),右儿子 \(2i+1\))。条件即为:每个节点的值都大于其父节点,也就是一棵小根堆。
由于排列中的数是 \(1\sim n\),堆根必须是最小值 \(1\)。于是问题转化为:在完全二叉树上分配 \(1\sim n\),满足小根堆性质的方案数。
二、递推关系
设 \(siz[x]\) 为以 \(x\) 为根的子树大小,\(f[x]\) 为在 \(siz[x]\) 个互不相同的数中,根取最小、且满足小根堆性质的方案数。
根 \(x\) 固定为这 \(siz[x]\) 个数中的最小值。剩下的 \(siz[x]-1\) 个数要分给左子树和右子树:
- 左子树分到 \(siz[2x]\) 个数,右子树分到 \(siz[2x+1]\) 个数;
- 从 \(siz[x]-1\) 个数中选出 \(siz[2x]\) 个给左子树的方案数为 \(\binom{siz[x]-1}{siz[2x]}\);
- 左右子树内部各自满足堆性质,方案数分别为 \(f[2x]\) 和 \(f[2x+1]\)。
因此
叶子节点 \(f[x]=1\)。最终答案 \(f[1]\)。
关键:\(f[x]\) 只依赖于子树大小,与具体数值无关,因为相对大小关系在左右子树分配后是等价的。
三、组合数计算:Lucas 定理
\(n\le 10^6\),但模数 \(m\) 可能很小(如 \(m=2,3,\dots\)),因此 \(n\) 可能大于 \(m\),不能直接用阶乘逆元,必须使用 Lucas 定理:
由于 \(m\) 是质数,预处理阶乘到 \(\min(n,m-1)\) 即可。对于递归中的 \(\binom{n\bmod m}{k\bmod m}\),两个参数都小于 \(m\),可以用阶乘 + 费马小定理求逆元。
代码中的 MAX = min(1000000ll, mod-1ll):
- 当 \(m>n\) 时,\(n\le 10^6\),需要阶乘到 \(n\),而 \(m-1\ge n\),所以
MAX = n(不超过 \(10^6\)); - 当 \(m\le n\) 时,Lucas 递归中只用到小于 \(m\) 的参数,所以阶乘到 \(m-1\) 足够。
因此 MAX 的选择是正确的。
四、代码逐段解释
int n,mod,dp[N],siz[N],MAX;
namespace zhuhe
{
    #define i128 __int128_t
    int jie[N+5],ni[N+5];
    inline int quick(int x,int a)   // 快速幂求逆元(mod 为质数)
    {
        int ans=1;
          x%=mod;
        while(a)
        {
            if(a&1) ans=(ans*x)%mod;
            (x*=x)%=mod;
            a>>=1;
        }
        return ans;
    }
    inline int C(int n,int m)       // Lucas 定理
    {
        if(n<m||n<0||m<0) return 0;
        else if(n<=mod&&m<=mod) return (jie[n]*ni[m]%mod)*ni[n-m]%mod;
        else return C(n%mod,m%mod)*C(n/mod,m/mod)%mod;
    }
    inline void JN()                // 预处理阶乘与逆元
    {
        jie[0]=1;
        for(int i=1;i<=MAX;i++) jie[i]=jie[i-1]*i%mod;
        ni[MAX]=quick(jie[MAX],mod-2);
        for(int i=MAX-1;i>=0;i--) ni[i]=ni[i+1]*(i+1)%mod;
    }
}
说明:
quick用费马小定理求 \(a^{-1}\equiv a^{m-2}\pmod m\);C先判非法,若 \(n,k<m\) 则直接用阶乘逆元;否则用 Lucas 递归;JN预处理阶乘 \(jie\) 和逆元阶乘 \(ni\),下标到MAX。
inline void dfs(int x)
{
    siz[x]=1;
    for(int y=2*x;y<=2*x+1&&y<=n;y++)  // 遍历左右儿子
    {
        dfs(y);
        siz[x]+=siz[y];
    }
    f(x*2+1>n) dp[x]=1;               // 没有右儿子(此时最多一个叶子左儿子)
    else dp[x]=C(siz[x]-1,siz[2*x])*dp[2*x]%mod*dp[2*x+1]%mod;
}
为什么 if(x*2+1>n) dp[x]=1 是正确的?
若 \(x\) 没有右儿子(\(2x+1>n\)),则 \(x\) 最多只有一个左儿子 \(2x\),且因为 \(2x+1>n\) 意味着 \(2x\ge n\),所以只能是 \(2x=n\)(若存在左儿子)。此时左儿子是叶子,\(siz[2x]=1\),组合数 \(\binom{siz[x]-1}{1}=1\),\(dp[2x]=1\),所以 \(dp[x]=1\)。若连左儿子都没有,则 \(x\) 是叶子,\(dp[x]=1\)。因此该判断安全。
signed main()
{
    cin>>n>>mod;
    MAX=min(1000000ll,mod-1ll);
    JN();
    dfs(1);
    cout<<dp[1]<<'\n';
}
- 读入 \(n,m\);
- 计算
MAX; - 预处理组合数;
- 从根 \(1\) 开始 DFS 计算 \(siz\) 与 \(dp\);
- 输出 \(dp[1]\)。
「PA 2020」Malowanie płotu
一、题目与模型
围栏有 \(n\) 根木条,每根木条分为 \(m\) 段。每根木条的涂色段必须连续(即形如区间 \([l,r]\),\(1\le l\le r\le m\)),且相邻两根木条的涂色区间必须有非空交集。
求满足条件的涂色方案数,模质数 \(p\)。
关键约束:\(n\times m\le 10^7\),所以算法的复杂度必须控制在 \(O(nm)\) 或 \(O(nm\log m)\) 级别。任何 \(O(nm^2)\) 的算法都会超时。
二、朴素状态与优化动机
每根木条的状态是一个区间 \([l,r]\)。直接定义 \(dp[l][r]\) 表示当前木条涂 \([l,r]\) 的方案数,状态数是 \(O(m^2)\),层数 \(n\),总复杂度 \(O(nm^2)\),不可行。
优化思路:把二维区间状态拆成两个一维状态。
- \(F[j]\):当前木条涂色区间右端点固定为 \(j\)(即形如 \([l,j]\))的方案数之和;
- \(g[j]\):当前木条涂色区间左端点固定为 \(j\)(即形如 \([j,r]\))的方案数之和。
由于每个区间 \([l,r]\) 同时“右端点 \(r\)”和“左端点 \(l\)”,它在 \(F\) 和 \(g\) 中都会被统计一次,所以 \(\sum_j F[j]=\sum_j g[j]=\) 当前层所有合法方案数。
三、转移推导:容斥
考虑新一层的右端点固定为 \(j\),区间为 \([l,j]\)(\(1\le l\le j\))。它与上一层的某个区间有交集,等价于全集减去不相交。
设上一层的状态为 \(F',g'\),全集为
不相交的情况只有两种:
(A) 上一层整体在 \([l,j]\) 左侧:上一层右端点 \(R<l\)。
贡献为 \(\sum_{R=1}^{l-1}F'[R]\)。
(B) 上一层整体在 \([l,j]\) 右侧:上一层左端点 \(L>j\)。
贡献为 \(\sum_{L=j+1}^{m}g'[L]\)。
于是对 \([l,j]\) 这一区间的合法方案数为
再对所有 \(l\in[1,j]\) 求和,得到
对称地,对左端点固定为 \(j\)、区间 \([j,r]\)(\(j\le r\le m\)):
四、前缀和与二阶前缀和优化
如果直接按上面公式求和,每次转移是 \(O(m^2)\)。要降到 \(O(m)\),需要预处理四组和:
设
化简 \(F[j]\):
\((S-\sum_{L=j+1}^{m}g'[L])\) 对每个 \(l\) 都相同,共加 \(j\) 次:
再减去 \(\sum_{l=1}^{j}\sum_{R=1}^{l-1}F'[R]=\sum_{l=1}^{j}sl[l-1]=\sum_{k=0}^{j-1}sl[k]=ssl[j-1]\)。
所以
化简 \(g[j]\):
\((S-\sum_{R=1}^{j-1}F'[R])\) 对每个 \(r\) 相同,共加 \(m-j+1\) 次:
再减去 \(\sum_{r=j}^{m}\sum_{L=r+1}^{m}g'[L]=\sum_{r=j}^{m}sr[r+1]=\sum_{k=j+1}^{m+1}sr[k]=ssr[j+1]\)。
所以
两个转移都是 \(O(1)\),整层转移 \(O(m)\)。
五、代码解释
int F[N],g[N],sl[N],sr[N],ssl[N],ssr[N];
F, g:当前层的两个一维状态;sl, sr:一阶前缀/后缀和;ssl, ssr:二阶前缀/后缀和。
int n,m,mod,ans=0;
cin>>n>>m>>mod;
for(int i=1;i<=m;i++)
{
    F[i]=i;
    g[i]=m-i+1;
}
初始化第一行:没有上一层约束。
- 右端点固定为 \(i\):左端点有 \(i\) 种(\([1,i],[2,i],\dots,[i,i]\)),所以 \(F[i]=i\);
- 左端点固定为 \(i\):右端点有 \(m-i+1\) 种,所以 \(g[i]=m-i+1\)。
for(int i=2;i<=n;i++)
{
    for(int j=1;j<=m;j++) sl[j]=(sl[j-1]+F[j])%mod;
    for(int j=m;j>=1;j--) sr[j]=(sr[j+1]+g[j])%mod;
    for(int j=1;j<=m;j++) ssl[j]=(ssl[j-1]+sl[j])%mod;
    for(int j=m;j>=1;j--) ssr[j]=(ssr[j+1]+sr[j])%mod;
预处理四组和(基于上一层的 \(F,g\)):
sl:\(F\) 的前缀和;sr:\(g\) 的后缀和;ssl:sl的前缀和(二阶前缀和);ssr:sr的后缀和(二阶后缀和)。
    for(int j=1;j<=m;j++)
    {
        F[j]=(j*(sl[m]-sr[j+1])-ssl[j-1])%mod;
        g[j]=((m-j+1)*(sl[m]-sl[j-1])%mod-ssr[j+1])%mod;
    }
}
核心转移,完全对应第四节的公式:
sl[m]就是全集 \(S\);F[j] = j*(S-sr[j+1]) - ssl[j-1];g[j] = (m-j+1)*(S-sl[j-1]) - ssr[j+1]。
注意 sr[m+1]、ssr[m+1] 默认为 0,sl[0]、ssl[0] 默认为 0,边界自然处理正确。
for(int i=1;i<=m;i++) ans=(ans+g[i])%mod;
ans=(ans+mod)%mod;
cout<<ans%mod;
统计答案:\(\sum_i g[i]\) 就是第 \(n\) 层所有合法方案数。由于中间有减法,结果可能为负,最后 (ans+mod)%mod 修正。
「PA 2024」Bardzo Ulubiony Ciąg
一、题目
给定长度 \(n\le 500\) 的数组 \(a\)。把所有子区间和按"左端点递增、右端点递增"排成一个长度 \(\frac{n(n+1)}2\) 的数组 \(b\)。求 \(b\) 中满足 \(b_i+b_j+b_k=0\) 且 \(i<j<k\) 的三元组个数。
直接暴力:\(b\) 长度可达 \(1.25\times 10^5\),三元素枚举是 \(O(|b|^3)\),不可行。
关键观察:\(b\) 中每个元素都是某个子区间和,即 \(S(l,r)=\text{sum}[r]-\text{sum}[l-1]\)。所以问题等价于:求三元组(三个子区间,位置互不相同)使三个子区间和之和为 \(0\)。
二、代码的整体策略
代码用的是一个"枚举第三个元素是单元素"的技巧 + 全局容斥修正。
2.1 核心恒等变换
对任意 \(i\),单元素区间 \((i,i)\) 的和是 \(a_i=\text{sum}[i]-\text{sum}[i-1]\)。
若三元组中有一个元素是单元素 \(a_i\),则另两个子区间和 \(S,T\) 满足
代码就是统计这种形式的 \((S,T,a_i)\) 数量,然后通过修正把它转化为"三个位置不同、无序"的三元组。
2.2 用差分数组快速匹配
维护一个全局数组 \(f[v]\)(下标带偏移 \(qq\))。对每个 \(i\):
加入阶段:把 \(\text{sum}[i-1]-T\) 对所有子区间和 \(T\) 计数加一:
查询阶段:对所有子区间和 \(S\),累加 \(f[\text{sum}[i]+S]\):
当 \(\text{sum}[i-1]-T=\text{sum}[i]+S\) 时产生贡献,即
这正是我们需要的"\(S+T=-a_i\)"。
三、代码逐段解释
3.1 预处理子区间和频次
for(int i=1;i<=n;i++)
{
    cin>>a[i];
    sum[i]=sum[i-1]+a[i];
    for(int x=0;x<i;x++) g[sum[i]-sum[x]]++;
}
\(g[v]\) 记录值为 \(v\) 的子区间和出现次数(用 map 存,因为值域很宽)。
3.2 主体双重循环
qq=3e7;
for(int i=1;i<=n;i++)
{
    int x=i-1;
    for(int k=1;k<=n;k++) for(int z=0;z<k;z++) f[sum[x]-sum[k]+sum[z]+qq]++;
    for(int j=1;j<=n;j++) for(int y=0;y<j;y++) ans+=f[sum[i]+sum[j]-sum[y]+qq];
}
外层 \(i\) 从 1 到 \(n\),每层两件事:
- 加入:对所有子区间和 \(T=\text{sum}[k]-\text{sum}[z]\),把 \(\text{sum}[i-1]-T\) 加入 \(f\);
- 查询:对所有子区间和 \(S=\text{sum}[j]-\text{sum}[y]\),把 \(f[\text{sum}[i]+S]\) 加到
ans。
两层内循环都是 \(O(n^2)\),共 \(n\) 层,总复杂度 \(O(n^3)\)。\(n\le500\) 时约 \(1.25\times 10^8\) 次操作,可过。
qq=3e7 是偏移量,因为 \(\text{sum}[i-1]-T\) 的范围约 \([-3\times 10^7,3\times 10^7]\),加偏移后非负。
3.3 容斥修正
for(int i=1;i<=n;i++)
{
    for(int x=0;x<i;x++)
    {
        int now=sum[i]-sum[x];
        ans-=3*g[-2*now];
        if(!now) ans+=2;
    }
}
cout<<ans/6;
加入阶段允许 \(S=T\)(同一子区间出现两次)、\(S\) 或 \(T\) 与 \(U=a_i\) 位置相同等情况,这些是非法的(\(b\) 中位置必须互不相同)。同时 \(S,T\) 在代码中有序,而题目要求无序。
修正公式:
- 减去 \(3g[-2\cdot \text{now}]\):对每个子区间和 \(now\),处理"\(S=T=now\) 且第三元素 \(-2\cdot now\)"这一类重复计数。由于 \(S,T,U\) 三种角色选择,重复了 3 次。
- 加上 2(\(now=0\) 时):\(S=T=U=0\) 的特殊边界情况,需要补回。
- 最后除以 6:经过修正后,每个合法位置三元组恰好被计算 6 次(对应 \(S,T,U\) 三个角色的对称性 × 固定 \(U\) 后 \(S,T\) 的排列)。
四、为什么最终恰好除以 6?
一个合法三元组 \(\{x,y,z\}\)(\(x+y+z=0\),\(x,y,z\) 是 \(b\) 中不同位置)的贡献:
- 若三个都是单元素:\(U\) 有 3 种选择,\(S,T\) 有序对 2 种,共 6 次;
- 若恰有两个单元素:修正前 4 次(2 种 \(U\) × 2 种有序),修正后补到 6 次;
- 若恰有一个单元素:修正前 2 次,修正后补到 6 次;
- 若三个都是长区间:代码通过 \(g[-2\cdot now]\) 的全局统计(\(g\) 包含所有子区间,不限于单元素)间接覆盖,修正后也达到 6 次。
因此最后除以 6 得到正确结果。
本文来自博客园,作者:Aries2011,转载请注明原文链接:https://www.cnblogs.com/Aries2011/p/23445225

 浙公网安备 33010602011771号