
 隐式建图相关题目
CF1292D Chaotic V.
题目描述
设 \(x\) 是大于 \(1\) 的正整数,定义 \(f(x)\) 为 \(x\) 的最小质因子的值。
现在考虑构造一棵树 \(T\)。其中节点均用从 \(1\) 开始的正整数编号,对于任意大于 \(1\) 的正整数 \(x\),节点 \(x\) 在树上的父亲是 \(\frac{x}{f(x)}\)。
在这棵树上有 \(n\) 个关键节点,很特别地,这 \(n\) 个节点的编号均可以表示成一个非负整数的阶乘。更具体地,第 \(i\) 个节点 \(P_i\) 的编号为 \(k_i!=\prod_{j=1}^{k_i}j\)。
定义 \(\text{DIS}(i,j)\) 表示树上 \(i,j\) 两点间最短路所包含的边数。现在你找出树上的一个节点 \(P\),最小化 \(\sum_{i=1}^n\text{DIS}(P,P_i)\) 的值。你只需要输出这个最小值即可。
输入格式
第一行一个正整数 \(n(1\leq n\leq 10^6)\),代表节点数。
第二行 \(n\)个非负整数 \(k_i(0\leq k_i\leq 5\times 10^3)\),描述节点 \(P_i\) 的编号为 \(k_i!\)。
输出格式
一行一个非负整数表示答案。
输入输出样例 #1
输入 #1
3
2 1 4
输出 #1
5
输入输出样例 #2
输入 #2
4
3 1 4 4
输出 #2
6
输入输出样例 #3
输入 #3
4
3 1 4 1
输出 #3
6
输入输出样例 #4
输入 #4
5
3 1 4 1 5
输出 #4
11
说明/提示
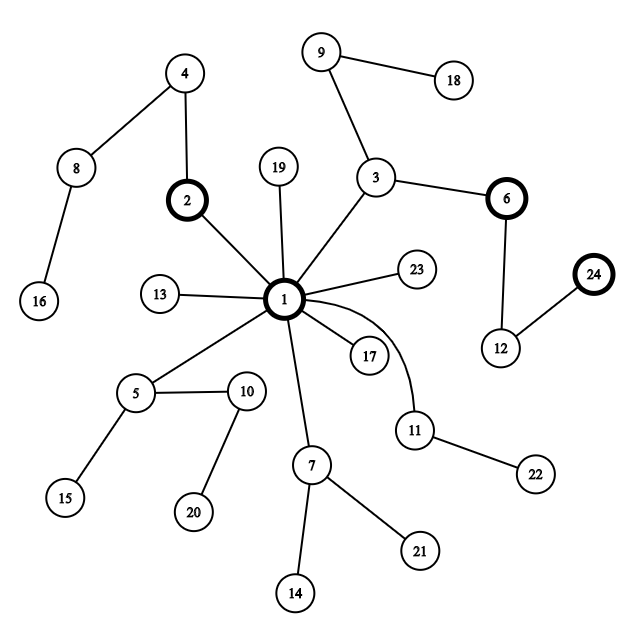
思路核心:这是一道“树上带权中位数”题。
1. 树的性质
节点 \(x\) 的父亲是 \(x/f(x)\),其中 \(f(x)\) 是 \(x\) 的最小质因子。
所以从 \(x\) 走到根 \(1\),就是不断删掉一个质因子。
因此:
- \(x\) 到根的距离 = \(x\) 的质因子个数,带重数。
- \(k!\) 到根的路径上,质因子是按“从大到小”加入的。
例如 \(4!=24=2^3\cdot 3\),从根到 \(24\) 是:
加入质因子的顺序是 \(3,2,2,2\)。
2. 最优点的判定
树上最小化到所有关键点的距离和,等价于找带权中位数。
从根 \(1\) 开始考虑:如果某个孩子子树中包含超过 \(n/2\) 个关键点,那么往这个孩子走,总距离会变小。
设这个子树有 \(w\) 个关键点,总共有 \(n\) 个关键点。
向该子树走一步:
- 这 \(w\) 个点距离减 \(1\);
- 其他 \(n-w\) 个点距离加 \(1\)。
距离和变化:
即距离和减少:
所以只要 \(2w>n\),就继续往这个子树走。
3. 代码实现思路
代码中:
c[i]:表示有多少个关键点是 \(i!\)。f[i][j]:表示 \(i!\) 中质数 \(j\) 的指数。p[i]:当前 \(i!\) 这个关键点下一步会走到的质因子分支。now:当前所有关键点到当前节点的距离和。ans:记录最小答案。
初始时当前节点是根 \(1\)。
所有关键点到根的距离和就是:
其中 \(\Omega(i!)\) 是 \(i!\) 的质因子总个数,也就是 \(\sum f[i][j]\)。
然后不断循环:
- 统计每个分支
p[i]有多少关键点:s[p[i]] += c[i]。 - 找到最大的分支
o,数量为w。 - 如果
w*2 <= n,说明没有超过一半的分支,当前点最优,停止。 - 否则走向分支
o,更新距离和:\[now -= 2w-n \] - 更新每个关键点的
p[i]:- 不走向
o的点,以后不再跟踪,p[i]=1; - 走向
o的点,消耗掉一个质因子o,如果该质因子指数用完,就降到下一个更小的质因子。
- 不走向
4. 复杂度
\(N=5000\),预处理 \(i!\) 的质因子指数,复杂度约为 \(O(N^2)\),实际可过。
读入 \(n\) 个 \(k_i\) 用桶计数,所以 \(n\le 10^6\) 也没问题。
点击查看代码
#include <bits/stdc++.h>
#define int long long
#define COUT cout<<"\n--------------------------------------------------------------\n"
#define fi first
#define se second
#define be begin()
#define en end()
using namespace std;
const int N=5e3+5;
const int mod=998244353;
const int inf=1e18;
int n,c[N],f[N][N],p[N],s[N],ans,now;
signed main()
{
	ios::sync_with_stdio(false);
    cin.tie(0);
	cout.tie(0);
	cin>>n;
	for(int i=1,x;i<=n;i++) cin>>x,++c[x];
	for(int i=2;i<N;i++)
	{
		memcpy(f[i],f[i-1],sizeof(f[i]));
		for(int j=2,k=i;j<=k;j++)
		{
			while(k%j==0)
			{
				++f[i][j];
				k/=j;
			}
		}

	}
	for(int i=1;i<N;i++)
	{
		if(!c[i]) p[i]=1;
		else
		{
			for(int j=1;j<=i;j++)
			{
				if(f[i][j])
				{
					p[i]=j;
					now+=f[i][j]*c[i];
				}
			}
		}
	}
	ans=now;
	while(*max_element(p+1,p+N)>1)
	{
		memset(s,0,sizeof(s));
		for(int i=0;i<N;i++) s[p[i]]+=c[i];
		int o=max_element(s+1,s+N)-s,w=s[o];
		if(w*2<=n||o==1) break;
		ans=min(ans,now-=w*2-n);
		for(int i=0;i<N;i++)
		{
			if(p[i]!=o) p[i]=1;
			if(p[i]==1) continue;
			--f[i][p[i]];
			while(p[i]>1&&!f[i][p[i]]) --p[i];
		}
	}
	cout<<ans;
	return 0;
}

//cout<<fixed<<setprecision(1);
CF463D Gargari and Permutations
题目描述
有 \(k\) 个 \(1 \sim n\) 的排列,求这些排列的最长公共子序列的长度。
输入格式
第一行两个正整数 \(n,k\)。
接下来 \(k\) 行,每行 \(n\) 个正整数,表示一个 \(1 \sim n\) 的排列。
输出格式
一行一个正整数表示最长公共子序列的长度。
输入输出样例 #1
输入 #1
4 3
1 4 2 3
4 1 2 3
1 2 4 3
输出 #1
3
说明/提示
数据范围
保证 \(1 \le n \le 10^3,2 \le k \le 5\)。
这段代码求的是 \(k\) 个 \(1\sim n\) 排列的最长公共子序列长度。
核心思路
公共子序列在每个排列中出现的相对顺序必须一致。
因此可以固定第一个排列作为参考顺序,然后做类似 LIS 的动态规划。
状态定义
设 \(dp[x]\) 表示以数值 \(x\) 结尾的最长公共子序列长度。
转移
对于第一个排列中的两个位置 \(i>j\),令:
- \(x = a[1][i]\)
- \(y = a[1][j]\)
因为 \(j<i\),所以在第一个排列中 \(y\) 在 \(x\) 前面。
如果对于所有其他排列 \(t=2\sim m\),也都有 \(y\) 在 \(x\) 前面,即:
那么 \(y\) 就可以接在 \(x\) 前面,形成更长的公共子序列:
实现细节
pos[t][v]记录数值 \(v\) 在第 \(t\) 个排列中的位置。- 外层循环 \(i\) 遍历第一个排列的位置,内层循环 \(j<i\) 遍历它前面的元素。
- 检查所有其他排列是否满足相对顺序一致。
- 初始所有 \(dp[x]=1\),因为单个元素本身就是长度为 \(1\) 的公共子序列。
- 最后取所有 \(dp[x]\) 的最大值。
复杂度
时间复杂度 \(O(n^2 k)\),空间复杂度 \(O(nk)\)。
\(n\le 1000\),\(k\le 5\),完全足够。
点击查看代码
#include <bits/stdc++.h>
#define int long long
using namespace std;
const int N=1010;
int n,m,ans,a[20][N],pos[20][N],dp[N];
signed main()
{
	ios::sync_with_stdio(false);
    cin.tie(0);
	cout.tie(0);
    cin>>n>>m;
    for(int i=1;i<=m;i++)
    {
    	for(int j=1;j<=n;j++)
        {
            cin>>a[i][j];
            pos[i][a[i][j]]=j;
        }
	}
    for(int i=1;i<=n;i++) dp[i]=1;
    for(int i=1;i<=n;i++)
    {
    	for(int j=1;j<i;j++)
        {
            int x=a[1][i];
            int y=a[1][j];
            int flag=1;
            for(int t=2;t<=m && flag;t++) if(pos[t][x]<pos[t][y]) flag=0;
            if(flag) dp[x]=max(dp[x],dp[y]+1);
        }
	}
    ans=0;
    for(int i=1;i<=n;i++) ans=max(ans,dp[i]);
    cout<<ans;
    return 0;
}
AT_abc377_e [ABC377E] Permute K times 2
题目描述
给定一个 $ (1,2,\ldots,N) $ 的排列 $ P=(P_1,P_2,\ldots,P_N) $。
你需要进行 $ K $ 次如下操作:
- 对于 $ i=1,2,\ldots,N $,同时将 $ P_i $ 更新为 $ P_{P_i} $。
请输出所有操作结束后的 $ P $。
输入格式
输入以如下格式从标准输入读入:
$ N $ $ K $ $ P_1 $ $ P_2 $ $ \ldots $ $ P_N $
输出格式
请输出所有操作结束后的 $ P $,即 $ P_1,P_2,\ldots,P_N $,用空格分隔。
输入输出样例 #1
输入 #1
6 3
5 6 3 1 2 4
输出 #1
6 1 3 2 4 5
输入输出样例 #2
输入 #2
5 1000000000000000000
1 2 3 4 5
输出 #2
1 2 3 4 5
输入输出样例 #3
输入 #3
29 51912426
7 24 8 23 6 1 4 19 11 18 20 9 17 28 22 27 15 2 12 26 10 13 14 25 5 29 3 21 16
输出 #3
18 23 16 24 21 10 2 27 19 7 12 8 13 5 15 26 17 4 3 9 1 22 25 14 28 11 29 6 20
说明/提示
限制条件
- \(1\leq N\leq2\times10^5\)
- \(1\leq K\leq10^{18}\)
- \(1\leq P_i\leq N\ (1\leq i\leq N)\)
- \(P_i\neq P_j\ (1\leq i<j\leq N)\)
- 输入均为整数
样例解释 1
每次操作后,\(P\) 的变化如下:
- 第 \(1\) 次操作后,\(P=(2,4,3,5,6,1)\)。
- 第 \(2\) 次操作后,\(P=(4,5,3,6,1,2)\)。
- 第 \(3\) 次操作后,\(P=(6,1,3,2,4,5)\)。
因此,输出 6 1 3 2 4 5。
样例解释 2
由于 \(P_i=i\) \(,无论操作多少次,\) \(P\) 都不会发生变化。
这段代码求的是排列经过 \(K\) 次“\(P_i \leftarrow P_{P_i}\)”操作后的结果。
关键观察
一次操作相当于新的排列 \(P' = P \circ P\),即 \(P'[i] = P[P[i]]\)。
所以:
- 第 \(1\) 次操作后:\(P \to P^2\)
- 第 \(2\) 次操作后:\(P^2 \to (P^2)^2 = P^4\)
- 第 \(K\) 次操作后:\(P \to P^{2^K}\)
因此,只需要求排列 \(P\) 的 \(2^K\) 次幂。
循环分解
排列可以分解成若干个不相交的循环。
对于一个长度为 \(L\) 的循环:
其中 \(P[c_j] = c_{(j+1)\bmod L}\)。
那么 \(P^{2^K}\) 在这个循环上的效果就是:
即每个元素向后移动 \(2^K\) 步。
代码流程
- 读入 \(N,K\) 和排列 \(P\)。
- 用
vis标记已访问节点,找出所有循环。 - 对每个循环,设长度为 \(L\)。
- 计算位移量:
即 \(2^K \bmod L\)。shift = pow_mod(2, K, L); - 更新循环内每个元素:
P[cyc[j]] = cyc[(j + shift) % L]; - 输出更新后的 \(P\)。
快速幂
因为 \(K\) 可达 \(10^{18}\),不能直接算 \(2^K\),所以用快速幂计算 \(2^K \bmod L\)。
复杂度
- 时间:\(O(N \log K)\),主要花在快速幂上。
- 空间:\(O(N)\)。
点击查看代码
#include <bits/stdc++.h>
#define int long long
#define fi first
#define se second
#define be begin()
#define en end()
using namespace std;
const int N=2e5+5;
const int mod=998244353;
const int inf=1e18;
int pow_mod(int a,int b,int m)
{
    if(m==1)return 0;
    int res=1%m;
    a%=m;
    while(b>0)
	{
        if(b&1)res=(res*a)%m;
        a=(a*a)%m;
        b>>=1;
    }
    return res;
}
signed main()
{
    ios::sync_with_stdio(false);
    cin.tie(0);
    cout.tie(0);
    int n,K;
    cin>>n>>K;
    vector<int> P(n+1);
    for(int i=1;i<=n;i++) cin>>P[i];
    vector<bool> vis(n+1,0);
    for(int i=1;i<=n;i++)
	{
        if(!vis[i])
		{
            vector<int> cyc;
            int cur=i;
            while(!vis[cur])
			{
                vis[cur]=1;
                cyc.push_back(cur);
                cur=P[cur];
            }
            int L=cyc.size();
            int shift=pow_mod(2,K,L);
            for(int j=0;j<L;j++)
			{
                int nxt=cyc[(j+shift)%L];
                P[cyc[j]]=nxt;
            }
        }
    }
    for(int i=1;i<=n;i++) cout<<P[i]<<" ";
    return 0;
}
//cout<<fixed<<setprecision(1);
CF173B Chamber of Secrets
题目描述
“密室再次被打开了。”——这个消息传遍了霍格沃茨,而一些学生因为看到蛇怪而被石化。虽然邓布利多被迫离开了学校,但哈利正尝试进入密室。而这对伏地魔可不是什么好消息。他不希望任何人进入密室。因为他正在吸取金妮的灵魂。
密室是一个 \(n×m\) 的矩形网格,其中一些单元格有柱子。光线(蛇怪的凝视)可以穿过柱子而不改变方向。但是通过一些魔咒,我们可以让柱子在接收光线时反射所有光线向四个方向射去。如下图所示。

左边光线穿过没有施魔法的柱子,右边光线穿过施魔法的柱子,效果如图。蛇怪在密室的右下角,向左边凝视。据传说,直接看见蛇怪的眼睛就会马上死亡,而看到通过柱子的反射光线就会被石化。我们知道,密室的入口在左上角,而进入的人必须注视他所要移动的方向。图片就是第一个样例。

给定密室的大小,和普通柱子的位置,伏地魔想要让你对最少的柱子施法,使所有人不能进入密室;或者表示不能完成保护密室的任务。
输入格式
输入的第一行包含两个整数 \(n\) 和 \(m\) \((2 \le N,M \le 1000)\)接下来 \(n\) 行每行包含 \(m\) 个字符。每个字符都是 . 或 #。表示密室的一个单元格。如果为 .表示为空,如果为 # 表示有柱子。
输出格式
输出所需要施法的柱子在最小值,如果不可能完成,则输出 -1。
输入输出样例 #1
输入 #1
3 3
.#.
...
.#.
输出 #1
2
输入输出样例 #2
输入 #2
4 3
##.
...
.#.
.#.
输出 #2
2
说明/提示
图片为样例解释,将两根柱子都施魔法才可以阻止哈利进入密室。
这段代码求的是从蛇怪位置 \((n,m)\) 向左发射的光线,通过给最少的柱子施法,使其能够到达入口 \((1,1)\) 所需的最少施法次数。
核心建模
把每一行看作一个节点,每一列看作一个节点。
如果格子 \((i,j)\) 有柱子,就在行 \(i\) 和列 \(j\) 之间连一条边。
- 光线原本沿着某一行传播,遇到柱子时:
- 不施法:光线直接穿过,继续沿原行传播。
- 施法:光线可以向四个方向反射,等价于可以从当前行切换到该柱子所在的列。
- 同理,光线沿着某一列传播时,遇到柱子施法后可以切换到该柱子所在的行。
因此,每施法一个柱子,就相当于在行节点和列节点之间走一步,代价为 \(1\)。
问题转化为:从行 \(n\) 出发,到达行 \(1\) 的最短路径长度。
为什么终点是行 \(1\)?
因为入口在 \((1,1)\),只要光线能到达第 \(1\) 行,它就可以沿着第 \(1\) 行传播到 \((1,1)\)。
BFS 过程
dist_row[i]:到达第 \(i\) 行所需的最少施法次数。dist_col[j]:到达第 \(j\) 列所需的最少施法次数。- 起点:行 \(n\),
dist_row[n] = 0。 - 队列元素
(type, id):type = 0表示当前在行id;type = 1表示当前在列id。
从行 \(i\) 出发,遍历该行所有柱子 \((i,j)\),可以到达列 \(j\),距离 \(+1\)。
从列 \(j\) 出发,遍历该列所有柱子 \((i,j)\),可以到达行 \(i\),距离 \(+1\)。
最终 dist_row[1] 就是答案。如果仍为 \(-1\),说明无法到达入口,输出 -1。
复杂度
- 每个柱子最多被访问两次(一次从行,一次从列)。
- 时间复杂度 \(O(nm)\),空间复杂度 \(O(n+m)\)。
代码要点
- 用
row_cols[i]存第 \(i\) 行所有柱子的列号。 - 用
col_rows[j]存第 \(j\) 列所有柱子的行号。 - BFS 时注意行列节点类型的切换。
- 起点是行 \(n\),不是格子 \((n,m)\),因为光线沿着第 \(n\) 行向左,只要行 \(n\) 上有柱子就可以转向。
点击查看代码
#include <bits/stdc++.h>
#define int long long
#define COUT cout<<"\n------------------------------------------------------------------------------------------\n";
#define fi first
#define se second
#define be begin()
#define en end()
using namespace std;
const int N=2e5+5;
const int mod=998244353;
const int inf=1e18;
signed main()
{
    ios::sync_with_stdio(false);
    cin.tie(0);
    cout.tie(0);
    int n,m;
    cin>>n>>m;
    vector<string> g(n+1);
    for(int i=1;i<=n;i++)
	{
        cin>>g[i];
        g[i]=" "+g[i];
    }
    vector<vector<int>> row_cols(n+1);
    vector<vector<int>> col_rows(m+1);
    for(int i=1;i<=n;i++)
	{
        for(int j=1;j<=m;j++)
		{
            if(g[i][j]=='#')
			{
                row_cols[i].push_back(j);
                col_rows[j].push_back(i);
            }
        }
    }
    vector<int> dist_row(n+1,-1);
    vector<int> dist_col(m+1,-1);
    queue<pair<int,int>> q;
    dist_row[n]=0;
    q.push({0,n});
    while(!q.empty())
	{
        auto [type,id]=q.front();
		q.pop();
        if(type==0)
		{
            int d=dist_row[id];
            for(int j:row_cols[id])
			{
                if(dist_col[j]==-1)
				{
                    dist_col[j]=d+1;
                    q.push({1,j});
                }
            }
        }
		else
		{
            int d=dist_col[id];
            for(int i:col_rows[id])
			{
                if(dist_row[i]==-1)
				{
                    dist_row[i]=d+1;
                    q.push({0,i});
                }
            }
        }
    }
    if(dist_row[1]==-1) cout<<-1<<"\n";
	else cout<<dist_row[1]<<"\n";
    return 0;
}
AT_arc084_b [ABC077D] Small Multiple
题目描述
给定一个整数 \(K\)。求一个 \(K\) 的正整数倍 \(S\),使得 \(S\) 的数位累加和最小。
输入格式
一行一个正整数 \(K\)。
输出格式
输出 \(K\) 的正整数倍的最小数位累加和。
翻译提供者:Tang_pipi
输入输出样例 #1
输入 #1
6
输出 #1
3
输入输出样例 #2
输入 #2
41
输出 #2
5
输入输出样例 #3
输入 #3
79992
输出 #3
36
说明/提示
- \(2 \le K \le {10}^5\);
- \(K\) 是整数。
这段代码求的是 \(K\) 的正整数倍中,数位和的最小值。
核心思路
任何正整数都可以从 \(1\) 开始,通过两种操作构造出来:
- 乘以 \(10\):相当于在末尾添 \(0\),数位和不变。
- 加 \(1\):相当于数值加 \(1\),数位和增加 \(1\)(在最优构造中可避免进位,因此数位和恰好增加 \(1\))。
因此,我们可以在模 \(K\) 的意义下进行状态转移:
- 当前余数为 \(r\),数位和代价为 \(c\)。
- 操作一:\(r \to (10r) \bmod K\),代价不变。
- 操作二:\(r \to (r+1) \bmod K\),代价加 \(1\)。
目标是从初始状态 \(r=1\)(数字 \(1\),数位和 \(1\))出发,到达 \(r=0\),且总代价最小。这个最小代价就是答案。
为什么用 0-1 BFS
操作一的代价为 \(0\),操作二的代价为 \(1\),所以这是一个边权只有 \(0\) 和 \(1\) 的最短路问题。
使用双端队列:
- 代价 \(0\) 的边从队首插入。
- 代价 \(1\) 的边从队尾插入。
这样就能保证每次取出队首时,其代价都是当前最小的。
代码流程
- 读入 \(K\)。
- 初始化双端队列,放入状态
{1, 1},表示余数 \(1\),代价 \(1\)。 - 当队列非空:
- 取出队首状态
(r, c)。 - 若 \(r\) 已访问过,跳过。
- 标记 \(r\) 已访问。
- 若 \(r == 0\),输出 \(c\) 并结束。
- 扩展:
- 乘 \(10\):新余数
(r * 10) % K,代价仍为 \(c\),从队首插入。 - 加 \(1\):新余数
(r + 1) % K,代价为 \(c + 1\),从队尾插入。
- 乘 \(10\):新余数
- 取出队首状态
- 若队列空仍未找到,但本题保证有解,所以不会发生。
正确性说明
任何正整数 \(S\) 都可以从 \(1\) 开始,按十进制位从左到右构造:对于每一位数字 \(d\),先乘 \(10\),再加 \(d\) 次 \(1\)。
这样总加 \(1\) 次数为 \(S\) 的数位和减 \(1\),加上初始的 \(1\),总代价正好等于 \(S\) 的数位和。
因此,到达余数 \(0\) 的最小代价就是最小数位和。
复杂度
- 每个余数 \(0 \sim K-1\) 最多入队一次。
- 时间复杂度 \(O(K)\),空间复杂度 \(O(K)\)。
- \(K \le 10^5\),完全足够。
代码注意点
- 初始状态是
{1, 1},因为数字 \(1\) 的余数为 \(1 \bmod K\),数位和为 \(1\)。 - 使用
vis数组避免重复处理同一个余数。 - 输出的是代价
i.se,即数位和。
点击查看代码
#include <bits/stdc++.h>
#define int long long
#define COUT cout<<"\n--------------------------------------------------------------\n"
#define fi first
#define se second
#define be begin()
#define en end()
using namespace std;
const int N=2e6+5;
const int mod=998244353;
const int inf=1e18;
bool vis[N];
signed main()
{
    ios::sync_with_stdio(false);
    cin.tie(0);
    cout.tie(0);
    int k;
    cin>>k;
    deque<pair<int,int>> p;
    p.push_back({1,1});
    while(!p.empty())
	{
        pair<int,int> i=p.front();
        p.pop_front();
        if(vis[i.fi]) continue;
        vis[i.fi]=true;
        if(!i.fi)
		{
            cout<<i.se;
            return 0;
        }
        p.push_front(make_pair(i.fi*10%k,i.se));
        p.push_back(make_pair((i.fi+1)%k,i.se+1));
    }
    return 0;
}
//cout<<fixed<<setprecision(1);
AT_abc223_d [ABC223D] Restricted Permutation
题目描述
请在所有由 \((1, 2, \dots, N)\) 重新排列得到的数列 \(P\) 中,找到满足以下条件的字典序最小的一个:
- 对于 \(i = 1, \dots, M\),在 \(P\) 中 \(A_i\) 必须出现在 \(B_i\) 之前。
如果不存在这样的 \(P\),请输出 -1。
输入格式
输入以如下格式从标准输入读入。
\(N\) \(M\)
\(A_1\) \(B_1\)
\(\vdots\)
\(A_M\) \(B_M\)
输出格式
请输出答案。
输入输出样例 #1
输入 #1
4 3
2 1
3 4
2 4
输出 #1
2 1 3 4
输入输出样例 #2
输入 #2
2 3
1 2
1 2
2 1
输出 #2
-1
说明/提示
限制条件
- \(2 \leq N \leq 2 \times 10^5\)
- \(1 \leq M \leq 2 \times 10^5\)
- \(1 \leq A_i, B_i \leq N\)
- \(A_i \neq B_i\)
- 所有输入均为整数。
样例解释 1
满足条件的 \(P\) 有 \((2, 1, 3, 4), (2, 3, 1, 4), (2, 3, 4, 1), (3, 2, 1, 4), (3, 2, 4, 1)\) 共 \(5\) 个。其中字典序最小的是 \((2, 1, 3, 4)\)。
样例解释 2
不存在满足条件的 \(P\)。
由 ChatGPT 4.1 翻译
这段代码求的是满足所有偏序约束的字典序最小的排列。
核心思路
把约束 \(A_i\) 必须在 \(B_i\) 之前看作一条有向边 \(A_i \to B_i\)。
问题转化为:求这个有向图的字典序最小的拓扑排序。
- 如果图中有环,则不存在满足所有约束的排列,输出
-1。 - 如果没有环,用最小堆维护当前所有入度为 \(0\) 的节点,每次取出编号最小的节点加入答案,并更新其邻居的入度。
这样得到的拓扑序列一定是所有合法排列中字典序最小的。
代码流程
- 读入 \(N, M\)。
- 建图:
g[x].push_back(y)表示 \(x\) 必须在 \(y\) 前面。in[y]++记录 \(y\) 的入度。
- 将所有入度为 \(0\) 的节点放入小根堆
priority_queue<int, vector<int>, greater<int>> q。 - 循环:
- 取出堆顶最小节点
u,加入结果序列o。 - 遍历
u的所有邻居v,将in[v]减 \(1\)。 - 若
in[v]变为 \(0\),将v入堆。
- 取出堆顶最小节点
- 结束后检查
o.size()是否等于 \(N\):- 不等于:说明有环,输出
-1。 - 等于:按顺序输出
o中的元素。
- 不等于:说明有环,输出
正确性
- 拓扑排序保证所有边 \(A_i \to B_i\) 中,\(A_i\) 一定出现在 \(B_i\) 之前。
- 每次从入度为 \(0\) 的节点中选择编号最小的,保证当前能选的最小元素优先放入答案,因此整体字典序最小。
复杂度
- 时间复杂度:\(O((N+M)\log N)\),主要来自堆操作。
- 空间复杂度:\(O(N+M)\)。
- \(N, M \le 2\times 10^5\),可以轻松通过。
注意点
- 代码中注释掉的
if(q.size()>1)是用来判断拓扑序是否唯一的,本题只要求字典序最小,不需要。 - 注释掉的
Yes/No是其他题目的输出格式,本题不需要。 - 最终输出时每个数字后跟一个空格即可,建议最后加换行。
点击查看代码
#include <bits/stdc++.h>
#define int long long
using namespace std;
signed main()
{
    ios::sync_with_stdio(false);
    cin.tie(0);
	cout.tie(0);
    int n,m;
    cin>>n>>m;
    vector<vector<int>> g(n+1);
    vector<int> in(n+1,0);
    for (int i=0;i<m;i++)
	{
        int x,y;
        cin>>x>>y;
        g[x].push_back(y);
        in[y]++;
    }
    priority_queue<int,vector<int>,greater<int>> q;
    for(int i=1;i<=n;i++) if(in[i]==0) q.push(i);
    vector<int> o;
    while(!q.empty())
	{
        /*if(q.size()>1)
		{
            cout<<"No\n";
            return 0;
        }*/
        int u=q.top();
		q.pop();
        o.push_back(u);
        for(int v:g[u])
		{
            in[v]--;
            if(in[v]==0) q.push(v);
        }
    }
    /*vector<int> a(n+1);
    for(int i=0;i<n;i++) a[o[i]]=i+1;
    cout<<"Yes\n";*/
    if(o.size()!=n)
    {
    	cout<<"-1";
    	return 0;
	}
    for(auto i:o) cout<<i<<" ";
    return 0;
}
AT_abc291_e [ABC291E] Find Permutation
题目描述
有一个长度为 \(N\) 的数列 \(A=(A_1,\ldots,A_N)\),它是 \(1,\ldots,N\) 的一个排列。
你并不知道 \(A\) 的具体内容,但你知道 \(M\) 个整数对 \((X_i,Y_i)\),满足 \(A_{X_i} < A_{Y_i}\)。
请判断是否能够唯一确定数列 \(A\),如果可以,请输出 \(A\)。
输入格式
输入通过标准输入按以下格式给出。
\(N\) \(M\)
\(X_1\) \(Y_1\)
\(\vdots\)
\(X_M\) \(Y_M\)
输出格式
如果能够唯一确定 \(A\),第一行输出 Yes,第二行按顺序输出 \(A_1,\ldots,A_N\),用空格分隔。
如果不能唯一确定 \(A\),仅输出 No。
输入输出样例 #1
输入 #1
3 2
3 1
2 3
输出 #1
Yes
3 1 2
输入输出样例 #2
输入 #2
3 2
3 1
3 2
输出 #2
No
输入输出样例 #3
输入 #3
4 6
1 2
1 2
2 3
2 3
3 4
3 4
输出 #3
Yes
1 2 3 4
说明/提示
限制条件
- \(2 \leq N \leq 2 \times 10^5\)
- \(1 \leq M \leq 2 \times 10^5\)
- \(1 \leq X_i, Y_i \leq N\)
- 所有输入均为整数
- 保证存在至少一个不矛盾的 \(A\)
样例解释 1
可以唯一确定 \(A=(3,1,2)\)。
样例解释 2
\(A\) 可能为 \((2,3,1)\) 或 \((3,2,1)\),有两种可能。
由 ChatGPT 4.1 翻译
这段代码判断能否唯一确定排列 \(A\),若能则输出 \(A\)。
核心思路
条件 \(A_{X_i} < A_{Y_i}\) 可以看作一条有向边:
表示 \(X_i\) 的值必须小于 \(Y_i\) 的值。
因为 \(A\) 是 \(1\sim N\) 的排列,所以值越小越应该排在拓扑序的前面。
因此,问题等价于:判断这个有向图的拓扑排序是否唯一。
- 如果拓扑排序唯一,则能唯一确定 \(A\)。
- 如果某一步同时有多个入度为 \(0\) 的节点,说明这些节点之间没有大小约束,可以交换顺序,\(A\) 不唯一。
代码流程
- 读入 \(N, M\)。
- 建图:
g[x].push_back(y)表示 \(x \to y\)。in[y]++记录入度。
- 将所有入度为 \(0\) 的节点加入队列
q。 - 开始拓扑排序:
- 如果队列中元素个数 \(>1\),说明存在多个可选的最小值,输出
No并结束。 - 否则取出队首
u,加入拓扑序o。 - 遍历
u的所有邻居v,将in[v]减 \(1\)。 - 若
in[v]变为 \(0\),将v入队。
- 如果队列中元素个数 \(>1\),说明存在多个可选的最小值,输出
- 排序结束后,根据拓扑序给每个位置赋值:
o[i]是第 \(i\) 个被选出的节点,它的值应为 \(i+1\)。- 即
a[o[i]] = i + 1。
- 输出
Yes,然后输出 \(A_1, A_2, \ldots, A_N\)。
正确性
- 拓扑序保证所有边 \(X_i \to Y_i\) 中,\(X_i\) 出现在 \(Y_i\) 之前,即 \(A_{X_i} < A_{Y_i}\)。
- 每步队列大小为 \(1\),说明当前可选的最小值唯一,因此整个排列唯一确定。
- 若某步队列大小 \(>1\),则这些节点可以任意交换,对应多个合法排列,故输出
No。
复杂度
- 时间复杂度:\(O(N+M)\)。
- 空间复杂度:\(O(N+M)\)。
- \(N, M \le 2\times 10^5\),完全足够。
注意点
题目保证至少存在一个不矛盾的 \(A\),所以不会出现环导致拓扑排序失败的情况。
代码中普通队列即可,因为每次最多只允许一个元素在队列中。
点击查看代码
#include <bits/stdc++.h>
#define int long long
using namespace std;
signed main()
{
    ios::sync_with_stdio(false);
    cin.tie(0);
	cout.tie(0);
    int n,m;
    cin>>n>>m;
    vector<vector<int>> g(n+1);
    vector<int> in(n+1,0);
    for (int i=0;i<m;i++)
	{
        int x,y;
        cin>>x>>y;
        g[x].push_back(y);
        in[y]++;
    }
    queue<int> q;
    for(int i=1;i<=n;i++) if(in[i]==0) q.push(i);
    vector<int> o;
    while(!q.empty())
	{
        if(q.size()>1)
		{
            cout<<"No\n";
            return 0;
        }
        int u=q.front();
		q.pop();
        o.push_back(u);
        for(int v:g[u])
		{
            in[v]--;
            if(in[v]==0) q.push(v);
        }
    }
    vector<int> a(n+1);
    for(int i=0;i<n;i++) a[o[i]]=i+1;
    cout<<"Yes\n";
    for(int i=1;i<=n;i++) cout<<a[i]<<" ";
    return 0;
}
CF1158C Permutation recovery
题目描述
Vasya 写下了一个由 \(1\) 到 \(n\) 的整数的排列 \(p_1, p_2, \ldots, p_n\),即对于所有 \(1 \leq i \leq n\),都有 \(1 \leq p_i \leq n\),且 \(p_1, p_2, \ldots, p_n\) 两两不同。之后,他又写下了 \(n\) 个数 \(next_1, next_2, \ldots, next_n\)。其中 \(next_i\) 表示满足 \(i < j \leq n\) 且 \(p_j > p_i\) 的最小下标 \(j\)。如果不存在这样的 \(j\),则定义 \(next_i = n + 1\)。
傍晚放学回家时,Vasya 的笔记本被雨淋湿了,现在有些数字已经无法辨认。排列和一些 \(next_i\) 的值完全丢失!如果某个 \(i\) 的 \(next_i\) 丢失了,则记 \(next_i = -1\)。
现在给定 \(next_1, next_2, \ldots, next_n\)(其中有些可能等于 \(-1\))。请你帮助 Vasya 找出一个 \(1\) 到 \(n\) 的排列 \(p_1, p_2, \ldots, p_n\),使得他可以把它写在笔记本上,并且所有 \(next_i \neq -1\) 的位置都满足题目中的定义。
输入格式
第一行包含一个整数 \(t\),表示测试用例的数量(\(1 \leq t \leq 100\,000\))。
接下来的 \(2 \cdot t\) 行描述每个测试用例,每个测试用例占两行。第一行包含一个整数 \(n\),表示排列的长度(\(1 \leq n \leq 500\,000\))。第二行包含 \(n\) 个整数 \(next_1, next_2, \ldots, next_n\),用空格分隔(\(next_i = -1\) 或 \(i < next_i \leq n + 1\))。
保证所有测试用例中 \(n\) 的总和不超过 \(500\,000\)。
在 hack 数据中只能使用一个测试用例,即 \(T = 1\)。
输出格式
输出 \(T\) 行,第 \(i\) 行为第 \(i\) 个测试用例的答案。
如果不存在满足条件的排列 \(p_1, p_2, \ldots, p_n\),则输出 \(-1\)。
否则输出 \(n\) 个不同的整数 \(p_1, p_2, \ldots, p_n\),用空格分隔(\(1 \leq p_i \leq n\))。所有 \(next_i \neq -1\) 的位置都要满足题目中的定义。如果有多组解,输出任意一组均可。
输入输出样例 #1
输入 #1
6
3
2 3 4
2
3 3
3
-1 -1 -1
3
3 4 -1
1
2
4
4 -1 4 5
输出 #1
1 2 3
2 1
2 1 3
-1
1
3 2 1 4
说明/提示
在第一个测试用例中,对于排列 \(p = [1, 2, 3]\),Vasya 应该写下 \(next = [2, 3, 4]\),因为排列中的每个数都小于其后面的数。显然这是唯一满足条件的排列。
在第三个测试用例中,所有 \(next_i\) 都丢失了,因此任意一个排列都可以作为答案。
在第四个测试用例中,不存在满足条件的排列,因此答案为 \(-1\)。
由 ChatGPT 4.1 翻译
这段代码用单调栈从右往左构造排列,解决 CF1158C。
核心思路
给定 nxt[i] 表示 \(i\) 后面第一个比 \(p_i\) 大的位置。
关键性质:若 nxt[i] = j,则对于所有 \(i < k < j\),都有 \(p_k < p_i\),且 \(p_j > p_i\)。
因此,从右往左处理时,可以用一个栈维护“尚未确定值的位置”。
算法流程
- 从 \(n\) 到 \(1\) 遍历。
- 维护栈
st,栈中存放还未分配值的下标。因为从右往左,栈顶是当前最靠左的未分配位置。 - 对于当前位置 \(i\):
- 若
nxt[i] != -1:- 若
nxt[i] <= n:说明 \(i\) 后面第一个更大值在nxt[i]。那么 \(i\) 和nxt[i]之间的所有位置(它们在栈中位于nxt[i]之上)的值都必须小于 \(p_i\)。于是不断弹出栈顶,直到栈顶等于nxt[i],给弹出的位置分配当前最小的可用值cur++。 - 若
nxt[i] == n+1:说明 \(i\) 后面没有更大的值,那么栈中所有位置的值都小于 \(p_i\),全部弹出并分配。
- 若
- 如果弹出过程中没有找到
nxt[i],说明矛盾,输出-1。
- 若
- 将 \(i\) 压入栈。
- 遍历结束后,栈中剩余位置依次弹出并分配递增的值。
- 最终
ans数组即为构造的排列。
正确性
- 从右往左分配,先弹出的位置得到较小的值,后弹出的(更靠左)得到较大的值。
- 因此对于任意 \(i\),它右边到
nxt[i]之间的位置值都小于 \(p_i\),而nxt[i]位置的值大于 \(p_i\),满足next定义。 - 若已知
nxt互相矛盾,则栈匹配失败,输出-1。
复杂度
- 每个位置最多入栈、出栈一次。
- 时间复杂度 \(O(n)\),空间 \(O(n)\)。
- 所有测试用例的 \(n\) 总和不超过 \(5\times 10^5\),可轻松通过。
点击查看代码
#include <bits/stdc++.h>
#define int long long
#define COUT cout<<"\n------------------------------------------------------------------------------------------\n";
#define fi first
#define se second
#define be begin()
#define en end()
using namespace std;
const int mod=998244353;
const int inf=1e18;
signed main()
{
    ios::sync_with_stdio(false);
    cin.tie(0);
    cout.tie(0);
    int t;
    cin>>t;
    while(t--)
    {
        int n;
        cin>>n;
        vector<int> nxt(n+1);
        for(int i=1;i<=n;i++) cin>>nxt[i];
        bool ok=true;
        for(int i=1;i<=n;i++)
        {
            if(nxt[i]!=-1&&nxt[i]<=i)
            {
                ok=false;
                break;
            }
        }
        if(!ok)
        {
            cout<<-1<<"\n";
            continue;
        }
        vector<int> ans(n+1,0);
        int cur=1;
        stack<int> st;
        for(int i=n;i>=1;i--)
        {
            if(nxt[i]!=-1)
            {
                if(nxt[i]<=n)
                {
                    while(!st.empty()&&st.top()!=nxt[i])
                    {
                        int top=st.top();
                        st.pop();
                        ans[top]=cur++;
                    }
                    if(st.empty()||st.top()!=nxt[i])
                    {
                        ok=false;
                        break;
                    }
                }
                else
                {
                    while(!st.empty())
                    {
                        int top=st.top();
                        st.pop();
                        ans[top]=cur++;
                    }
                }
            }
            st.push(i);
        }
        if(!ok)
        {
            cout<<-1<<"\n";
            continue;
        }
        while(!st.empty())
        {
            int top=st.top();
            st.pop();
            ans[top]=cur++;
        }
        for(int i=1;i<=n;i++) cout<<ans[i]<<" ";
        cout<<"\n";
    }
    return 0;
}
本文来自博客园,作者:Aries2011,转载请注明原文链接:https://www.cnblogs.com/Aries2011/p/23132485

 浙公网安备 33010602011771号