
Mongodb Manual阅读笔记:CH9 Sharding
9.分片(Sharding)
Mongodb Manual阅读笔记:CH2 Mongodb CRUD 操作
Mongodb Manual阅读笔记:CH3 数据模型(Data Models)
Mongodb Manual阅读笔记:CH4 管理
Mongodb Manual阅读笔记:CH5 安全性
Mongodb Manual阅读笔记:CH6 聚合
Mongodb Manual阅读笔记:CH7 索引
Mongodb Manual阅读笔记:CH8 复制集
Mongodb Manual阅读笔记:CH9 Sharding
随着数据增长,shard是多机器处理数据存储的方式。shard是横向扩展的解决方案。
9.1 Sharding说明
9.1.1 Shard的目的
当数据库数据增大,应用程序高吞吐量会对单服务的能力进行挑战。查询过大cpu使用过大,数据过大要要求存储能力,working set 过大要求RAM和IO能力。
为了解决这个问题,有2个基本的方案:水平扩展,垂直扩展。
水平扩展:添加更多的cpu,存储资源来这更加处理能力。大cpu大内存的设备价格会远远大于小设备。
Sharding:是一种水平扩展,把数据分片到各个设备上。每个分片都是一个独立的数据库。
sharding处理大数据,大吞吐量的好处:
1.减少了在每个shard上的操作
2.减少了每个shard上的数据保存量。
9.1.2 Mongodb中的Shard
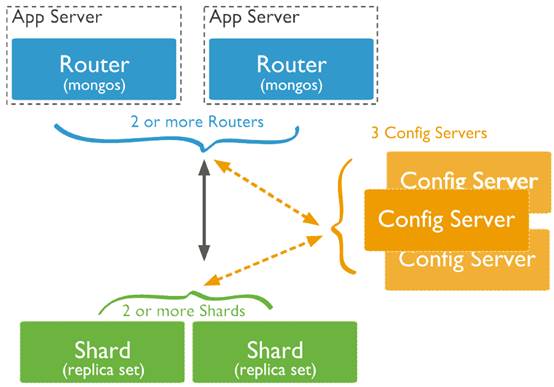
shard集群由以下几个组件:shard,query routers和config server
Shard:用来存储数据。提供高可用和数据一致性,在生产环境下一个shard是一个复制集
Query Routers:或者mongos实例,是客户端的接口然后在合适的shard中型操作然后返回数据。对于shard集群可以包含多余一个router来分流客户端请求。一个客户端发送请求到一个router,大多数shard集群由很多query router。
Config Server:保存集群元数据,query router根据config server上的元数据来决定路由到哪个shard。
9.1.3数据分区
mongodb分发数据或者分配是在collection级别的,同归shard key对collection进行分片。
9.1.3.1 Shard Keys
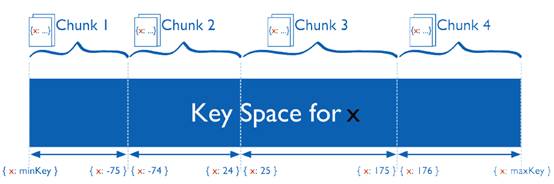
Shard Keys必须每个文档都有,并且要不是索引的字段,要不是组合索引的字段。mongodb把shard key划分为chunks,然后发布这些chunk到各个shard。可以使用range分区也可以是hash分区。
9.1.3.2 Range分区
Mongodb通过shard key把数据分为若干个区间。给定一个Range,key近的理论上在同一个文档上。
9.1.3.3 Hash分区
hash分区是根据文档中的字段计算hash,然后使用这些hash来创建chunk。那么即使shard key值相近也可能不在同一个chunk中。

9.1.3.4 Range分区和Hash分区的性能区别
对于Range分区,区间查询更加有效,路由可以很容易的决定哪些chunk可以覆盖这些查询,然后路由到想要的shard上。
Range分区会导致数据不均匀,会否定shard带来的好处,会导致大量数据堆积在同一个shard上,弱化了shard的优势。
Hash分区确保了数据的均匀分布,但是对于区间查询就不可用对一些shard进行炒作,会对所有shard产生影响。
9.1.4 维护数据均衡发布
新增的数据或者新增的服务会导致数据发布不均衡。有一些chunk会包含比其他chunk大的多的数据,或者比其他chunk的数据更加重要。
9.1.4.1 分离(Splitting)
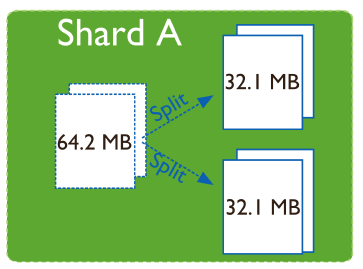
Splitting是一个后台进程,不让chunk变得太大,当chunk超过阀值是就会splits,split会影响元数据,split不会迁移也不会影响shard。
9.1.4.2均衡(Balancing)
均衡器也是后台进程用来管理chunk迁移。
当发布数据不均衡的时候,均衡器会从多的shard迁移到小的shard.
1.chunk迁移的时候,目标shard会获取chunk上的所有文档。
2.然后目标shard获取在迁移过程中所有的修改
3.最后shard修改config中相应的location
4.然后删除源中的chunk。但是要迁移大于1个chunk的时候,不会先删除,而是进入下一个chunk的迁移。
9.1.4.3 增加和删除Shard
增加和删除shard,都要迁移chunk。
9.2 Sharding 概述
9.2.1 Shard集群组件
Shard集群有一下几个组件:
Shard:一个shard是一个mongodb实例,保存了collection数据的一个子集,Shard是单实例,也可以是复制集。
Config Server:每个config server是一个mongod实例,保存了元数据。
Routing Instances:路由是mongos实例,路由从应用程序到shard的读写。应用程序不能直接路由到shard。
9.2.1.1 Shards
Shard可以是复制集也可以是一个实例,保存了shard集群的部分数据。通常shard是一个复制集,复制集为每个shard提供了冗余和可用性。
Primary Shard
每个数据库都有一个primary shard用来保存非shard collection。
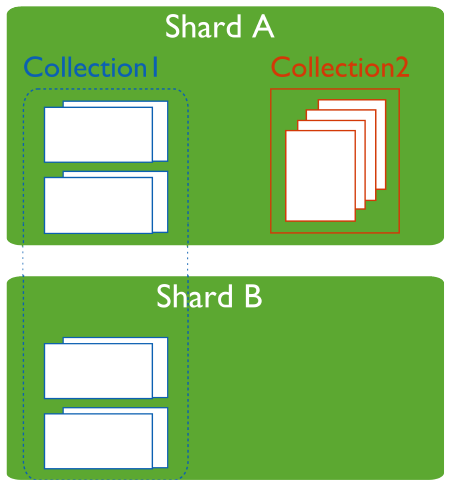
可以使用movePrimary命令来修改shard primary 数据库。当部署新的shard集群时,第一个shard会变成primary。
Shard状态
使用sh.status()来查看shard状态。
9.2.1.2 Config服务
Config服务比较特殊,保存了shard集群内的所有的元数据。Config服务之间使用二阶段提交的方式来保证一致性和可靠性。Config服务不能使用复制集,所有config服务必须是可用的,来保证元数据的修改。
一般生产环境需要3个config服务。当只有一个config 服务,出现单点故障后,config数据被恢复之前是不能访问集群的。
Config数据库
Config服务把元数据存放在config数据库中,mongos会缓存这些数据,来路由数据库操作。
Config服务的读写
只有在一下情况下会写config 服务:
1.在已存在的chunk上创建split
2.在shard之前迁移chunk
再有在一下情况下会读config服务:
1.mongos第一次启动
2.迁移chunk后,mongos更新自己的cache。
Config服务可用性
当有3个config 服务其中1个或2个不可用的时候,集群的元数据变为只读,可以读数据,但是不能迁移chunk或者创建split。
如果3个config服务都不可用,如果不重启mongos那么任然可以使用集群,如果在config服务可用之前mongos重启了,mongos就不能再路由。
当没有元数据的时候集群变得不可操作,所以保持一个可用的完好的config十分重要。备份起到一个很关键作用。Config服务的数据和整个集群比很小,负荷也少,并且config服务并不要求一直可用来支持shard集群。
当shard集群使用的config服务修改了名字或者地址,需要重启每一个mongod和mongos,为了避免这种情况,可以使用CNAME来唯一标示衣蛾ocnfig服务。
9.2.2 Shard集群体系结构
介绍:shard集群要求,生产环境shard集群结构体系,shard集群测试环境的结构体系。
9.2.2.1 Shard集群要求
Shard是很给力的功能,但shard集群有很多设备的要求,增加了整体部署的复杂性。
对于某些情况来说shard是唯一的解决方法:
1.数据集超过了单个实例处理的能力
2.数据集需要的内存超过了单个实例可以提供的内存
3.大量写的需求,使用其他方法无法解决。
如果没有以上的情况,使用shard只会影响整体的复杂性。
Shard的部署比较花时间,如果系统已经到达了处理能力的边界,再部署shard肯定会影响应用程序的使用。
Shard的部署应该在设计数据结构的时候就应该考虑。
数据量需求
集群会管理大量的数据,数据以chunk为单位进行管理,chunk的大小默认是64MB,当shard之间chunk不均衡的时候(超过了阀值),均衡器会在shard之间迁移chunk知道均衡为止。对于小的collection来说shard是不合算的,光增加了复杂性,除非有写入性能的要求。Chunk默认大小64MB,是可以配置的
9.2.2.2生产环境集群结构
在生产环境下,要保证数据冗余和系统高可用。
组件
Config Server:3个Config Server,每个config server有独立的设备,一个shard独占使用config。也就是说config 不能被shard集群共享。
Shards:2个以上的shard,这些shard要求是复制集
Query Rounters(mongos):一个或多个mongos,mongos用来路由,一般是每个应用程序服务都有一个mongos实例。
当然,可以在mongos和应用程序之间使用代理和负载均衡,这种情况下使用client affinity来配置负载均衡,这样同一个链接可以一直使用同一个mongos。
9.2.2.3测试环境的体系结构
测试环境下:1个config server,1个以上shard,一个mongos实例。
9.2.3 Shard集群特性
介绍:shard key,shard集群高可用性,shard集群路由
9.2.3.1 Shard Key
Shard key确定了collection的数据分布,shard key是索引字段,或者是组合索引字段。
Mongodb使用shard key来切分collection,每个区间或者chunk,不能重叠。然后mongodb分发这些chunks。
Hash过的Shard key
也就是说shard key 可以是一个hash值。
选择字段的时候最好,字段有很高的选择性(相同值数量很少)。Hash key在单调递增的字段上也很不错比如objectid或者时间戳。
如果在一个空的collection上使用hash作为shard key,mongodb会自动创建和迁移chunk,所以每个shard会有2个chunk,当然这个可以通过shardCollection命令中的numInitChunks参数来控制,也可以通过split命令手动创建chunk。
Shard key对集群的影响
Shard key通过确定数据的分区和mongos对集群的有效操作来影响性能。
写能力扩展:shard key会增加写入的性能,以下objectid为例。
Mongodb为每个文档创建一个objectid,但是有个问题是,是单调增长的,所有的插入都会在一个chunk上一个shard上,那么这个shard写入能力就是整个集群的写入能力。
只有当单调的增加为shard key的很少有插入,这样对性能的影响比较少。
通常使用shard key需要一点随机性。可以让集群扩展写能力。但同时这样的shard key不能提供查询隔离,这个也是shard key重要特性之一。
查询:mongos提供了应用程序到shard集群的接口,mongos接受应用程序的请求,使用config server的元数据进行路由,路由到有相应数据的mongod。当mongos路由所有查询操作时,shard key会对查询有很大的影响。
查询隔离:在shard环境中,最快的查询是通过shard key 和元数据被路由到一个shard上的查询。对不包含shard key 过滤的查询会被路由到所有的shard会比较慢。若shard key是组合的,查询对shard key 前缀进行过滤,那么可以被路由到某些shard。
Shard key的选择:
1.查询中最常用到的字段
2.哪些操作对性能有很高的依赖
如果一个字段选择度很差,那么就再加个字段提高选择度。
排序:在shard环境下,mongos执行合并排序法来排序从shard中出来的结果
9.2.3.2 Shard集群高可用性
在生产环境下,不能产生单点故障
应用程序或者mongos不可用
如果每个应用程序服务都有自己的mongos,当不可用时,其他的应用可以使用自己的mongos。Mongos自己不保存数据,重启后不会有数据丢失。
一个shard不可用
Shard级别,复制集提供了可用性,如果primary变得不可用,复制集就会投票生成另一个primary。如果是secondary不可用不影响使用。如果系统变得不可恢复,那么增加新的成员来弥补冗余。
复制集所有成员不可用
如果整个复制集不可用,shard内的数据也变得不可用,但是其他shard的数据还是可用的。就有可能读写到其他成员。所有要能够处理这部分数据,调查清楚问题并恢复。
一个以上Config 数据库不可用
如果有3个不同的config数据,config 数据库之间是使用二阶段提交的。整个集群还是可用的,但是chunk迁移,chunk分离。如果所有config不可用,那么整个集群就不可用。
重命名Config服务和集群可用性
如果连接到config的名字和地址被修改,必须重启所有的mongod和mongos。使用CNAME(DNS)可以完成换服务器,但是可以不修改连接字符串。
Shard key和集群可用性
选择Shard Key要考虑:
1.保证mongod可以均匀的分布数据
2.可以扩展写能力
3.保证mongos在大多数查询上可以查询隔离,也就是路由到指定的mongod。
跟多:
1.每个shard应该是一个复制集
2.如果可以隔离大多数操作,shard不可用,只会影响部分数据。
3.如果每个操作都要发布到整个集群,当一个shard不可用会导致整个集群不可用。
9.2.3.3 Shard集群查询路由
Shard对应用程序来说是透明的。Mongos缓存了config的数据,进行路由工作。一般的做法mongos都是在应用程序服务器上,也可以在shard上或者其他专用设备上。
路由进程
Mongos使用一下过程路由到结果:
决定哪些Shard接收查询:
1.确定哪些shard必须接收查询
2.在这些shard上创建游标。
如果查询中使用shard key或者shard key前缀过滤可以只查询shard的子集。
Mongos如何处理查询Modifiers:
如果查询的结果不要求是排序的,mongos会打开一个游标然后循环shard上来的结果。如果指定了排序,那么把排序给shard,mongos在shard基础上执行合并排序。如果有limit会把limit传给shard,再在结果上limit。若有skip那么不会传,如果有limit和skip那么会传limit,传给shard的limit的个数为skip个数加上limit的个数。
诊断到Mongos的连接
如果连接到的是mongos,使用ismaster命令会返回:
{
"ismaster":true,
"msg":"isdbgrid",
"maxBsonObjectSize":16777216,
"ok":1
}
其中msg为isdbgrid,如果连接到的是mongod不会包含isdbgrid。
广播操作和目标操作
在shard集群中操作有2种:
1.会广播到所有shard的操作,如remove
2.以一部分shard为目标的操作,如insert。
Shard和非Shard数据
Shard是在collection级别的,可以在多个数据库的多个collection上shard。不管集群的结构,所有的查询和操作都使用mongos路由到数据中心。
9.2.4 Shard机制
介绍,shard collection均衡,chunk迁移,chunk split,Shard key所有,shard集群元数据。
9.2.4.1 Shard Collection均衡
Mongodb使用均衡器来平衡shard之间的数据。当一个shard的数据过多,均衡器会启动分发给其他shard。
集群均衡器
均衡器是用来均衡shard之间的数据量,默认均衡器是开启的。
任何mongos实例都可以启动均衡流程。当均衡器被激活,mongos要修改config数据库中的lock collection,获得锁。
均衡器一旦启动,只有当chunk均衡的时候才会停止。
Chunk迁移会导致负荷上升,影响应用的性能。有2个方法减少影响:
1.一次只迁移一个chunk
2.或者只有当最大chunks个数和最小chunks个数只差超过一个阀值。
当然也可以临时关闭均衡器
迁移阀值
|
Number of Chunks |
Migration Threshold |
|
Fewer than 20 |
2 |
|
21-80 |
4 |
|
Greater than 80 |
8 |
一旦均衡器启动只有当2个shard的chunk差为2或者迁移失败才会停止。
Shard 大小
默认mongodb会试图占满所有的可用空间,为了保证还有性能和空间继续扩展,要监视磁盘可用空间和磁盘性能。
当添加shard的时候可以设置shard最大大小。可以方式shard往里面移动数据。
9.2.4.2 Shard间Chunk迁移
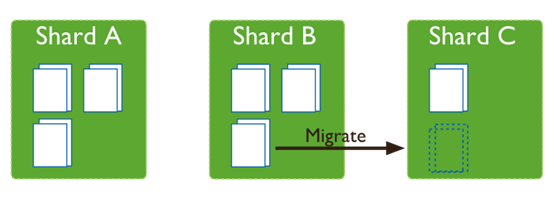
Chunk迁移
Chunk迁移可以:1.手动迁移,2.自动迁移(通过均衡器)
所有的迁移都是一下过程:
1.均衡器发送moveChunk命令道源shard
2.源Shard使用内部的moveChunk命令。源Shard负责处理写入
3.目标Shard开始复制数据
4.接受到之后一个文档之后,目标sahrd开始同步,保证被修改的文档可以被同步过来
5.当都被同步完成,目标shard连接到config数据库,修改集群元数据
6.当修改完元数据,并没有游标,删除chunk上的文档。
若要进行另外一个chunk迁移,不用等待当前chunk删除完成,直接进行。
Chunk迁移队列
为了让迁移速度更快,均衡器并不会等待当前迁移删除chunk,就启动下一个迁移。
Chunk迁移写注意
删除chunk的时候等待发布到secondary,会导致迁移速度下降,但是保证了大量chunk迁移的时候集群的可用性。具体看为chunk迁移修改复制集行为
9.2.4.3 Shard集群下Chunk的分离
当Chunk的大小超过了指定的chunk大小,mongos会把这个chunk分成2半

Chunk大小
默认Chunk的大小为64MB,也可以通过配置增加减少chunk的大小。
1.小的chunk大小,会让数据更加平均,但是迁移量变大,成本增加。
2.大的chunk会让迁移变少,但是数据不均衡。
限制
Chunk大小的修改也会影响chunk分离。
1.自动分离只会发生在插入和修改
2.分离不能被undoen,如果增加了chunk的大小,chunk只有在insert和update的时候增长才会变成新的大小。
9.2.4.4 Shard Key索引
所有的shard collection都要有个索引用于shard key,如果没有文档没有索引,shardCollection命令会在shard key上创建索引。如果已经有文档了,那么要在shardCollection之前创建好索引。
Shard key不能是multikey索引。
如果shard collection在zipcode为shard key可以使用如下方法来替换索引:
1.创建一个索引zipcode,username
2.删除zipcode这个索引
删除了最后一个可用索引之后,可以重新在shard key创建索引来恢复。
9.2.4.5Shard集群元数据
Config服务保存了集群的元数据,元数据反映了状态和shard数据集和系统的组合。mongos实例缓存了这些数据并使用它来路由读写操作。config数据库包含了以下collection:
9.3 Shard集群教程
主要介绍如何管理shard集群
9.3.1 Shard集群部署教程
部署shard集群,考虑shard key,使用hash shard key分片collection,shard集群验证,添加shard到集群,为生产环境部署3个config server,把复制集转化为shard集群,把shard转化为复制集。
9.3.1.1部署shard集群
启动Config服务
config服务是保存了集群元数据的mongod,启动的时候标记configsvr,每个config保存了一份完整的集群元数据。
生产环境下最好在不同的服务器上部署3个config服务。
1.为config服务创建数据文件夹
mkdir /data/configdb
2.启动mongod服务
mongod --configsvr --dbpath <path> --port <port>
默认端口是27019,当然可以通过--port来指定端口。
启动mongos实例
mongos是很轻量的不要求数据文件夹。默认端口是27017。启动mongos的时候需要指定config服务,可以在命令行也可以在配置文件下。最好给每个config服务一个DNS,这样换服务器的时候就不会有下线时间。
mongos --configdb cfg0.example.net:27019,cfg1.example.net:27019,cfg2.example.net:27019
每个mongos启动的时候必须要有相同的configdb配置字符串。
增加Shard到集群中
shard可以是复制集也可以是单个实例,对于生产环境应该要求都是复制集。
1.使用mongo连接到mongos
mongo --host mongos0.example.net --port 27017
2.使用sh.addShard添加shard到集群
添加一个复制集,添加一个成员就可以了,以前的版本要添加所有的成员。
sh.addShard("rs1/mongodb0.example.net:27017")
添加一个单实例shard
sh.addShard("mongodb0.example.net:27017")
启动数据库中的Shard
在真正shard collection之前要先启用数据库的shard。
1.连接到mongos
mongo --host mongos0.example.net --port 27017
2.使用sh.enableShard()命令对数据库启用shard
sh.enableSharding("<database>")
也可以使用命令:db.runCommand({enableSharding:<database>})
启动Collection的Shard
1.确定shard key
2.如果collection已经有数据库的要先在shard key上创建索引使用ensureIndex(),如果是空的,Mongodb会通过sh.shardCollection创建。
3.使用sh.shardCollection() shard一个collection
sh.shardCollection("<database>.<collection>",shard-key-pattern)
shard-key-pattern表示shard key
如:
sh.shardCollection("records.people",{"zipcode":1,"name":1})
sh.shardCollection("people.addresses",{"state":1,"_id":1})
sh.shardCollection("assets.chairs",{"type":1,"_id":1})
db.alerts.ensureIndex({_id:"hashed"})
sh.shardCollection("events.alerts",{"_id":"hashed"})
9.3.1.2考虑Shard Key
选择Shard Key
以下是帮助你找到合适的shard key的策略:
1.在应用程序层先计算好理想的shard key,然后保存到文档中
2.使用组合shard key使用,前缀来提高写能力和读隔离
3.在这些情况下,不好的shard key 并没有很大的影响:有限的写入,预期的数据大小,应用程序查询方式。
4.使用hash shard key,选一个选择度高的然后创建hahs索引。然后使用这个hash索引为shard key的值。
考虑Shard Key的选择性:shard key的选择对性能,选择度,集群的功能影响重大。
创建一个易切分(divisible)的shard key
一个易切分的shard key让mongodb分发数据比较简单,如果只有有限的几个值会让chunk无法分割。
创建一个高随机的shard key
一个高随机的shard key不会让任何一个shard变成瓶颈,并且可以在集群中发布写操作(不会只写入到一个shard)。
对于一个shard创建一个shard key
一个shard一个shard key可以让mongos直接从一个shard上返回结果,但是shard key必须最为主要的过滤条件。使用高随机的shard key 很难再指定的shard 上操作。
使用组合shard key
当存在在collection中的字段都不是最优的key,那么选择多个字段作为组合shard key会更加的理想。
基数(cardinality 选择性类似)
基数决定了这个系统中可以分为几个chunks。
1.如果用state作为shard key,因为state少会造成集群不均衡有以下影响:
a.不能分离chunks因为这个chunk都是同一个shard key,迁移这些chunk变得无比困难。很难让集群均衡。
b.如果固定了chunks的个数,那么就不能超过这个个数了。
2.zipcode字段作为shard key:
这个字段选择度高但是也有可能照成un-splittable的情况,有些用户很多,有些却很少。
3.考虑手机号码作为shard key:
手机号码是高基数(和选择度一样)的,所有的用户都有自己的手机号码并且是唯一的。
高基数可以保证数据均衡,但是不能保证查询隔离和合适的写扩展。
9.3.1.3使用Hash Shard Key
Hash Shard Key是使用Hash索引的字段
Shard Collection
使用shard key来shard collection,
sh.shardCollection( "records.active", { a:"hashed" } )
使用a的hash值作为shard key。
指定初始化Chunks
如果使用hash shard key来shard空的collection,mongodb会自动创建和迁移空的chunks。每个shard有2个chunks。可以使用shardCollection的numInitialChunks来控制初始化collection的chunk个数。
Mongodb hash索引会截断float小数点后面的值,再计算。
9.3.1.4 Shard集群的认证
使用—keyfile来控制集群内组件的互通,keyfile都一样,内容可以随意
过程
1.创建key file保存认证信息
2.通过以下方式启用验证:
a.在配置文件中:keyFile = /srv/mongodb/keyfile
b.在命令行上配置—keyfile
3.添加第一个管理员,创建一个管理员
9.3.1.5添加Shard到集群
当shard增加到集群的时候要保证,集群有足够的能力来迁移数据。
添加一个shard 到集群
1.使用mongo连接到mongos
mongo --host mongos0.example.net --port 27017
2.使用sh.addShard增加shard
添加一个复制集,添加一个成员就可以了,以前的版本要添加所有的成员。
sh.addShard("rs1/mongodb0.example.net:27017")
添加一个单实例shard
sh.addShard("mongodb0.example.net:27017")
9.3.1.6为生产环境部署3个Config服务
这个过程是把只有单个config的测试环境转变为3个config服务的生产环境。
1.关闭所有mongodb进程
2.复制dbpath下的所有文件到其他config服务
rsync -az /data/configdb mongo-config1.example.net:/data/configdb
rsync -az /data/configdb mongo-config2.example.net:/data/configdb
3.启动所有3个config server
mongod --configsvr
4.重启所有的mongod和mongos
9.3.1.7把复制集转化为shard集群
概述
这个过程是把3成员的复制集转为2个shard的集群,每个shard是3成员的复制集。
1.创建选择一个3成员的复制集,插入一些数据到collection
2.启动config数据库,并且创建一个单shard的集群
3.创建第二个复制集
4.把第二个复制集添加到这个集群上
5.在需要shard的collection进行shard。
过程
使用测试数据部署复制集:使用下面的顺序来部署复制集
1.为复制集创建文件夹。
mkdir -p /data/example/firstset1 /data/example/firstset2 /data/example/firstset3
2.启动3个mongod实例
mongod --dbpath /data/example/firstset1 --port 10001 --replSet firstset --oplogSize 700 --rest
mongod --dbpath /data/example/firstset2 --port 10002 --replSet firstset --oplogSize 700 --rest
mongod --dbpath /data/example/firstset3 --port 10003 --replSet firstset --oplogSize 700 --rest
3.使用mongo打开一个shell
4.通过以下命令来初始化复制集
db.runCommand({"replSetInitiate":
{"_id":"firstset", "members": [{"_id":1, "host":"localhost:10001"},
{"_id":2, "host":"localhost:10002"},
{"_id":3, "host":"localhost:10003"}
]}})
{
"info":"Config now saved locally. Should come online in about a minute.",
"ok":1
}
5.使用一下代码插入测试数据
use test
switched to db test
people = ["Marc", "Bill", "George", "Eliot", "Matt", "Trey", "Tracy", "Greg", "Steve", "Kristina", "Katie", "Jeff"];
for(var i=0; i<1000000; i++){
name = people[Math.floor(Math.random()*people.length)];
user_id = i;
boolean= [true, false][Math.floor(Math.random()*2)];
added_at =newDate();
number =Math.floor(Math.random()*10001);
db.test_collection.save({"name":name, "user_id":user_id, "boolean":boolean, "added_at":added_at, "number":number });
}
部署Shard基础设施:这个过程创建了3个config数据库
1.为config服务创建文件夹
mkdir -p /data/example/config1 /data/example/config2 /data/example/config3
2.启动config数据库
mongod --configsvr --dbpath /data/example/config1 --port 20001
mongod --configsvr --dbpath /data/example/config2 --port 20002
mongod --configsvr --dbpath /data/example/config3 --port 20003
3.启动mongos实例
mongos --configdb localhost:20001,localhost:20002,localhost:20003 --port 27017 --chunkSize 1
--chunkSize表示chunk的大小这里是1MB
4.添加第一个shard
a.连接到mongos
mongo localhost:27017/admin
b.增加使用addShard增加sahrd
db.runCommand( { addShard :"firstset/localhost:10001,localhost:10002,localhost:10003" } )
c.返回一下信息说明添加成功
{ "shardAdded":"firstset", "ok":1 }
部署第二个复制集:下面的过程部署第二个复制集
1.创建复制集文件夹
- /data/example/secondset1
- /data/example/secondset2
- /data/example/secondset3
2.启动3个mongod实例
mongod --dbpath /data/example/secondset1 --port 10004 --replSet secondset --oplogSize 700 --rest
mongod --dbpath /data/example/secondset2 --port 10005 --replSet secondset --oplogSize 700 --rest
mongod --dbpath /data/example/secondset3 --port 10006 --replSet secondset --oplogSize 700 --rest
3.连接到mongos
mongo localhost:10004/admin
4.初始化第二个复制集
db.runCommand({"replSetInitiate":
{"_id":"secondset",
"members": [{"_id":1, "host":"localhost:10004"},
{"_id":2, "host":"localhost:10005"},
{"_id":3, "host":"localhost:10006"}
]}})
{
"info":"Config now saved locally. Should come online in about a minute.",
"ok":1
}
5.把复制集增加到集群
use admin
db.runCommand( { addShard :"secondset/localhost:10004,localhost:10005,localhost:10006" } )
是不是只写一个成员就可以了
6.验证shard成员,使用listShards命令
db.runCommand({listShards:1})
{
"shards": [
{
"_id":"firstset",
"host":"firstset/localhost:10001,localhost:10003,localhost:10002"
},
{
"_id":"secondset",
"host":"secondset/localhost:10004,localhost:10006,localhost:10005"
}
],
"ok":1
}
启动Shard:mongodb必须要再数据库和collection级别启动shard
在数据库级别启动Shard:使用enableSharding命令启动数据库
db.runCommand( { enableSharding :"test" } )
{ "ok":1 }
在索引上创建Shard Key:Mongodb使用shard key来发发布数据到shard,一旦决定之后你不能修改shard key。好的shard key:
1.可以均衡的分发数据
2.经常被同时访问的文档会被放在连续的chunk下
3.在活动的shard中有效的分发
Shard key一般的选择是复合索引,hash或者主键。Shard key的选择还是和数据,应用程序结构和使用方式有关。
Shard Collection:
use admin
db.runCommand( { shardCollection :"test.test_collection", key : {"number":1} })
{ "collectionsharded":"test.test_collection", "ok":1 }
之后均衡器会均衡chunk,可以在test下的db.stats()或者db.printShardIngStatus()查看是否在同步。
9.3.1.8把shard集群转化为复制集
把一个有复制集的集群转为复制集
这个例子是,集群只有一个shard复制集,用以下方法把shard转为复制集
1.配置应用程序连接到primary成员
2.如果启动的时候有shardsrv选项,那么删除这个选项。
把集群转为复制集
1.创建一个新的复制集,保证这个复制集的性能能够达到要求。
2.停止所有的写入。通过重新配置应用程序或者停止所有mongos
3.使用mongodump和mongorestore备份恢复数据到新的复制集
4.配置应用程序连接到新的复制集
9.3.2 Shard集群维护教程
查看集群配置,使用相同的名字迁移config服务,使用不同的名字迁移config服务,替换ocnfig服务,迁移shard到不同的硬件,备份元数据,配置均衡器,管理均衡器,删除shard。
9.3.2.1查看集群配置
查看shard可用的数据库
通过在config数据库对databases collection的查询
use config
db.databases.find( { "partitioned":true } )
查看所有的shard
使用listShards命令查看
use admin
db.runCommand( { listShards :1 } )
查看集群的细节
使用db.printShardingStatus,sh.status查看集群的细节
Sh.status返回一下:
Sharding version显示shard元数据版本
Shards显示了shard的列表
Database显示了集群中的所有数据库
Chunks信息显示了每个shard有几个chunk。
9.3.2.2使用相同的hostname迁移config
把config迁移到同名的系统。如果要迁移所有的config那么每个都执行一下过程:
1.关闭这个config server,会影响config数据,只读
2.修改dns指向新的系统
3.复制老的config的数据到新的系统上
rsync -az /data/configdb/ mongodb.config2.example.net:/data/configdb
4.然后以config服务启动mongod
mongod --configsvr
当第三个config启动集群的元数据有可以被写入(可以迁移chunk和split chunk)
9.3.2.3在不同HostName之前迁移config
这个过程迁移config服务到一个新的不同名的服务器,这样会修改config的主机名,还会导致下线时间和集群内的所有进程重启。
如果要迁移所有config,依次按一下过程执行:
1.关闭均衡器
2.关闭config服务,会导致config数据只读
3.复制老的config的数据到新的系统上
rsync -az /data/configdb/ mongodb.config2.example.net:/data/configdb
4.然后以config服务启动mongod
mongod --configsvr
5.关闭所有mongodb进程,包括:shard,mongod或者复制集,提供config服务的mongod,mongos实例。
6.重启所有提供shard服务器的mongod
7.更新mongos的configdb设置
8.重启mongos
9.重启均衡器
9.3.2.4替换一个Config服务
这个过程是替换不可用的config服务。这个过程假设替换过程中,hostname不就被修改。
1.关闭均衡器(是否可以不关闭,是为了让元数据不可写,但是如果config已经出现不可用,没有必要。)
2.提供一个新的系统和之前的设备有一样的hostname
3.关闭其中一个config服务,复制数据到新的设备上
rsync -az /data/configdb/ mongodb.config2.example.net:/data/configdb
4.启动之前是好的config服务
5.启动新的config服务
mongod --configsvr
6.启动均衡器
9.3.2.5迁移集群到不同的硬件环境
这个过程是启动shard集群到一个新的环境下。没有宕机时间,迁移状况下可读写。
如果集群下有单节点shard那么先把这个mongod转变为复制集可以让你的集群一直在可用状态下。
关闭均衡器
关闭均衡器来停止chunk迁移,在整个过程中不要有元数据写入,若均衡器已经启动了迁移,那么先等待均衡器迁移完,在执行这个过程。sh.stopBalancer()来关闭均衡器。然后可以使用sh.getBalancerStatue()来查看均衡器状态。
迁移config服务
从mongos的configdb配置的字符串,从最后一个开始迁移。不要重命名config服务。
1.关闭config服务,元数据变成只读
2.修改DNS指向新的设备
3.复制数据到新的设备上
rsync -az /data/configdb/ mongodb.config2.example.net:/data/configdb
4.然后以config服务启动mongod
mongod --configsvr
重启mongos实例
如果configdb修改是迁移的一部分,那么就需要在修改configdb之前关闭mongos。避免出现configdb字符串不一样的冲突。
如果configdb保持不变,只要顺序的迁移就可以了:
1.关闭mongos实例,使用shutdown命令,如果configdb字符串要修改,要关闭所有mongos实例。
2.如果config服务hostname修改,更新所有mongos上configdb字符串。
3.重启mongos实例确保已经更新了configdb。
迁移Shard
使用一下过程迁移shard
迁移一个复制集:为了迁移整个集群,就需要迁移shard,要迁移shard,就要迁移secondary。
如果是2个vote的集群那么要加一个仲裁,迁移结束后可以把仲裁删掉。
迁移复制集的一个成员:
1.关闭mongod,确保感觉关闭,可以使用shutdown命令
2.启动数据文件夹到新的设备上
3.在新的设备上重启mongod
4.连接到集群的当前primary
5.如果hostname被修改,使用rs.reconfig()重新配置。
cfg=rs.conf()
cfg.members[2].host="pocatello.example.net:27017"
rs.reconfig(cfg)
6.确认复制集配置,rs.config()
7.等待成员恢复,使用rs.status()查看状态
迁移Shard复制集中的Primary:迁移过程中,当执行选举的时候才会让复制集不可用,不能执行读写。但是选举的过程很快。
1.stepDown primary让secondary上来当primary
2.查看复制集进程,看看是否成功变成secondary,变成secondary之后在执行迁移secondary的步骤。
迁移单实例Shard:单实例shard迁移的时候,先转化为复制集然后再迁移。
重新启动均衡器
连接到mongos实例,然后执行sh.setBalancerState(true)
9.3.2.6备份集群元数据
1.关闭均衡器
2.关闭其中一个config
3.备份整个数据文件夹
4.重新启动config
5.启动均衡器
9.3.2.7配置均衡器进程行为
均衡器运行在其中一个mongos上,保证chunks在集群中的均衡分布。默认的均衡器的配置已经足够使用了。管理员也有可以根据应用来重新配置均衡器。
配置均衡器调度窗口
均衡器调度窗口,是均衡器只能在这个窗口时间内调度。
配置默认chunk大小
默认chunk的大小为64MB,当然可以修改chunk的大小,通过修改config数据库中的settings collection。也可以在mongos启动是,指定参数--chunkSize来指定chunk的大小。
修改指定Shard的最大存储大小
最大存储大小,指定后,如果mapped大小超过了最大存储大小,均衡器就不会再移入数据这个mapped大小是值所有被映射的数据库文件的大小。maxsize被保存在config数据库中的shards collection下。
默认maxsize可以无限大,撑满所有可用空间为止。这个maxsize可以在添加shard的时候指定也可以手动修改:
1.通过addShard指定,单位MB
db.runCommand( { addshard : "example.net:34008", maxSize : 125 } )
2.修改已存在shard的maxsize
use config
db.shards.update( { _id : "shard0000" }, { $set : { maxSize : 250 } } )
为chunk迁移修改复制集行为
在2.2.1之后_secondaryThrottle变成moveChunk命令的一个参数。_secondaryThrottle可以让均衡器在迁移是等待secondary完成。
2.4之后,_secondaryThrottle默认启动。
当启动之后,secondary会要求写注意为{w:2}来保证修改至少被写入一个secondary。
可以通过以下命令来设置_secondaryThrottle:
useconfig
db.settings.update(
{"_id":"balancer"},
{$set:{"_secondaryThrottle":true}},
{upsert:true}
)
9.3.2.8管理均衡器
检查均衡器状态
使用sh.getBalancerState()查看均衡器状态
检查均衡器锁(查看均衡器是否活动)
为了查看均衡器进程是否活动可以使用以下过程:
1.连接到mongos
2.切换到config
3.查看config中的locks collection查看均衡器是否活动
db.locks.find({_id:"balancer"}).pretty()
输出:
{ "_id":"balancer",
"process":"mongos0.example.net:1292810611:1804289383",
"state":2,
"ts":ObjectId("4d0f872630c42d1978be8a2e"),
"when":"Mon Dec 20 2010 11:41:10 GMT-0500 (EST)",
"who":"mongos0.example.net:1292810611:1804289383:Balancer:846930886",
"why":"doing balance round"}
1.从process可以看出均衡器进程运行在mongos0.example.net下
2.state状态为2 说明在活动中,早期的版本为1
均衡器调度窗口
当数据增长很缓慢,并且迁移会影响性能的时候,可以使用调度窗口来限制均衡器的调度。
1.连接到mongos
2.切换到config数据库
3.使用一下命令来修改调度器窗口
db.settings.update({_id:"balancer"},{$set:{activeWindow:{start:"<start-time>",stop:"<stop-time>"}}},true)
如:
db.settings.update({_id:"balancer"},{$set:{activeWindow:{start:"23:00",stop:"6:00"}}},true)
删除均衡器调度窗口
使用一下命令来删除调度窗口
useconfig
db.settings.update({_id:"balancer"},{$unset:{activeWindow:true}})
关闭均衡器
默认均衡器只有在需要均衡数据的时候运行。也可以使用一下过程关闭均衡器:
1.连接到mongos
2.使用命令sh.setBalancerState(false)来关闭均衡器
3.通过sh.getBalancerState()来获取均衡器状态
可以用以下代码验证关闭后不再有迁移:
useconfig
while(sh.isBalancerRunning()){
print("waiting...");
sleep(1000);
}
驱动下,关闭均衡器只能修改settings collection
db.settings.update({_id:"balancer"},{$set:{stopped:true}},true)
启动均衡器
1.使用mongo连接到mongos
2.使用以下任意一种语句来启用:
sh.setBalancerState(true)
db.settings.update({_id:"balancer"},{$set:{stopped:false}},true)
在备份的时候关闭均衡器
mongodb在迁移时备份会导致数据不一致,所以要在备份时关闭均衡器。可选方法:
1.设置均衡器调度窗口,在窗口外备份
2.手动关闭均衡器
如果关闭均衡器的时候有迁移在处理,那么会先等待迁移完成,然后清理掉之后要迁移的。
要在备份前确认是否有均衡器在运行。
!sh.getBalancerState()&&!sh.isBalancerRunning()
9.3.2.9删除Shard集群中的Shard
为了删除shard,必须确认shard中的数据已经被迁移出去了。不要使用一下过程来迁移整个shard集群到一个新的环境。
确保均衡器是启动的
使用sh.getBalancerState()来查看均衡器是否启动。
确定要删除shard的hostname
1.使用listShards查看shard
db.adminCommand( { listShards:1 } )
2.使用sh.status()或者db.printShardingStatus()查看shard
从shard中删除chunk
使用removeShard命令来抽取shard中的chunk到其他shard。
useadmin
db.runCommand({removeShard:"mongodb0"})
输出
{
"msg":"draining started successfully",
"state":"started",
"shard":"mongodb0",
"ok":1
}
检查迁移状态
查看迁移状态可以使用一下命令
useadmin
db.runCommand({removeShard:"mongodb0"})
输出
{
"msg":"draining ongoing",
"state":"ongoing",
"remaining":{
"chunks":42,
"dbs":1
},
"ok":1
}
其中remaining文档显示了剩下要迁移的chunks,dbs表示这个数据库中primary的数据库个数。
移动非shard数据
在shard环境下,只有primary数据库有非shard的collection
1.使用一下命令查看,删除的shard是不是primary
输出中,databases字段列了所有数据库和它的primary,以下结果说明products数据库的primary在mongodb0上:
{ "_id":"products", "partitioned":true, "primary":"mongodb0"}
2.使用movePrimary命令移动primary
db.runCommand({movePrimary:"products",to:"mongodb1"})
这个命令只有当全部处理完之后才会返回
完成迁移
为了清理所有的元数据和完成迁移,再次使用removeShard命令
useadmin
db.runCommand({removeShard:"mongodb0"})
当完成的时候会返回以下结果:
{
"msg":"removeshard completed successfully",
"state":"completed",
"shard":"mongodb0",
"ok":1
}
只有完成到这步的时候,你才能完全的关闭这个shard的进程。
9.3.3 Shard集群的数据管理
创建chunk,split chunk,迁移chunk,修改chunk大小,Tag意向Sharding,管理Shard Tag
,强制唯一键,Shard GridFS数据存储。
9.3.3.1创建Chunks
很多情况下shard集群会自动创建和发布chunk,不需要用户参与,但是有些场景下,Mongodb不能创建猪狗的chunk或者发布数据不够快,如:
1.shard一个以前只存储在primary的collection
2.想要提取大量数据到集群中,这种提取会导致不均衡,特别是单向增长或者单向递减的数据,会插入到单个chunk中。
这些操作时资源密集型有以下几个理由:
1.chunk迁移是把chunk里面的数据从这个shard复制到另外一个shard
2.mongodb一次只迁移一个chunk
3.mongodb只会在插入操作后才split
只能在空的collection上split,如果在已经有数据的collection会自动split,如果手动split,会导致无法估计chunk个数和大小,会影响数据均衡的行为。
例,可以使用一下代码来创建chunk
for ( var x=97; x<97+26; x++ ){
for( var y=97; y<97+26; y+=6 ) {
var prefix = String.fromCharCode(x) + String.fromCharCode(y);
db.runCommand( { split : "myapp.users" , middle : { email : prefix } } );
}
}
9.3.3.2 Split Chunk
如果chunk大小草果chunk size,mongodb会自动的split这个chunk。但是还是会有手动split chunk出现:
1.有大量的数据但是chunk比较少
2.如果想要导入大量的数据,这些数据起初是在单个chunk或shard 上的。
当mongos认为迁移对未来插入性能有好处,均衡器可能会迁移split的chunk到一个新的shard。均衡器不会中断手动的split,也不会中断自动的split。
使用sh.status确定当前chunks
使用split命令来split chunk,要不是middle,要不是find也可以使用sh.splitFind(),sh.splitAt()。
在有某个值的chunk进行平均的split
sh.splitFind( "records.people", { "zipcode":"63109" } )
对指定位置进行split,新的chunk的边界从指定的值开始。
sh.splitAt( "records.people", { "zipcode":"63109" } )
9.3.3.3迁移Chunk
一般chunk迁移都是自动的,但是以下情况可以考虑自动迁移:
1.split空的collection,然后分发他们
2.如果在均衡窗口内无法迁移chunk
使用moveChunk命令来迁移chunk。
db.adminCommand( { moveChunk : "myapp.users",
find : {username : "smith"},
to : "mongodb-shard3.example.net" } )
把包含shard key为 smith的chunk启动到mongodb-shard3
可以使用如下命令迁移:
var shServer = [ "sh0.example.net", "sh1.example.net", "sh2.example.net", "sh3.example.net", "sh4.example.net" ];
for ( var x=97; x<97+26; x++ ){
for( var y=97; y<97+26; y+=6 ) {
var prefix =String.fromCharCode(x) +String.fromCharCode(y);
db.adminCommand({moveChunk :"myapp.users", find : {email : prefix}, to : shServer[(y-97)/6]})
}
}
2.2版本后,会有个_secondaryThrottle参数当为true时,mongodb会保证对chunk的迁移分发到secondary。
当出现以下错误时是有太多游标打开了这个chunk,要不等待游标关闭,要不干掉游标。
The collection's metadata lock is already taken.
9.3.3.4修改Chunk的大小
如果你注意到,自动迁移超过了硬件的处理能力,就可能想要减少chunk大小。修改chunk大小过程:
1.连接到mongos
2.切换到config数据库
3.使用save命令来保存chunk大小
db.settings.save( { _id:"chunksize", value: <sizeInMB> } )
修改chunk有一下几个限制:
1.自动split会在插入或者修改的时候发生
2.如果设置了低的chunk,那么需要时间来split所有的chunk
3.split是不能undone的
4.如果增加了chunk的大小,那么只有通过insert,和update让chunk增长到新的大小。
9.3.3.5 Tag意向Sharding
Mongodb支持通过tag标记一组shard key来指明一个shard或者一组shard。可以通过tag做到以下事情:
1.把数据库隔离到指定的shard
2.保证相关的数据所在的shard 的位置
行为和操作
tag标记了一组shard key。均衡器通过chunk的shard key迁移到tag的高值比chunk低值大的shard下。
如果collection中的chunks不均衡,均衡器迁移,均衡器迁移tag区间内的chunk到,关联到这个tag的shard中。
配置tag,关联到一个或者多个shard之后,集群可能会花一些时间均衡shard中的数据,取决于当前的数据分布。
跨多个tag的chunk
一个chunk包含的shard key可能跨多个tag,为了解决这个问题,均衡器可能会把chunk迁移到比chunk的shard key小的tag上。
如:有2个tag
1.shard key 为100-200的tag NYC
2.shard key为200-300的tag SFO
当有一个chunk要迁移shard key为150-220,那么会被迁移到NYC,因为150到200比到300近。
9.3.3.6管理Shard Tag
标记Shard
使用sh.addShardTag()把tag和指定的shard关联,一个shard可以有多个shard,多个shard也可以有一个tag。
sh.addShardTag("shard0000", "NYC")
sh.addShardTag("shard0001", "NYC")
sh.addShardTag("shard0002", "SFO")
sh.addShardTag("shard0002", "NRT")
使用sh.renoveShardTag来删除关联
sh.removeShardTag("shard0002", "NRT")
标记Shard Key
使用sh.addTagRange()把shard key分配给tag。
1.分配2个数组给NYC
2.分配一个数组给SFO
sh.addTagRange("records.users", { zipcode: "10001" }, { zipcode: "10281" }, "NYC")
sh.addTagRange("records.users", { zipcode: "11201" }, { zipcode: "11240" }, "NYC")
sh.addTagRange("records.users", { zipcode: "94102" }, { zipcode: "94135" }, "SFO")
删除Tag上的Shard key
use config
db.tags.remove({ _id: { ns: "records.users", min: { zipcode: "10001" }}, tag: "NYC" })
查看存在的shard tag
通过sh.status查看被管理到shard的tag,shard的tag被存在config数据库shards collection下,通过查询shards collection查看tag:
use config
db.shards.find({ tags: "NYC" })
tag的shard key组被保存在config的tags collection下,sh.status()也显示了tag的shard key
use config
db.tags.find({ tags: "NYC" })
9.3.3.7 shard集群强制唯一键
唯一约束是在collection中每个文档有一个唯一的值。对于shard集群来说,唯一约束不能约束整个shard collection,只能约束本地的collection。
如果要保证整个collection的唯一性,有2个选择:
1.使用shard key 可以的唯一性
2.为shard collection创建非shard的collection来约束唯一性。
Shard key唯一性约束
过程:可以在shardCollection中指定unique保证唯一性
db.runCommand( { shardCollection : "test.users" , key : { email : 1 } , unique : true } );
限制:
1.只能限制一个字段的唯一性
2.可以使用组合的shard key,只能对组合进行唯一约束
很多情况下,最好的shard key是组合的可以允许读隔离和写扩展。
其他字段的唯一约束
若不能创建到shard key,或者需要在多个字段强制唯一性,你就必须创建一个代理collection,这个collection包含了到原始文旦的引用和要唯一的字段。
过程:如果要在email字段保持唯一性
{
"_id" : ObjectId("...")
"email" ": "..."
}
_id反应了原始文档,email是要唯一的字段
如果collection要shard
db.runCommand( { shardCollection : "records.proxy" ,
key : { email : 1 } ,
unique : true } );
如果不需要shard
db.proxy.ensureIndex( { "email" : 1 }, { unique : true } )
在插入数据时的操作:
db = db.getSiblingDB('records');
var primary_id = ObjectId();
db.proxy.insert({
"_id" : primary_id
"email" : "example@example.net"
})
// if: the above operation returns successfully,
// then continue:
db.information.insert({
"_id" : primary_id
"email": "example@example.net"
// additional information...
})
考虑:
1.你的应用程序必须要能够抓取插入报错
2.如果代理collection要shard,只能在要保持唯一性的字段作为shard key唯一
3.在多于1个字段唯一性,你必须为每个字段创建代理collection,如果要再一个collection上创建多个唯一性,那么就不能shard
9.3.3.8 Shard GridFS数据存储
当要shard一个GridFS存储,考虑一下几点:(不知道为啥要对file collection和 chunk collection进行shard)
File collection
Chunks Collection
9.3.4 Shard集群Troubleshoot
9.3.4.1 Config数据库错误字符串
Mongos的configdb都要使用同一个字符串,不然会有一下错误:
could not initialize sharding on connection
mongos specified a different config database string
9.3.4.2 因为老的config数据导致游标错误
如果mongos没有及时更新元数据的cache:
could not initialize cursor across all shards because : stale config detected
9.3.4.3在移动config服务避免下线
使用DNS名称来减少下线时间,名称一改所有成员都要重启。
9.4 Shard Reference
http://docs.mongodb.org/manual/reference/sharding/
也可以看
http://docs.mongodb.org/manual/reference/

 浙公网安备 33010602011771号