
102402126黄炜杰数据采集实践1
作业1
102402126 黄炜杰
一、作业①:爬取软科2020中国大学排名
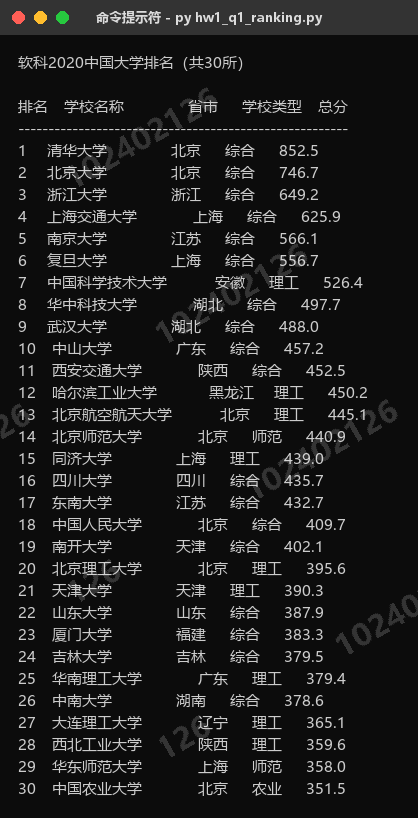
使用 requests 库和 BeautifulSoup 库爬取软科中国大学排名2020版本( http://www.shanghairanking.cn/rankings/bcur/2020 )的数据,屏幕输出排名、学校名称、省市、学校类型、总分等信息。
(一)设计思路
- 使用 requests.get() 发送HTTP请求获取页面HTML源代码,设置User-Agent请求头模拟浏览器访问,避免被反爬机制拦截。
- 用 BeautifulSoup 解析HTML,定位 class 为 rk-table 的排名表格。
- 遍历表格的每一行(tr),提取各列(td)数据:排名取第0列文本,学校名称取第1列内
<img>标签的 alt 属性(中文名),省市取第2列,学校类型取第3列,总分取第4列。 - 格式化输出所有大学的排名信息。
(二)源代码(hw1_q1_ranking.py)
# -*- coding: utf-8 -*-
"""
作业①:爬取软科2020中国大学排名
使用 requests + BeautifulSoup 爬取软科中国大学排名2020版本,
输出排名、学校名称、省市、学校类型、总分。
"""
import requests  # 发送HTTP请求
from bs4 import BeautifulSoup  # 解析HTML

# 请求头,模拟浏览器访问
HEADERS = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

# 软科2020中国大学排名页面URL
URL = "http://www.shanghairanking.cn/rankings/bcur/2020"


def fetch_html(url):
    """发送GET请求并返回页面HTML文本"""
    resp = requests.get(url, headers=HEADERS, timeout=20)  # 发送请求
    resp.encoding = "utf-8"  # 设置编码
    return resp.text


def parse_ranking(html):
    """用BeautifulSoup解析HTML,提取排名表格数据,返回列表"""
    soup = BeautifulSoup(html, "html.parser")  # 创建BS4解析对象
    table = soup.find("table", class_="rk-table")  # 定位排名表格
    rows = table.find_all("tr")  # 获取所有行(含表头)
    result = []
    for row in rows[1:]:  # 跳过表头行
        tds = row.find_all("td")  # 获取该行的所有单元格
        if len(tds) < 5:
            continue
        rank = tds[0].get_text(strip=True)  # 排名
        # 学校名称在td[1]内<img>标签的alt属性中
        img = tds[1].find("img")
        name = img["alt"] if img else tds[1].get_text(strip=True)
        province = tds[2].get_text(strip=True)  # 省市
        school_type = tds[3].get_text(strip=True)  # 学校类型
        score = tds[4].get_text(strip=True)  # 总分
        result.append((rank, name, province, school_type, score))
    return result


def print_ranking(data):
    """格式化打印排名信息"""
    # 表头
    print(f"{'排名':<6}{'学校名称':<20}{'省市':<8}{'学校类型':<8}{'总分':<8}")
    print("-" * 55)
    for rank, name, province, school_type, score in data:
        print(f"{rank:<6}{name:<20}{province:<8}{school_type:<8}{score:<8}")


def main():
    """主函数:获取页面、解析数据、打印结果"""
    html = fetch_html(URL)  # 获取页面HTML
    data = parse_ranking(html)  # 解析排名数据
    print(f"软科2020中国大学排名(共{len(data)}所)\n")
    print_ranking(data)  # 打印结果


if __name__ == "__main__":
    main()
(三)运行结果截图(水印:102402126)
二、作业②:商城商品比价爬虫
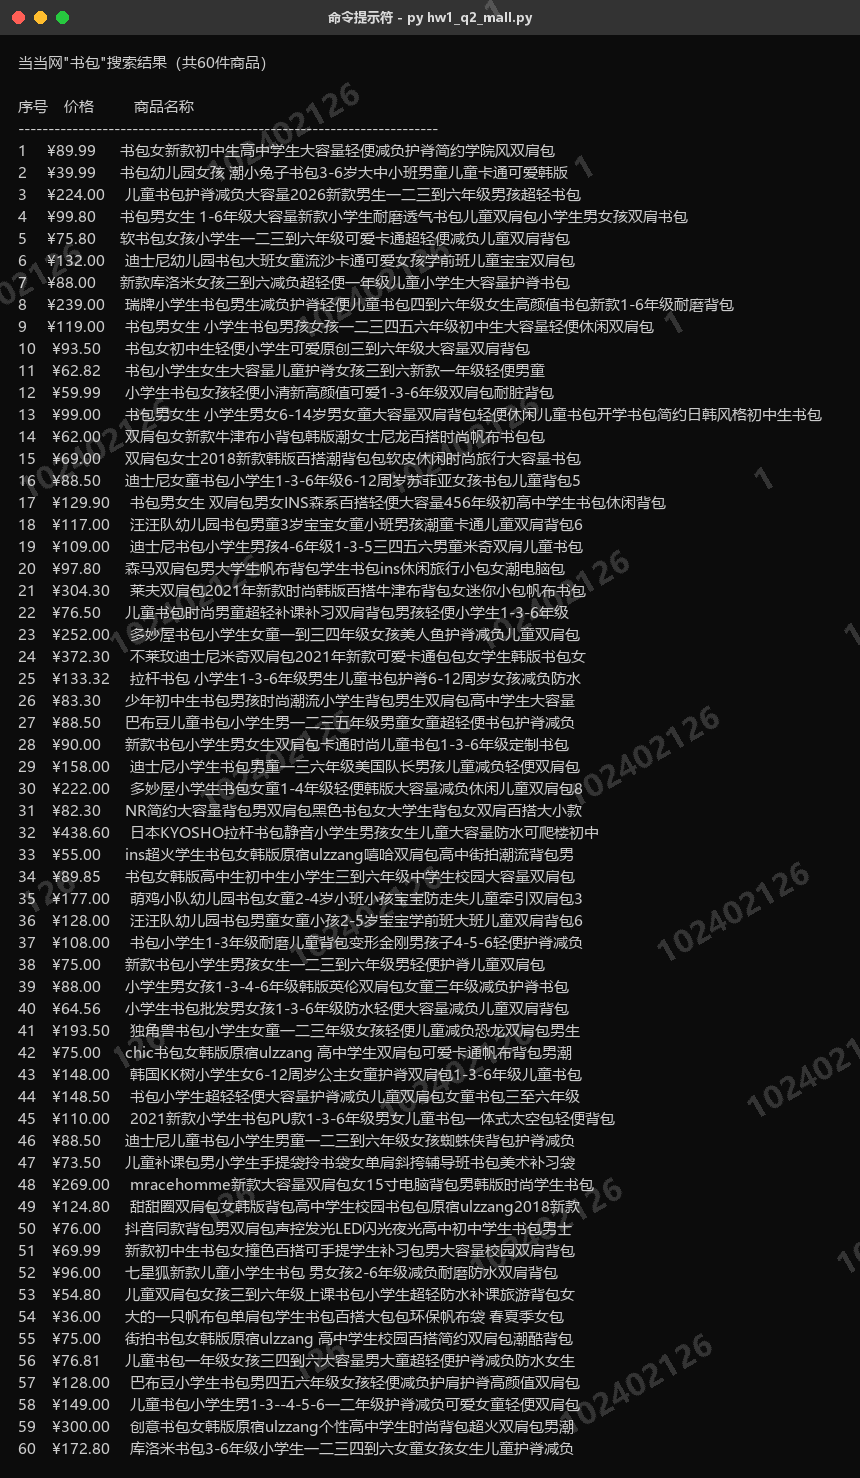
使用 requests 库和 re 库设计一个商城商品比价爬虫,以关键词"书包"在当当网( http://search.dangdang.com )搜索商品,爬取商品名称和价格信息,屏幕输出序号、价格、商品名。
(一)设计思路
- 构造当当网搜索URL(关键词"书包"经URL编码后拼接),用 requests.get() 获取页面。
- 当当网页面编码为 GB2312,需设置 resp.encoding = 'gb2312' 正确解码中文。
- 用正则表达式提取价格:匹配 class="price_n" 标签内的 ¥ 后跟数字的模式。
- 用正则表达式提取商品名:匹配 class="name" 标签内
<a title="...">的 title 属性。 - 将价格与商品名配对,格式化输出序号、价格、商品名称。
(二)源代码(hw1_q2_mall.py)
# -*- coding: utf-8 -*-
"""
作业②:商城商品比价爬虫(当当网)
使用 requests + re 爬取当当网"书包"搜索结果,
提取商品名称和价格,输出序号、价格、商品名。
"""
import requests # 发送HTTP请求
import re # 正则表达式
# 请求头,模拟浏览器访问
HEADERS = {
"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
"(KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}
# 当当网搜索URL(关键词:书包)
URL = "http://search.dangdang.com/?key=%E4%B9%A6%E5%8C%85&act=input"
# 正则:提取价格,匹配 <span class="price_n">¥89.99</span>
PRICE_RE = re.compile(r'class="price_n"[^>]*>¥([\d.]+)')
# 正则:提取商品名,匹配 <p class="name" ...><a title="商品名" ...>
NAME_RE = re.compile(r'class="name"[^>]*>\s*<a\s+title="([^"]+)"')
def fetch_html(url):
"""发送GET请求并返回页面HTML文本(当当网使用GB2312编码)"""
resp = requests.get(url, headers=HEADERS, timeout=20) # 发送请求
resp.encoding = "gb2312" # 当当网页面编码为GB2312
return resp.text
def parse_products(html):
"""用正则表达式提取商品价格和名称,返回(价格, 名称)列表"""
prices = PRICE_RE.findall(html) # 提取所有价格
names = NAME_RE.findall(html) # 提取所有商品名
# 将价格与名称配对,取两者中较短的长度避免越界
count = min(len(prices), len(names))
result = []
for i in range(count):
price = prices[i] # 价格字符串
name = names[i].strip() # 商品名(去除首尾空格)
result.append((price, name))
return result
def print_products(data):
"""格式化打印商品比价信息"""
print(f"{'序号':<6}{'价格':<12}{'商品名称'}")
print("-" * 70)
for i, (price, name) in enumerate(data, 1):
print(f"{i:<6}¥{price:<11}{name}")
def main():
"""主函数:获取页面、解析商品、打印结果"""
html = fetch_html(URL) # 获取搜索页HTML
data = parse_products(html) # 解析商品数据
print(f'当当网"书包"搜索结果(共{len(data)}件商品)\n')
print_products(data) # 打印比价结果
if __name__ == "__main__":
main()
(三)运行结果截图(水印:102402126)
三、作业③:爬取网页所有图片
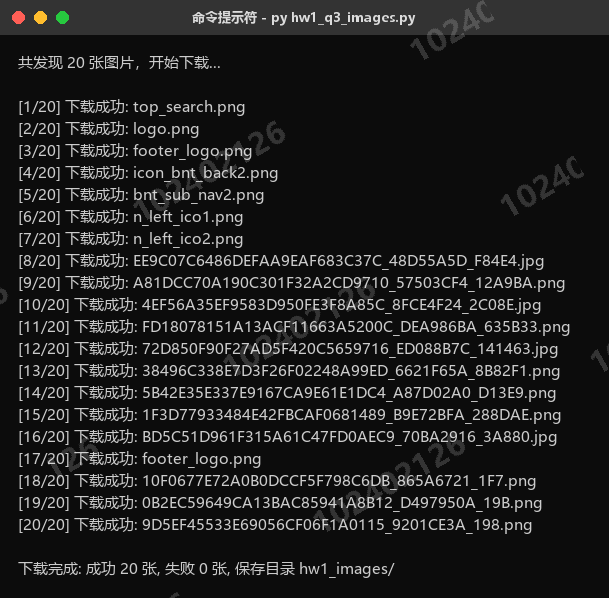
爬取福州大学新闻网页( https://news.fzu.edu.cn/yxfd.htm )中的所有 JPEG/JPG/PNG 格式图片,保存到本地文件夹 hw1_images 中。
(一)设计思路
- 使用 requests.get() 获取福大新闻网页HTML源代码,自动检测页面编码。
- 用 BeautifulSoup 解析HTML,查找所有
<img>标签,通过正则表达式判断 src 属性是否以 .jpg/.jpeg/.png 结尾,筛选出目标图片。 - 用 urllib.parse.urljoin() 将相对URL(如 images/logo.png)转为绝对URL,确保可正常访问。
- 逐张下载图片并保存到 hw1_images 目录,文件名从URL中提取(去除查询参数)。
(二)源代码(hw1_q3_images.py)
# -*- coding: utf-8 -*-
"""
作业③:爬取网页所有JPEG/JPG/PNG图片
使用 requests + BeautifulSoup 爬取福州大学新闻网页,
提取并下载所有JPEG/JPG/PNG格式图片,保存到本地文件夹。
"""
import os  # 文件/目录操作
import re  # 正则表达式
import requests  # 发送HTTP请求
from bs4 import BeautifulSoup  # 解析HTML
from urllib.parse import urljoin  # 拼接相对URL

# 请求头,模拟浏览器访问
HEADERS = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
                  "(KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

# 福州大学新闻网页URL
URL = "https://news.fzu.edu.cn/yxfd.htm"

# 图片保存目录
SAVE_DIR = "hw1_images"

# 支持的图片扩展名正则
IMG_EXT_RE = re.compile(r'\.(jpg|jpeg|png)$', re.IGNORECASE)


def fetch_html(url):
    """发送GET请求并返回页面HTML文本"""
    resp = requests.get(url, headers=HEADERS, timeout=20)  # 发送请求
    resp.encoding = resp.apparent_encoding or "utf-8"  # 自动检测编码
    return resp.text


def extract_img_urls(html, base_url):
    """用BeautifulSoup解析HTML,提取所有JPEG/JPG/PNG图片URL"""
    soup = BeautifulSoup(html, "html.parser")  # 创建BS4解析对象
    imgs = soup.find_all("img")  # 获取所有<img>标签
    img_urls = []
    for img in imgs:  # 遍历每个img标签
        src = img.get("src", "")  # 获取src属性
        if IMG_EXT_RE.search(src):  # 判断是否为jpg/jpeg/png
            full_url = urljoin(base_url, src)  # 将相对URL转为绝对URL
            img_urls.append(full_url)
    return img_urls


def download_image(url, save_path):
    """下载单张图片并保存到本地"""
    resp = requests.get(url, headers=HEADERS, timeout=30)  # 下载图片
    with open(save_path, "wb") as f:  # 以二进制写入
        f.write(resp.content)


def main():
    """主函数:获取页面、提取图片URL、逐张下载保存"""
    os.makedirs(SAVE_DIR, exist_ok=True)  # 创建保存目录
    html = fetch_html(URL)  # 获取页面HTML
    img_urls = extract_img_urls(html, URL)  # 提取图片URL列表
    print(f"共发现 {len(img_urls)} 张图片,开始下载...\n")

    ok = 0  # 成功计数
    fail = 0  # 失败计数
    for i, url in enumerate(img_urls, 1):  # 遍历图片URL
        # 从URL中提取文件名(去除查询参数)
        clean_url = url.split("?")[0]  # 去除URL查询参数
        filename = os.path.basename(clean_url)
        save_path = os.path.join(SAVE_DIR, filename)
        try:
            download_image(url, save_path)  # 下载图片
            ok += 1
            print(f"[{i}/{len(img_urls)}] 下载成功: {filename}")
        except Exception as e:
            fail += 1
            print(f"[{i}/{len(img_urls)}] 下载失败: {e}")

    print(f"\n下载完成: 成功 {ok} 张, 失败 {fail} 张, 保存目录 {SAVE_DIR}/")


if __name__ == "__main__":
    main()
(三)运行结果截图(水印:102402126)
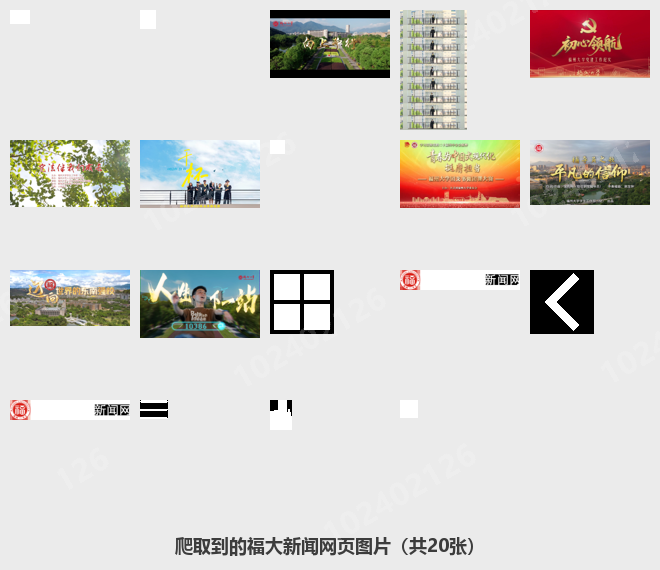
(四)爬取结果展示(水印:102402126)
本次爬取成功下载20张福大新闻网页图片,保存于 hw1_images 目录,下图展示全部图片。

 浙公网安备 33010602011771号