2026软工实践现场编程第9组
2026软工实践现场编程第9组
福州大学 · 软件工程实践 · 2026-11-07 · 妈妈夸我说的队(MumLauds)
项目:拾光账本(Pocket Days)
仓库:platforzation/20261107-personal-account-book
演示视频文件:视频文件
| 作业所属课程 | H202601软件工程与软件工程实践 |
|---|---|
| 作业要求 | 个人记账本现场编程 |
| 作业的目标 | 用 Python + Streamlit + 本地 JSON 做出可运行、可演示的个人记账本,覆盖新增、查看、筛选、统计、图表、编辑删除和 CSV 导出 |
| 团队名称 | 妈妈夸我说的队(MumLauds) |
| 团队成员名字-学号 | 黄锦培-102401221、张智文-102401139、吴怡霏-102401206 姚华俊-82403146、张陈雨菲-102401208、林鑫-102401115 卢志勇-102401118、张楠-102401204、刘俊延-102401133 陈烨婷-102401205 |
0. 一分钟了解这个项目
“拾光账本”是一个基于 Python + Streamlit + 本地 JSON 的个人记账 Web 应用。它不依赖数据库、不联网、不需要登录:启动后在本机浏览器打开,数据只写入项目目录下的 data/records.json。
项目功能覆盖了作业的要求,并把三个可选项也做进了主界面:
- 记一笔:日期、类型、金额、类别、备注,保存前统一校验;
- 看流水:最近 10 笔按发生日期、创建时间倒序;
- 筛选统计:日期区间、类型、类别、金额区间六个条件同时生效,区间含边界;
- 总览与图表:本月收支卡片、近 6 个月/近 7 天趋势、支出类别占比、收入支出对比;
- 编辑删除:按记录 ID 修改或删除,删除需二次确认;
- 导出 CSV:固定七列、UTF-8 BOM、Excel 可直接打开;
- 工程化保障:72 项测试 + 80 个子测试、原子写入、损坏文件保护、并发写锁。
1. 团队与分工
1.1 成员、主责模块与贡献度
| 姓名 | 学号 | GitHub | 主责模块 | 关键提交 / PR | 贡献度 |
|---|---|---|---|---|---|
| 黄锦培 | 102401221 | @coderbrain404 | 组长、任务分配与审核、需求文档、export_data.py、UI 集成与修复 |
2490f2e、01c7409、ebebd76、dcaf12e、715dc55 |
110% |
| 张智文 | 102401139 | @platforzation | app.py 入口、主干集成、README、合并与发布 |
19 次提交;#1—#17 的合并;172f58b、2d1981a |
96% |
| 吴怡霏 | 102401206 | @wynnmour | models.py 数据模型与校验 |
0ab097d;PR #10 |
98% |
| 姚华俊 | 82403146 | @Grim761 | storage.py JSON 持久化 |
913f3f2;PR #4 |
97% |
| 张陈雨菲 | 102401208 | @Diox4n3 | add_record.py 新增链路 |
e9bd93c;PR #7 |
96% |
| 林鑫 | 102401115 | @Yi-shang0101 | view_records.py 最近记录 |
fbfca00、6daa52f;PR #5、#11 |
110% |
| 卢志勇 | 102401118 | @209691048 | filter_records.py 多条件筛选 |
d877bfd、8a9fa8c;PR #9 |
105% |
| 张楠 | 102401204 | @fenhaozi1 | 统计模块(原 statistics.py)与测试 |
8410482、306093a、2dcd698;PR #6、#12 |
96% |
| 刘俊延 | 102401133 | @52HzWhale111 | charts.py 图表 |
8472c21、e73048c;PR #2 |
96% |
| 陈烨婷 | 102401205 | @chen-yeling | manage_records.py 修改/删除 |
7644e18;PR #3、#14、#16 |
96% |
1.2 先定接口,再各写各的
现场编程最容易出问题的地方不是“不会写”,而是“写完合不起来”。我们最开始就提交了需求文档,把接口约定写死:
- 每条记录固定 7 个字段:
id、date、type、amount、category、note、created_at; type只允许income/expense,金额必须大于 0、最多两位小数;- 每个模块只暴露一个公开函数,参数顺序、返回类型不得擅自改;
storage.py是唯一允许读写data/records.json的模块;app.py只做界面编排,不直接open()数据文件;- 业务模块不得反向导入
app.py,避免循环依赖。
这份“接口先行”的约定,让 10 个人可以在同一时间并行开发,而不是等一个人写完再开始。
1.3 模块依赖
app.py / ledger_ui.py
 ├─ add_record.py ─────→ models.py / storage.py
 ├─ view_records.py
 ├─ filter_records.py
 ├─ account_statistics.py ← statistics.py(兼容门面)
 ├─ charts.py ─────────→ account_statistics.py
 ├─ manage_records.py ─→ models.py / storage.py
 └─ export_data.py

storage.py ────────────→ models.py
models.py 不导入任何项目模块;storage.py 只依赖 models.py;app.py 是唯一入口。这个方向保证了每个模块都能单独测试,也让 charts.py 可以只复用统计口径,不重复实现一套计算。
2. 程序运行环境
2.1 环境清单
本节以 v1.0.0(源码提交 2d1981a) 和本次 Windows 实际验证为准。
| 项目 | 版本 / 说明 |
|---|---|
| 操作系统 | Windows x64,已验证源码运行和 EXE 启动 |
| Python | 源码要求 3.10+;本机复测与 Windows 打包使用 3.12.14;免安装版自带运行环境,无需另装 Python |
| Web 框架 | 本机为 Streamlit 1.67.0;源码依赖约束为 >=1.35,<2 |
| 数据处理 | 本机 pandas 2.3.3、Altair 6.3.0;源码对 pandas 的约束为 >=2.0,<3 |
| 浏览器 | 本机使用 Microsoft Edge;PR #17 另记录了 Chrome 桌面与手机尺寸的页面检查 |
| 存储 | UTF-8 JSON,顶层为数组;源码版为 data/records.json,免安装版为 %LOCALAPPDATA%\PocketDays\records.json |
| 本地地址 | 源码版默认 http://127.0.0.1:8501;Windows 免安装版为 http://127.0.0.1:18501 |
| 外部服务 | 核心记账功能不依赖数据库、登录或云同步;运行界面的图片和样式使用本地资源,下载与安装依赖需要联网 |
PR #15 和 PR #17 记录了 Python 3.10 / Streamlit 1.35、Python 3.13 / Streamlit 1.67 两组环境的测试结果。
2.2 启动与测试
方式一:Windows 免安装版。 在 v1.0.0 Release 下载 PocketDays-v1.0.0-windows-x64.zip,完整解压后双击 PocketDays.exe。保留同目录的 _internal 文件夹,不能只复制 EXE。程序会自动打开浏览器;使用期间保留启动窗口,退出时按 Ctrl+C 或关闭启动窗口。仅关闭浏览器标签页不会停止服务。
方式二:从源码运行。 下载并解压 v1.0.0 源码,在项目根目录打开 PowerShell:
# 1. 创建虚拟环境(已安装 Python 3.10+)
python -m venv .venv

# 2. 安装依赖;直接使用虚拟环境中的解释器,无需修改脚本执行策略
.\.venv\Scripts\python.exe -m pip install -r requirements.txt

# 3. 启动源码版
.\.venv\Scripts\python.exe -m streamlit run app.py
# 浏览器打开 http://127.0.0.1:8501
方式三:手机浏览器访问。 手机和电脑连接同一个 Wi-Fi。在电脑上运行 ipconfig,找到当前 Wi-Fi 网卡的 IPv4 地址。完成方式二的依赖安装后,在项目根目录运行下面的命令,将两处 192.168.1.23 都换成电脑的实际地址。
.\.venv\Scripts\python.exe -m streamlit run app.py --server.address=192.168.1.23 --browser.serverAddress=192.168.1.23 --server.port=8501
保持电脑上的服务运行,在手机浏览器打开 http://192.168.1.23:8501(同样换成实际地址)。若 Windows 防火墙弹出提示,允许应用在专用网络上通信。打开页面后,点左上角展开工作台,即可切换记账、筛选和图表页面。
测试依赖 pytest 未列在运行依赖中,需另行安装:
.\.venv\Scripts\python.exe -m pip install pytest
.\.venv\Scripts\python.exe -m pytest -q
本次在 Python 3.12.14 / Streamlit 1.67.0 / pandas 2.3.3 环境中,使用独立临时目录复测 v1.0.0 源码,结果为 72 passed, 80 subtests passed。Windows 发布包通过了 EXE 启动、新增、筛选、图表、编辑删除、CSV 下载、单实例与重启持久化检查。
首次运行没有账本文件时,页面正常显示空状态,首次成功保存后才创建文件。仓库只跟踪 data/records.example.json,真实 data/records.json 已被 .gitignore 排除。
如需在源码版使用示例数据,先停止应用,且仅在没有现有账本时执行:
if (-not (Test-Path -LiteralPath 'data\records.json')) {
    Copy-Item -LiteralPath 'data\records.example.json' -Destination 'data\records.json'
}
源码版与免安装版使用不同的数据目录。从源码版迁移时,先关闭程序并备份两个目录中的现有账本,再复制 records.json,不要直接覆盖已有数据。
2.3 数据与安全边界
- 数据保存在本机,服务默认仅监听
127.0.0.1;不应直接作为公网或多人共享记账服务部署; - 金额以正数保存,收入/支出由
type区分;created_at由程序生成并带时区,界面不允许编辑; - 读取到损坏 JSON 时明确报错,不会把损坏文件当空账本覆盖;
- 保存采用“临时文件 +
fsync+ 原子替换”,避免直接写目标文件造成半截 JSON;这不能代替定期备份,也不是对磁盘损坏或突然断电的绝对保证; RLock只协调同一进程内的读改写。源码版应仅启动一个服务进程操作同一账本;Windows 启动器另有同一用户下的单实例文件锁。
3. 软件运行截图与视频
点击任一截图可查看原图。
3.1 收支总览

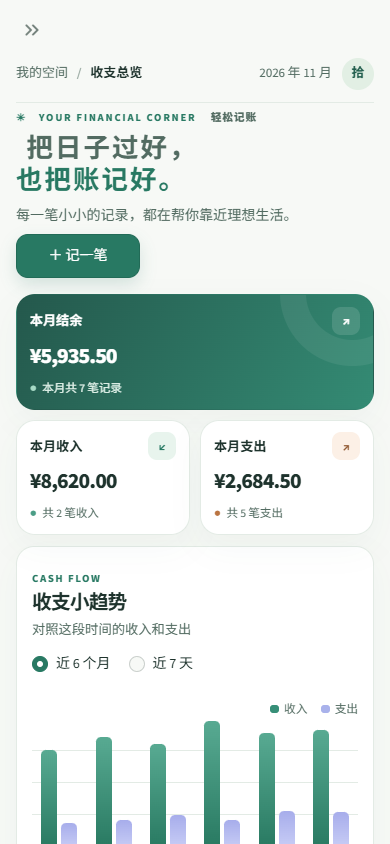
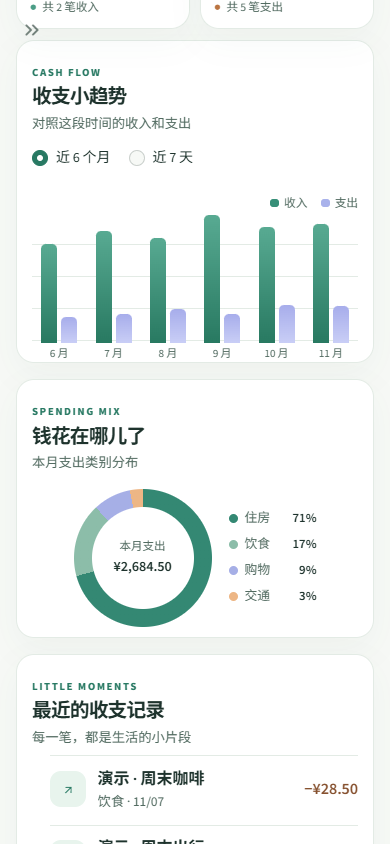
首页集中显示本月结余、收入和支出,下面是收支趋势、支出类别占比与最近流水。
3.2 记一笔


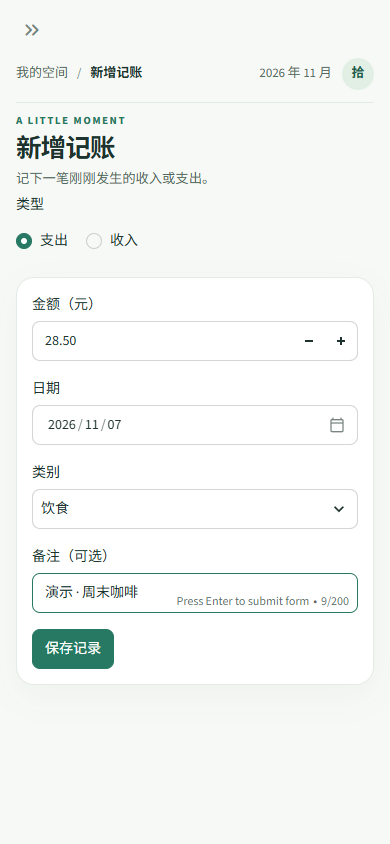
切换收入或支出时,类别选项随之更新。保存后显示金额和类型,并重置表单。
3.3 最近记录与筛选


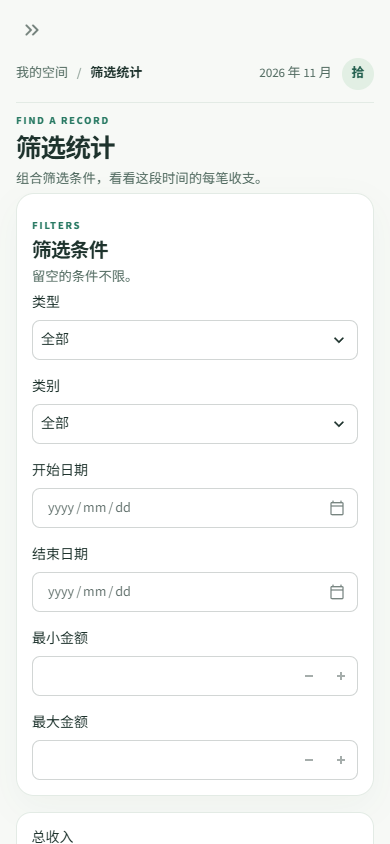
最近记录按记账日期和创建时间倒序。筛选页支持日期、类型、类别和金额区间,并显示匹配记录的收支合计。
3.4 图表与 CSV 导出


图表展示收支对比与支出分类。CSV 固定七列,采用带 BOM 的 UTF-8 编码,空账本也保留表头。
3.5 编辑与删除

选中记录后可修改日期、类型、金额、类别和备注。删除前需要勾选确认。
3.6 移动端检查
使用 390 × 844 的 Chrome 移动视口和独立的演示账本截图。窄屏下侧栏收起,结余卡独占一行,收入与支出卡并排,图表纵向排列。
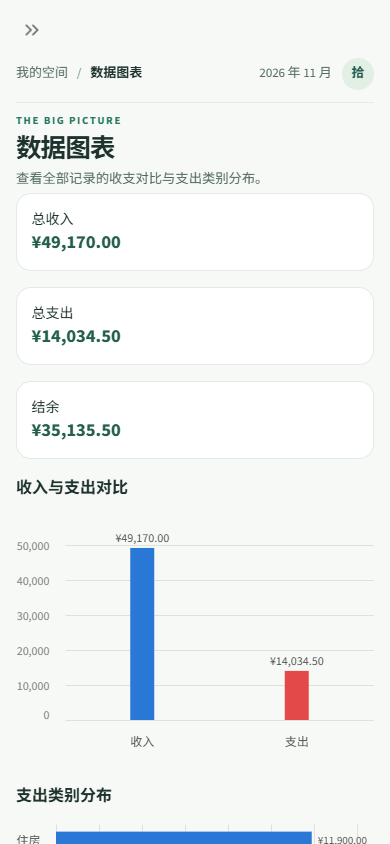
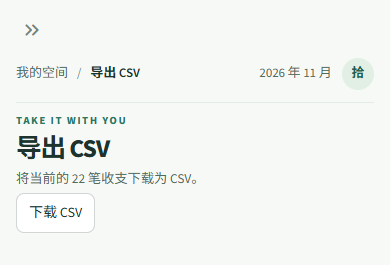
截图见 GitHub PR #18。
3.7 演示视频
- 演示视频文件:视频文件
- 内容:新增记账 → 收支总览 → 数据图表 → 筛选统计 → 最近记录 → 数据图表 → 编辑与删除 → 导出 CSV。
4. 关键代码与注释说明
4.1 数据模型:把脏数据挡在入口
models.py 是唯一的数据字典。它不只检查“字段在不在”,还处理了几个容易被忽略的边界:bool 是 int 的子类、浮点数的小数位、NaN/Infinity、日期是否真实存在、类别是否和收支类型匹配、created_at 是否带时区。
REQUIRED_FIELDS = {
    "id", "date", "type", "amount", "category", "note", "created_at"
}

def validate_record(record: dict) -> None:
    if not isinstance(record, dict):
        raise ValueError("记录必须是字典类型")

    # 字段必须“刚刚好”:缺字段、多字段都不允许
    if set(record.keys()) != REQUIRED_FIELDS:
        raise ValueError("记录字段不完整或包含多余字段")

    # bool 是 int 的子类,必须单独排除 True/False
    if isinstance(amount, bool) or not isinstance(amount, (int, float)):
        raise ValueError("金额必须是数字")

    # 用 Decimal 而不是 float 判断“最多两位小数”
    decimal_amount = Decimal(str(amount))
    if not decimal_amount.is_finite() or decimal_amount <= 0:
        raise ValueError("金额必须大于 0")
    if decimal_amount.as_tuple().exponent < -2:
        raise ValueError("金额最多保留两位小数")

    # 类别必须与 type 匹配,支出不能选“工资”
    valid_categories = EXPENSE_CATEGORIES if record_type == "expense" else INCOME_CATEGORIES
    if category not in valid_categories:
        raise ValueError("所选类别与收支类型不匹配")

    # created_at 必须带时区,保证跨时区排序可比
    parsed_time = datetime.fromisoformat(created_at.replace("Z", "+00:00"))
    if parsed_time.tzinfo is None or parsed_time.utcoffset() is None:
        raise ValueError("创建时间必须包含时区信息")
这段代码的价值在于:错误在进入 JSON 之前就被拦住。界面层只需要捕获 ValueError 并显示,不需要在每个页面重复写校验。
4.2 持久化:临时文件 + 原子替换 + 损坏保护
storage.py 是唯一允许碰 data/records.json 的模块。最关键的三个动作是:保存前先读一次(拒绝覆盖坏文件)、写临时文件并 fsync、用 os.replace 原子替换。
_RECORDS_LOCK = RLock()

def save_records(records: list[dict]) -> None:
    _validate_records(records)
    content = json.dumps(records, ensure_ascii=False, indent=2, allow_nan=False)

    with _RECORDS_LOCK:
        # 如果现有文件已损坏,这里会抛 ValueError;
        # 宁可保存失败,也不要把用户原账本覆盖成一份“空数据”
        load_records()
        _write_records(content)

def _write_records(content: str) -> None:
    temporary_path = None
    try:
        _DATA_FILE.parent.mkdir(parents=True, exist_ok=True)
        with tempfile.NamedTemporaryFile(
            mode="w", encoding="utf-8", dir=_DATA_FILE.parent,
            prefix=f".{_DATA_FILE.name}.", suffix=".tmp", delete=False,
        ) as temporary_file:
            temporary_path = Path(temporary_file.name)
            temporary_file.write(content + "\n")
            temporary_file.flush()
            os.fsync(temporary_file.fileno())   # 确保内容真正落盘

        os.replace(temporary_path, _DATA_FILE)  # 原子替换,避免半截 JSON
    except (OSError, UnicodeError) as exc:
        if temporary_path is not None:
            temporary_path.unlink(missing_ok=True)
        raise ValueError(f"无法保存记录文件 {_DATA_FILE}:{exc}") from exc
tests/test_storage.py 有 17 项测试,覆盖中文往返、空数据、文件不存在、损坏 JSON、非法编码、非有限数字、权限错误、fsync/replace 失败、临时文件清理,以及新进程读取保存结果。
4.3 新增链路:读—改—写必须在同一把锁里
add_record.py 只有 40 多行,但它把“校验 → 读取 → 追加 → 保存”串成了一条完整链路:
def add_record(date: str, record_type: str, amount: float,
               category: str, note: str = "") -> dict:
    # 1. 先创建并校验,校验失败不会碰文件
    record = create_record(date, record_type, amount, category, note)

    # 2. 读—改—写整体加锁,避免两个会话同时追加时丢记录
    with _RECORDS_LOCK:
        records = _load_records()
        if not isinstance(records, list):
            raise ValueError("load_records() 必须返回记录列表")
        _save_records([*records, record])

    return record
这里复用了 storage._RECORDS_LOCK 这把可重入锁,保证同一进程内的读改写不会交错。更理想的做法是由 storage.py 暴露一个 append_record() 事务接口,把锁完全封装起来;这是我们在复盘时记下的一条改进项。
4.4 筛选:六个条件的 AND,区间含边界
filter_records.py 用一条列表推导表达六个条件,None 表示该条件不限制;金额为 0 不会被误判成“没有填写”。
selected = [
    record
    for record in records
    if (start_date is None or record["date"] >= start_date)
    and (end_date is None or record["date"] <= end_date)
    and (category is None or record["category"] == category)
    and (record_type is None or record["type"] == record_type)
    and (min_amount is None or record["amount"] >= min_amount)
    and (max_amount is None or record["amount"] <= max_amount)
]

# 日期优先,同一天再按带时区的创建时间倒序
return sorted(
    selected,
    key=lambda record: (
        record["date"],
        datetime.fromisoformat(record["created_at"].replace("Z", "+00:00")),
    ),
    reverse=True,
)
开始日期晚于结束日期、最低金额高于最高金额、类型不是 income/expense、金额是 NaN 等情况都会抛 ValueError,由界面显示具体原因。
4.5 统计:用 Decimal 累加,避免 0.1 + 0.2
统计模块的公开口径是 calculate_summary() 和 category_totals()。金额先用 Decimal(str(amount)) 转成十进制,再累加,最后统一保留两位。
totals = {"income": Decimal(0), "expense": Decimal(0)}
with localcontext() as context:
    context.prec = 330          # 覆盖有限 float 的整数位与分位
    for record in records:
        record_type = record["type"]
        if record_type not in ("income", "expense"):
            raise ValueError(f"非法收支类型: {record_type}")
        totals[record_type] += _amount(record)

return {
    "income": _money(totals["income"]),
    "expense": _money(totals["expense"]),
    "balance": _money(totals["income"] - totals["expense"]),
    "count": len(records),
}
balance = income - expense 只在最后做一次减法;分类汇总只统计指定 record_type,没有记录时返回 {},不会因为空数据报错。
4.6 CSV 导出:BOM、固定列顺序与公式注入防护
导出看起来简单,但有两个实际坑:Excel 打开 UTF-8 中文会乱码;用户备注以 =、+、-、@ 开头时,可能被电子表格当成公式执行。export_data.py 两个都处理了。
_CSV_FIELDS = ("id", "date", "type", "amount", "category", "note", "created_at")

def _spreadsheet_value(value):
    # 防止 CSV 公式注入:以公式引导符开头的文本加单引号前缀
    if isinstance(value, str) and (
        value.startswith(("\t", "\r", "\n"))
        or value.lstrip().startswith(("=", "+", "-", "@", "=", "+", "-", "@"))
    ):
        return "'" + value
    return value

def export_csv(records: list[dict]) -> bytes:
    with StringIO(newline="") as output:
        csv.writer(output).writerow(_CSV_FIELDS)
        writer = csv.writer(output, quoting=csv.QUOTE_NONNUMERIC)
        for record in records:
            writer.writerow(_spreadsheet_value(record.get(field, "")) for field in _CSV_FIELDS)
        return output.getvalue().encode("utf-8-sig")
utf-8-sig 写入 BOM,QUOTE_NONNUMERIC 让文本字段统一加引号,逗号、换行、引号都能被正确转义;空数据仍然先写表头。
4.7 界面:用 form_version 解决 Streamlit 重跑
Streamlit 每次交互都会从头执行脚本。如果保存成功后不重置表单,用户可能再次点击保存,产生重复记录。app.py 的做法是给表单一个版本号:
form_version = st.session_state.get("add_form_version", 0)
with st.form(f"add-{form_version}"):
    fields = _record_fields(record_type, {"date": date.today().isoformat()})
    submitted = st.form_submit_button("保存记录", type="primary")

if not submitted:
    return

fields["record_type"] = fields.pop("type")
try:
    record = add_record(**fields)
except ValueError as exc:
    st.error(f"保存失败:{exc}")
    return

st.session_state["add_form_version"] = form_version + 1
st.session_state["notice"] = f"已保存:{_TYPE_LABELS[record_type]} {record['amount']:.2f} 元"
st.rerun()
保存成功后版本号 +1,下一次渲染就是一个全新的空表单;提示信息通过 session_state["notice"] 传递,rerun 后显示一次就弹出,不会一直挂在页面上。
5. 三项亮点
亮点一:把“数据不能丢”做成了工程约束,而不是口号
很多课程项目只测“正常保存”,我们花了很大精力在失败路径:
- 保存前先
load_records(),文件损坏时拒绝覆盖; - 临时文件 +
fsync+os.replace,进程中断不会留下半截 JSON; RLock包住读—改—写,避免同一进程内并发追加丢记录;- 17 项存储测试覆盖权限、磁盘、编码、临时文件清理等异常;
.gitignore排除真实数据,仓库只保留records.example.json。
这让“重启不丢数据”不只是演示时的一句说明,而是有测试和代码结构支撑的约束。
亮点二:统一口径:一套字段、一套校验、一套金额算法
- 7 个字段的集合校验,缺字段、多字段都拒绝;
Decimal(str(amount))判断两位小数,避免float精度误判;- 类别与
type强绑定,支出不能选“工资”; created_at必须带时区,跨时区也能正确排序;- 统计统一用
Decimal累加,balance只在最后减一次; - 72 项测试 + 80 个子测试覆盖边界,而不是只测 happy path。
这套口径让界面、筛选、统计、图表、导出看到的是同一份数据,不会出现“列表 100 元、统计 99.99 元”的情况。
亮点三:CSV 下载、图表可视化与移动端适配
- 下载 CSV。用户可直接下载账本,导出文件按固定七列排列,使用带 BOM 的 UTF-8 编码,便于在 Excel 中查看中文记录。
- 图表可视化。总览展示近 6 个月或近 7 天的收支趋势及本月支出类别占比。数据图表页还能查看收支对比、分类金额和对应的数据表。
- 移动端适配。窄屏下侧栏收起,结余卡和图表按屏幕宽度重排。我们在 390 × 844 的移动视口检查了总览、录入、筛选、图表和 CSV 下载。
6. 三个耗时较长、收获较大的事件
6.1 “Add files via upload” 覆盖事故:一次关于分支纪律的教训
发生了什么:组员张智文以“Add files via upload”方式更新了仓库,覆盖了 view_records.py、storage.py、charts.py、add_record.py、manage_records.py、statistics.py 和 app.py 的部分实现。原本已经合并的模块变成了 TODO 或旧版本,tests/test_view_records.py 直接无法导入 get_recent_records。
收获:
- 不再用网页上传覆盖整文件,所有修改走分支 + PR + diff;
- 合并前必须跑全量测试,不能只跑自己模块;
main要始终保持可演示,修复分支要小步、可回滚;- 提交信息要写清楚“改了什么、怎么验证”,否则事故后很难判断。
6.2 统计模块与标准库同名:一个导入路径引发的返工
发生了什么:项目最初把统计模块命名为 statistics.py,和 Python 标准库的 statistics 同名。在 charts.py、app.py 以及测试中导入时,解释器可能拿到标准库而不是项目模块,表现为“统计算出来不对”或导入失败。PR #13 的说明里明确写了“项目统计模块与标准库同名导入冲突”。
收获:
- 不要用 Python 标准库名作为项目模块名;
- 接口兼容可以用很薄的门面层解决,不必大改调用方;
- 全量测试是集成信号,单模块绿不代表项目绿;
- 出问题先复现、再定位、最后才改代码。
6.3 UI 两次返工:设计稿好看,不等于真实数据好看
发生了什么:14:35已经有一版 Streamlit UI;16:32做了“恢复可用账本 + 加固数据处理”;16:49又按“拾光账本 v1.1”设计稿重做真实业务界面,加入品牌侧栏、结余卡、趋势、支出占比、最近流水和空状态。也就是说,最后 20 分钟还经历了一次完整的视觉返工。
争议点:
- 是否直接把
assets/shiguang.html静态稿当成品?——不行,静态稿只有示例数据,不能读写 JSON; - 是否为了视觉效果牺牲表单可用性?——不行,新增、筛选、编辑、导出必须仍然可操作;
- 是否只在一个 Streamlit 版本上验证?——不行,
requirements.txt允许 1.35 到 2.0,CSS 和组件行为会变。
收获:
- 视觉和业务分离,静态稿只做参考,不冒充成品;
- 关键页面用真实浏览器截图验收,不只看 pytest;
- 兼容范围写进
requirements.txt后,就要在两个边界版本上都跑; - 时间不够时,先保证“能演示”,再追求“好看”。
7. 每位成员的团队编程体验
7.1 黄锦培 @coderbrain404:从分工、审核到联调
这次做「拾光账本」,我作为组长,负责一部分任务分配和代码审核,主要实现第 10 号模块 CSV 导出,也参与了业务模块恢复、Streamlit 界面集成和联调。联调时,我发现各模块单独测试通过,合到一起还是会遇到问题,比如统计模块和 Python 标准库重名,导致图表取不到数据。我们通过独立分支和 PR 提交修复,再用同一批测试数据从新增、保存一路验证到筛选和图表展示。这次经历让我体会到,团队编程除了分工写代码,还要提前约定模块接口,认真审核合并的改动,并为联调留出时间。
7.2 张智文 @platforzation:集成不是把文件拼在一起
我主要负责 app.py 的页面编排、主干合并和 README。现场编程最深的体会是:集成不是把 10 个文件放进同一个目录,而是每次合并前都要确认接口、导入路径、数据锁和测试是否仍然成立。中后段两次模块被覆盖,我一边回滚一边补测试,才真正理解“main 随时可演示”比“功能多”更重要。以后我会更早冻结接口、更小步地合并,并把发布检查清单提前到 16:30。
7.3 吴怡霏 @wynnmour:校验的价值在于挡住“看起来没问题”的数据
我负责 models.py 的字段校验。最初以为“金额是数字”就够了,后来发现 bool 是 int 的子类、浮点数的小数位、NaN、没有时区的时间字符串,都会让脏数据进入 JSON。用 Decimal(str(amount)) 和严格的字段集合把边界补齐后,界面层只需要捕获 ValueError。先写测试再改实现,让我对“什么算合法”有了更清楚的定义。
7.4 姚华俊 @Grim761:先想怎么坏,再想怎么好
storage.py 看起来只是读文件、写文件,真正难的是失败路径:文件不存在、JSON 损坏、磁盘写失败、进程中断。最后的方案是临时文件 + fsync + os.replace + RLock,并且保存前先 load_records(),拒绝覆盖坏账本。17 个测试大多在模拟异常。这个模块让我明白,可靠性不是“正常情况能跑”,而是“异常情况不扩大损失”。
7.5 张陈雨菲 @Diox4n3:小模块也要有清晰的边界
add_record.py 只有几十行,但它把校验、读取、追加、保存串成一条链。一开始我想在函数里直接 open() JSON,后来按规范改成只调用 models / storage,并加锁避免并发丢记录。接口小、责任清楚,反而更容易测试,也更容易被 app.py 复用。现场编程让我体会到“少做一点、做对一点”的价值。
7.6 林鑫 @Yi-shang0101:排序规则要写进测试,而不是留在脑子里
最近记录要按 date 倒序、同一天按 created_at 倒序。created_at 可能带不同时区偏移,不能直接比字符串;用 datetime.fromisoformat 统一后再排序。我的模块被覆盖过一次,PR #11 只恢复这一个文件,让我体会到小步提交和测试的价值:只要测试还在,恢复就有依据。
7.7 卢志勇 @209691048:多条件筛选的难点是“空值”和“边界”
我负责 filter_records.py。难点是 None 表示“不限”与金额 0 的区别、日期/金额区间要含边界、开始时间晚于结束时间要报错。用列表推导把六个条件写成 AND,再用 sorted 统一排序;测试覆盖了边界、非法区间和空结果。写完之后我更理解“接口文档里的每一句话都要有测试对应”。
7.8 张楠 @fenhaozi1:统计口径必须只有一套
统计模块最初叫 statistics.py,和 Python 标准库同名,导入时踩了坑;后来拆成 account_statistics.py + 兼容门面 statistics.py。用 Decimal 累加、最后 round 两位,避免 0.1 + 0.2 的浮点误差;分类汇总只统计指定 type。这件事让我记住:统计模块最重要的不是“算得快”,而是“所有人算出来一样”。
7.9 刘俊延 @52HzWhale111:图表只做展示,口径必须复用
图表模块只做展示,统计口径必须复用 account_statistics,不能自己再算一遍。空数据、只有收入、只有支出三种状态都要不报错;收入/支出用固定颜色,分类图按金额降序,并保留数据表方便读屏。Altair 的细节比想象中多,但也让我体会到“可视化不是画得漂亮,而是让数据可读”。
7.10 陈烨婷 @chen-yeling:修改/删除要有白名单和确认
修改/删除的关键是只允许改 date/type/amount/category/note,id 和 created_at 不能动;更新时先合并再整体 validate,找不到返回 False。删除要二次确认,界面和业务分开。PR 里的测试还在开放状态,是我后续要补的功课;但这次现场编程让我学会了“先定允许改什么,再写怎么改”。
8. GitHub 仓库地址与commit记录
- 仓库地址:https://github.com/platforzation/20261107-personal-account-book
- Releases 页面:https://github.com/platforzation/20261107-personal-account-book/releases
- commit记录:https://github.com/platforzation/20261107-personal-account-book/commits/main/
9. 团队 PSP 过程数据
| PSP | 阶段 | 预估耗时(分钟) | 实际耗时(分钟) |
|---|---|---|---|
| Estimate | 估计任务时间与分工 | 10 | 8 |
| Analysis | 需求分析 | 8 | 8 |
| Design Spec | 生成设计文档 | 8 | 7 |
| Design Review | 设计复审 | 5 | 6 |
| Coding Standard | 代码规范 | 5 | 5 |
| Design | 具体设计 | 10 | 10 |
| Coding | 具体编码 | 55 | 70 |
| Code Review | 代码复审 | 10 | 10 |
| Test | 测试 | 14 | 16 |
| Test Report | 测试报告 | 5 | 5 |
| Size Measurement | 计算工作量 | 5 | 5 |
| Postmortem & Process Improvement Plan | 事后总结,并提出过程改进计划 | 15 | 30 |
| 合计 | 150 | 180 |
实际比预估多 30 分钟(约 20%):主要来自 UI 两次返工与覆盖事故后的恢复(Coding +15 分钟)、补测(Test +2 分钟)以及复盘/博客整理(Postmortem +15 分钟);需求分析和设计文档环节略有节省。
10. 复盘:如果再做一次
做得好的
- 接口先行:10 个人能并行开发,靠的是字段和函数签名先定死;
- 测试不是装饰:72 项测试在两次覆盖事故中帮助我们快速判断“丢了什么”;
- 数据安全:原子写入、损坏保护、锁,都是课程项目里容易被忽略但很重要的工程细节;
- 可演示优先:UI 返工没有破坏新增、筛选、编辑、导出这些核心操作。
还可以更好的
- 分支保护:如果
main开启“禁止直接 push / 必须 PR + 测试通过”,15:35 的覆盖事故可以避免; - 接口收口:
add_record.py复用了storage._RECORDS_LOCK私有变量,后续应由 storage 暴露事务接口;
一句话总结:三个小时里,我们把一个“能记一笔”的课堂作业,做成了有校验、有锁、有测试、有图表、能导出、能演示的本地记账应用;也第一次真切体会到,团队协作里最贵的不是写代码,而是让别人的代码和你的代码安全地合在一起。

 浙公网安备 33010602011771号