
5.RDD操作综合实例
一、词频统计
A. 分步骤实现
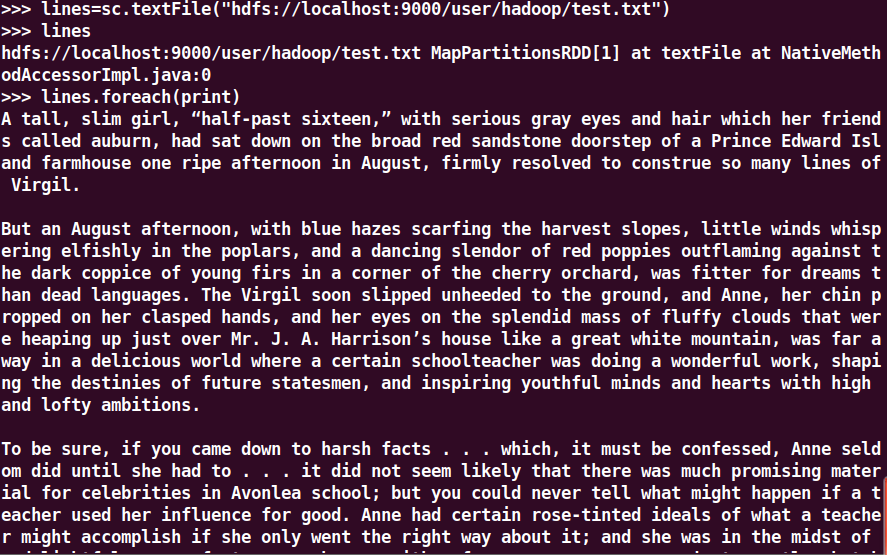
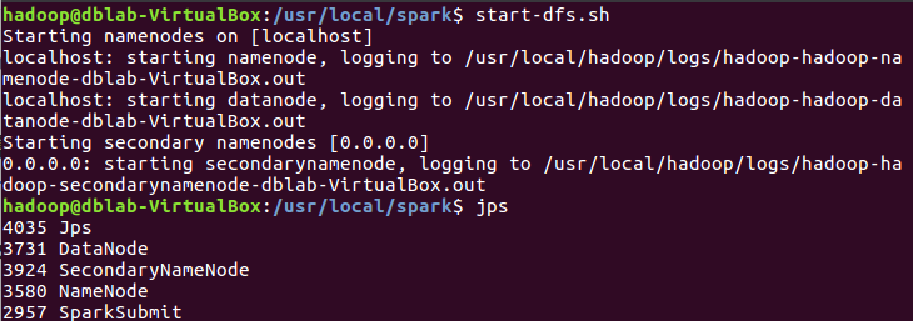
准备文件
- 下载小说或长篇新闻稿
![]()
![]()
-
![]()
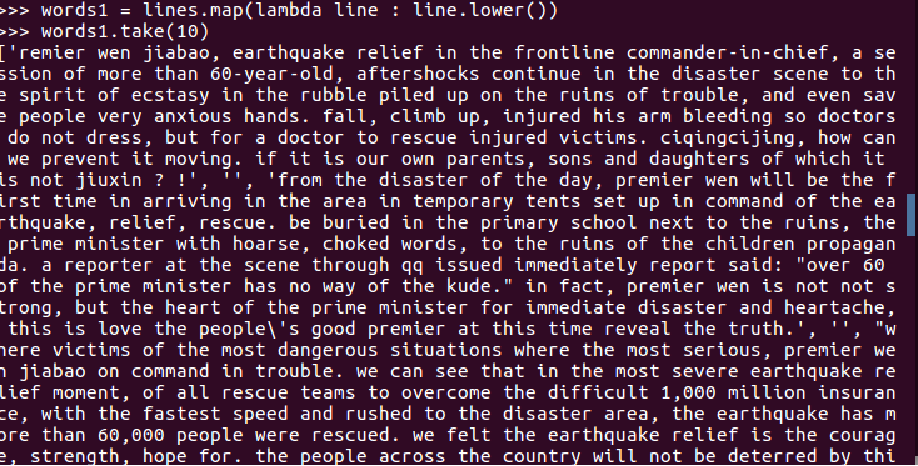
4.排除大小写lower(),map()
![]()
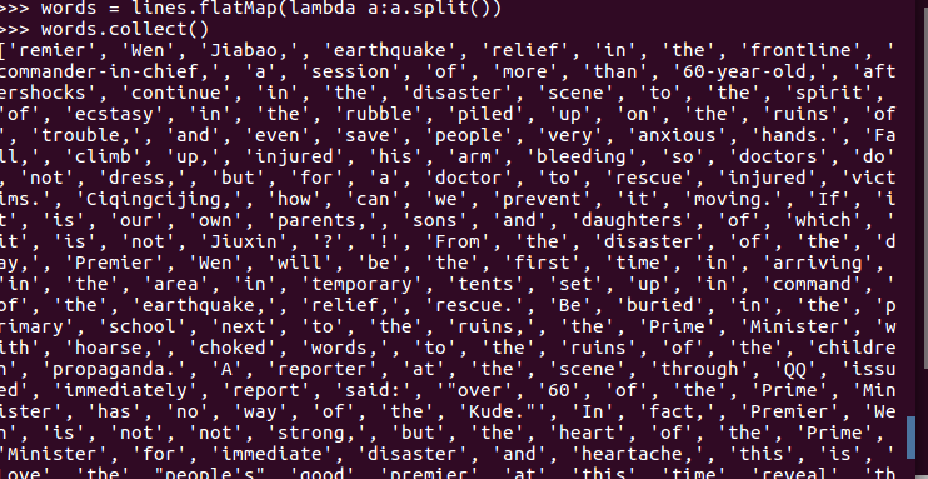
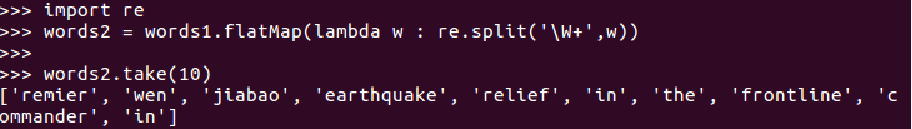
标点符号re.split(pattern,str),flatMap(),
![]()
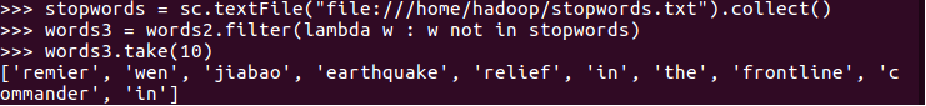
停用词,可网盘下载stopwords.txt,filter(),
![]()
长度小于2的词filter()
![]()
统计词频
![]()
![]()
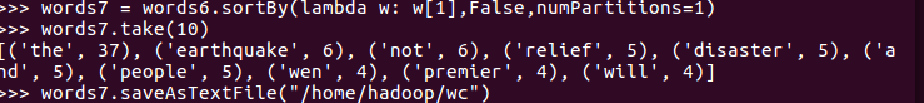
6.按词频排序![]()
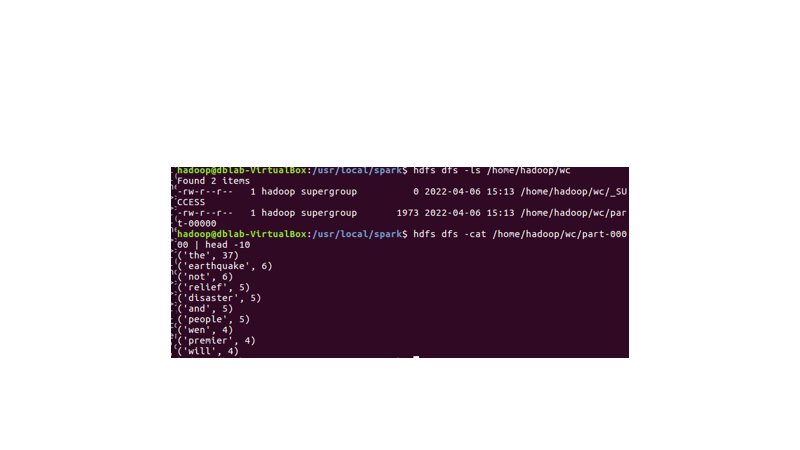
- .输出到文件
![]()
B. 一句话实现:文件入文件出
-
1
lines=sc.textFile("hdfs://localhost:9000/user/hadoop/test.txt").flatMap(lambdaline: line.split()).flatMap(lambdaline: re.split(r'\W', line)).flatMap(lambdaline: line.split()).map(lambdaword: word.lower()).filter(lambdax: xnotinstopwords).filter(lambdax:len(x) >2).map(lambdaa: (a,1)).reduceByKey(lambdaa, b: a+b).sortBy(lambdax: x[1],False) -
.和作业2的“二、Python编程练习:英文文本的词频统计 ”进行比较,理解Spark编程的特点。
Spark运行速度快、易用性好、通用性强和随处运行。
- 二、求Top值
-
![]()




 浙公网安备 33010602011771号