实验三:朴素贝叶斯算法实验
【实验目的】
理解朴素贝叶斯算法原理,掌握朴素贝叶斯算法框架。
【实验内容】
针对下表中的数据,编写python程序实现朴素贝叶斯算法(不使用sklearn包),对输入数据进行预测;
熟悉sklearn库中的朴素贝叶斯算法,使用sklearn包编写朴素贝叶斯算法程序,对输入数据进行预测;
【实验报告要求】
对照实验内容,撰写实验过程、算法及测试结果;
代码规范化:命名规则、注释;
查阅文献,讨论朴素贝叶斯算法的应用场景。
| 色泽 | 根蒂 | 敲声 | 纹理 | 脐部 | 触感 | 好瓜 |
| 青绿 | 蜷缩 | 浊响 | 清晰 | 凹陷 | 碍滑 | 是 |
| 乌黑 | 蜷缩 | 沉闷 | 清晰 | 凹陷 | 碍滑 | 是 |
| 乌黑 | 蜷缩 | 浊响 | 清晰 | 凹陷 | 碍滑 | 是 |
| 青绿 | 蜷缩 | 沉闷 | 清晰 | 凹陷 | 碍滑 | 是 |
| 浅白 | 蜷缩 | 浊响 | 清晰 | 凹陷 | 碍滑 | 是 |
| 青绿 | 稍蜷 | 浊响 | 清晰 | 稍凹 | 软粘 | 是 |
| 乌黑 | 稍蜷 | 浊响 | 稍糊 | 稍凹 | 软粘 | 是 |
| 乌黑 | 稍蜷 | 浊响 | 清晰 | 稍凹 | 硬滑 | 是 |
| 乌黑 | 稍蜷 | 沉闷 | 稍糊 | 稍凹 | 硬滑 | 否 |
| 青绿 | 硬挺 | 清脆 | 清晰 | 平坦 | 软粘 | 否 |
| 浅白 | 硬挺 | 清脆 | 模糊 | 平坦 | 硬滑 | 否 |
| 浅白 | 蜷缩 | 浊响 | 模糊 | 平坦 | 软粘 | 否 |
| 青绿 | 稍蜷 | 浊响 | 稍糊 | 凹陷 | 硬滑 | 否 |
| 浅白 | 稍蜷 | 沉闷 | 稍糊 | 凹陷 | 硬滑 | 否 |
| 乌黑 | 稍蜷 | 浊响 | 清晰 | 稍凹 | 软粘 | 否 |
| 浅白 | 蜷缩 | 浊响 | 模糊 | 平坦 | 硬滑 | 否 |
| 青绿 | 蜷缩 | 沉闷 | 稍糊 | 稍凹 | 硬滑 | 否 |
一、针对下表中的数据,编写python程序实现朴素贝叶斯算法(不使用sklearn包),对输入数据进行预测;
1.创建数据
#输入数据集
data_list=[['青绿','蜷缩','浊响','清晰','凹陷','碍滑','是'],
      ['乌黑','蜷缩','沉闷','清晰','凹陷','碍滑','是'],
      ['乌黑','蜷缩','浊响','清晰','凹陷','碍滑','是'],
      ['青绿','蜷缩','沉闷','清晰','凹陷','碍滑','是'],
      ['浅白','蜷缩','浊响','清晰','凹陷','碍滑','是'],
      ['青绿','稍蜷','浊响','清晰','稍凹','软粘','是'],
      ['乌黑','稍蜷','浊响','稍糊','稍凹','软粘','是'],
      ['乌黑','稍蜷','浊响','清晰','稍凹','硬滑','是'],
      ['乌黑','稍蜷','沉闷','稍糊','稍凹','硬滑','否'],
      ['青绿','硬挺','清脆','清晰','平坦','软粘','否'],
      ['浅白','硬挺','清脆','模糊','平坦','硬滑','否'],
      ['浅白','蜷缩','浊响','模糊','平坦','软粘','否'],
      ['青绿','稍蜷','浊响','稍糊','凹陷','硬滑','否'],
      ['浅白','稍蜷','沉闷','稍糊','凹陷','硬滑','否'],
      ['乌黑','稍蜷','浊响','清晰','稍凹','软粘','否'],
      ['浅白','蜷缩','浊响','模糊','平坦','硬滑','否'],
      ['青绿','蜷缩','沉闷','稍糊','稍凹','硬滑','否']
     ]
#数据集标签特征
labels=['色泽','根蒂','敲声','纹理','脐部','触感','好瓜']
import pandas as pd
#将数据集转换为DataFrame数据
dataframe=pd.DataFrame(data_list,columns=labels)
2,算法实现
import pandas as pd
import numpy  as np

class NaiveBayes:
    def __init__(self):
        self.model = {}#key 为类别名 val 为字典PClass表示该类的该类,PFeature:{}对应对于各个特征的概率
    def calEntropy(self, y): # 计算熵
        valRate = y.value_counts().apply(lambda x : x / y.size) # 频次汇总 得到各个特征对应的概率
        valEntropy = np.inner(valRate, np.log2(valRate)) * -1
        return valEntropy

    def fit(self, xTrain, yTrain = pd.Series()):
        if not yTrain.empty:#如果不传,自动选择最后一列作为分类标签
            xTrain = pd.concat([xTrain, yTrain], axis=1)
        self.model = self.buildNaiveBayes(xTrain)
        return self.model
    def buildNaiveBayes(self, xTrain):
        yTrain = xTrain.iloc[:,-1]

        yTrainCounts = yTrain.value_counts()# 频次汇总 得到各个特征对应的概率

        yTrainCounts = yTrainCounts.apply(lambda x : (x + 1) / (yTrain.size + yTrainCounts.size)) #使用了拉普拉斯平滑
        retModel = {}
        for nameClass, val in yTrainCounts.items():
            retModel[nameClass] = {'PClass': val, 'PFeature':{}}

        propNamesAll = xTrain.columns[:-1]
        allPropByFeature = {}
        for nameFeature in propNamesAll:
            allPropByFeature[nameFeature] = list(xTrain[nameFeature].value_counts().index)
        #print(allPropByFeature)
        for nameClass, group in xTrain.groupby(xTrain.columns[-1]):
            for nameFeature in propNamesAll:
                eachClassPFeature = {}
                propDatas = group[nameFeature]
                propClassSummary = propDatas.value_counts()# 频次汇总 得到各个特征对应的概率
                for propName in allPropByFeature[nameFeature]:
                    if not propClassSummary.get(propName):
                        propClassSummary[propName] = 0#如果有属性灭有,那么自动补0
                Ni = len(allPropByFeature[nameFeature])
                propClassSummary = propClassSummary.apply(lambda x : (x + 1) / (propDatas.size + Ni))#使用了拉普拉斯平滑
                for nameFeatureProp, valP in propClassSummary.items():
                    eachClassPFeature[nameFeatureProp] = valP
                retModel[nameClass]['PFeature'][nameFeature] = eachClassPFeature

        return retModel
    def predictBySeries(self, data):
        curMaxRate = None
        curClassSelect = None
        for nameClass, infoModel in self.model.items():
            rate = 0
            rate += np.log(infoModel['PClass'])
            PFeature = infoModel['PFeature']

            for nameFeature, val in data.items():
                propsRate = PFeature.get(nameFeature)
                if not propsRate:
                    continue
                rate += np.log(propsRate.get(val, 0))#使用log加法避免很小的小数连续乘,接近零
                #print(nameFeature, val, propsRate.get(val, 0))
            #print(nameClass, rate)
            if curMaxRate == None or rate > curMaxRate:
                curMaxRate = rate
                curClassSelect = nameClass

        return curClassSelect
    def predict(self, data):
        if isinstance(data, pd.Series):
            return self.predictBySeries(data)
        return data.apply(lambda d: self.predictBySeries(d), axis=1)

dataTrain = pd.read_csv('D:\\机器学习\数据\data_word.csv')
naiveBayes = NaiveBayes()
treeData = naiveBayes.fit(dataTrain)

import json
print(json.dumps(treeData, ensure_ascii=False))

pd = pd.DataFrame({'预测值':naiveBayes.predict(dataTrain), '正取值':dataTrain.iloc[:,-1]})
print(pd)
print('正确率:%f%%'%(pd[pd['预测值'] == pd['正取值']].shape[0] * 100.0 / pd.shape[0]))

二、熟悉sklearn库中的朴素贝叶斯算法,使用sklearn包编写朴素贝叶斯算法程序,对输入数据进行预测;
from sklearn.model_selection import train_test_split
from sklearn.naive_bayes import GaussianNB
from sklearn.model_selection import train_test_split
import numpy as np
data_list = [#青绿 0 乌黑 1 浅白 2  蜷缩 0 稍缩 1  硬挺 2 浊响 0 沉闷 1 清脆 2 清晰 0 稍糊 1 模糊 2 平坦 0 稍凹 1 凹陷 2 碍滑 0 软粘 1 硬滑 2
        [0, 0, 0, 0, 2, 0, 1],
        [1, 0, 1, 0, 2, 0, 1],
        [1, 0, 0, 0, 2, 0, 1],
        [0, 0, 1, 0, 2, 0, 1],
        [2, 0, 0, 0, 2, 0, 1],
        [0, 1, 0, 0, 1, 1, 1],
        [1, 1, 0, 0, 1, 1, 1],
        [1, 1, 0, 0, 1, 2, 1],
        [1, 1, 1, 1, 1, 2, 0],
        [0, 2, 2, 0, 0, 1, 0],
        [2, 2, 2, 2, 0, 2, 0],
        [2, 0, 0, 2, 0, 1, 0],
        [0, 1, 0, 1, 2, 2, 0],
        [2, 1, 1, 1, 2, 2, 0],
        [1, 1, 0, 0, 1, 1, 0],
        [2, 0, 0, 2, 1, 2, 0],
        [0, 0, 1, 1, 1, 2, 0]
        ]
target = np.array([0,1,2,3,4,5,6],dtype='float32')
data = np.array(data_list,dtype='float32')
x_train,x_test,y_train,y_test = train_test_split(data.T,target,random_state=1)   #按比例分割数据
nb_clf = GaussianNB() #实例化模型
nb_clf.fit(x_train,y_train)  #模型训练
a=nb_clf.predict(x_test)    #预测
acc_score = nb_clf.score(x_test,y_test)   #查看模型分数

三.公式补充
条件概率公式,是指在事件B发生的情况下,事件A发生的概率,用来表示。
概率为: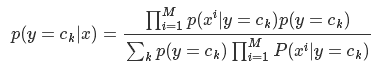

 浙公网安备 33010602011771号