
【大模型Wiki】08 · OpenAI API 应用文档
相关链接:https://platform.openai.com/docs/introduction
1、简介
OpenAI API 几乎可以应用于任何任务。 我们提供一系列具有不同功能和价位的模型,并且能够微调定制模型。
api-reference:https://platform.openai.com/docs/api-reference/introduction
1.1、关键概念
1.1.1、Text generation models
OpenAI 的文本生成模型(通常称为生成预训练 Transformer 或简称“GPT”模型),如 GPT-4 和 GPT-3.5,已经过训练来理解自然和形式语言。 像 GPT-4 这样的模型允许文本输出来响应其输入。 这些模型的输入也称为“提示”。 设计提示本质上是如何“编程”GPT-4 等模型,通常是通过提供说明或一些如何成功完成任务的示例。 GPT-4 等模型可用于多种任务,包括内容或代码生成、摘要、对话、创意写作等。 请阅读我们的介绍性文本生成指南和提示工程指南来了解更多信息。
1.1.2、Assistants
Assistants是指实体,在 OpenAI API 的情况下,它们由 GPT-4 等大型语言模型提供支持,能够为用户执行任务。 这些Assistants根据模型上下文窗口中嵌入的指令进行操作。 他们通常还可以使用允许Assistants执行更复杂任务的工具,例如运行代码或从文件中检索信息。 在我们的 Assistants API 概述中了解有关助手的更多信息。
1.1.3、embedding
embedding是一段数据(例如某些文本)的矢量表示,旨在保留其内容和/或其含义的各个方面。 在某些方面相似的数据块往往比不相关的数据具有更紧密的嵌入。 OpenAI 提供文本嵌入模型,该模型将文本字符串作为输入并生成嵌入向量作为输出。 嵌入对于搜索、聚类、推荐、异常检测、分类等非常有用。 在我们的嵌入指南中阅读有关嵌入的更多信息。
2、快速开始
OpenAI API 为开发人员提供了一个简单的界面,可在其应用程序中创建智能层,并由 OpenAI 最先进的模型提供支持。 Chat Completions 端点为 ChatGPT 提供支持,并提供了一种简单的方法来将文本作为输入并使用 GPT-4 等模型来生成输出。
- 如何设置您的开发环境
- 如何安装最新的 SDK
- OpenAI API 的一些基本概念
- 如何发送您的第一个 API 请求
- 如果您在入门时遇到任何挑战或有疑问,请加入我们的开发者论坛。
2.1、curl
curl https://api.openai.com/v1/chat/completions   -H "Content-Type: application/json"   -H "Authorization: Bearer $OPENAI_API_KEY"   -d '{
    "model": "gpt-3.5-turbo",
    "messages": [
      {
        "role": "system",
        "content": "You are a poetic assistant, skilled in explaining complex programming concepts with creative flair."
      },
      {
        "role": "user",
        "content": "Compose a poem that explains the concept of recursion in programming."
      }
    ]
  }'
2.2、python
from openai import OpenAI
client = OpenAI()

completion = client.chat.completions.create(
  model="gpt-3.5-turbo",
  messages=[
    {"role": "system", "content": "You are a poetic assistant, skilled in explaining complex programming concepts with creative flair."},
    {"role": "user", "content": "Compose a poem that explains the concept of recursion in programming."}
  ]
)

print(completion.choices[0].message)
2026 提示:新版 SDK 推荐用
from openai import OpenAI的客户端写法。环境变量OPENAI_API_KEY配好后,OpenAI()自动读取,无需手动传 key。国内访问可设base_url指向兼容代理。
3、model
https://platform.openai.com/docs/models
| MODELmodel | DESCRIPTIONdescription |
|---|---|
| GPT-4 Turbo and GPT-4 | 一组改进 GPT-3.5 的模型,可以理解并生成自然语言或代码 |
| GPT-3.5 Turbo | 一组改进 GPT-3.5 的模型,可以理解并生成自然语言或代码 |
| DALL·E | 可以在自然语言提示下生成和编辑图像的模型 |
| TTS | 一组可以将文本转换为听起来自然的语音的模型 |
| Whisper | 可以将音频转换为文本的模型 |
| Embeddings | 一组可以将文本转换为数字形式的模型 |
| Moderation | 可以检测文本是否敏感或不安全的微调模型 |
3.1、模型命名规律与选型(2026 补充)
gpt-4o/gpt-4o-mini:多模态旗舰与轻量版,性价比高,默认推荐。gpt-4-turbo:长上下文(128k)版本。o1/o3系列:推理模型,思考链内置,按"推理 token"计费,适合数学/代码/规划,不要给它加temperature之外的采样扰动。- 本地模型(见 07 篇)通过 vLLM/Ollama 暴露的
/v1也能用同一套 SDK 调用,把base_url改成本地地址、api_key="EMPTY"即可。
4、能力
4.1、文本生成
OpenAI 的文本生成模型(通常称为生成式预训练 Transformer 或大型语言模型)经过训练可以理解自然语言、代码和图像。 这些模型提供文本输出来响应其输入。 这些模型的输入也称为“提示”。 设计提示本质上是如何“编程”大型语言模型,通常是通过提供说明或一些如何成功完成任务的示例。
例子:
curl https://api.openai.com/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-3.5-turbo",
    "messages": [
      {
        "role": "system",
        "content": "You are a helpful assistant."
      },
      {
        "role": "user",
        "content": "Who won the world series in 2020?"
      },
      {
        "role": "assistant",
        "content": "The Los Angeles Dodgers won the World Series in 2020."
      },
      {
        "role": "user",
        "content": "Where was it played?"
      }
    ]
  }'
这里的
messages数组是"多轮上下文":把上一轮的assistant回复原样放回,模型就能基于历史继续。注意不要把assistant的内容省略,否则模型会"失忆"。role支持system(设定人设/规则)、user、assistant、以及视觉模型用的tool/function。
4.2、函数调用
在 API 调用中,您可以描述函数,并让模型智能地选择输出包含调用一个或多个函数的参数的 JSON 对象。 聊天完成 API 不会调用该函数; 相反,模型会生成 JSON,您可以使用它来调用代码中的函数。
最新模型(gpt-3.5-turbo-0125 和 gpt-4-turbo-preview)经过训练,可以检测何时应调用函数(取决于输入)并使用符合函数签名的 JSON 进行响应 比以前的型号更接近。 这种能力也带来了潜在的风险。
4.2.1、例子
1、调用OpenAI的API时,需要增加functions参数,这个参数是json格式字符串

2、OpenAI会返回一个Json字符串告诉你调用哪个函数,参数是什么。

3、调用第三方接口,使用模型响应调用您的API
curl https://weatherapi.com/...
响应:
{ "temperature": 22, "unit": "celsius", "description": "Sunny" }
4、将响应结果发送给OpenAI进行总结

5、openai进行总结

4.3、Embeddings
curl https://api.openai.com/v1/embeddings \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "input": "The food was delicious and the waiter...",
    "model": "text-embedding-ada-002",
    "encoding_format": "float"
  }'
{
  "object": "list",
  "data": [
    {
      "object": "embedding",
      "embedding": [
        0.0023064255,
        -0.009327292,
        .... (1536 floats total for ada-002)
        -0.0028842222,
      ],
      "index": 0
    }
  ],
  "model": "text-embedding-ada-002",
  "usage": {
    "prompt_tokens": 8,
    "total_tokens": 8
  }
}
4.4、微调
https://platform.openai.com/docs/guides/fine-tuning
微调可让您通过 API 提供以下功能,从而更充分地利用可用模型:
比提示更高质量的结果,能够训练超出提示范围的示例,由于提示较短而节省了代币,更低的延迟请求
OpenAI 的文本生成模型已经过大量文本的预训练。 为了有效地使用模型,我们在提示中包含说明,有时还包含几个示例。 使用演示来展示如何执行任务通常称为“小样本学习”。微调通过训练超出提示范围的更多示例来改进小样本学习,让您在大量任务上取得更好的结果。 一旦模型经过微调,您就不需要在提示中提供那么多示例。 这可以节省成本并实现更低延迟的请求。
在较高层面上,微调涉及以下步骤:
- 准备并上传训练数据
- 训练新的微调模型
- 评估结果并根据需要返回步骤 1
- 使用微调模型
微调数据的格式这里就不列举了
4.5、Image generation
Images API 提供了三种与图像交互的方法:
- 根据文本提示从头开始创建图像(DALL·E 3 和 DALL·E 2)
- 根据新的文本提示,通过让模型替换预先存在的图像的某些区域来创建图像的编辑版本(仅限 DALL·E 2)
- 创建现有图像的变体(仅限 DALL·E 2)
4.5.1、生成示例DALL·E 3
curl https://api.openai.com/v1/images/generations \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "dall-e-3",
    "prompt": "a white siamese cat",
    "n": 1,
    "size": "1024x1024"
  }'
from openai import OpenAI
client = OpenAI()

response = client.images.generate(
  model="dall-e-3",
  prompt="a white siamese cat",
  size="1024x1024",
  quality="standard",
  n=1,
)

image_url = response.data[0].url
| PROMPT | GENERATION |
|---|---|
| A photograph of a white Siamese cat. | 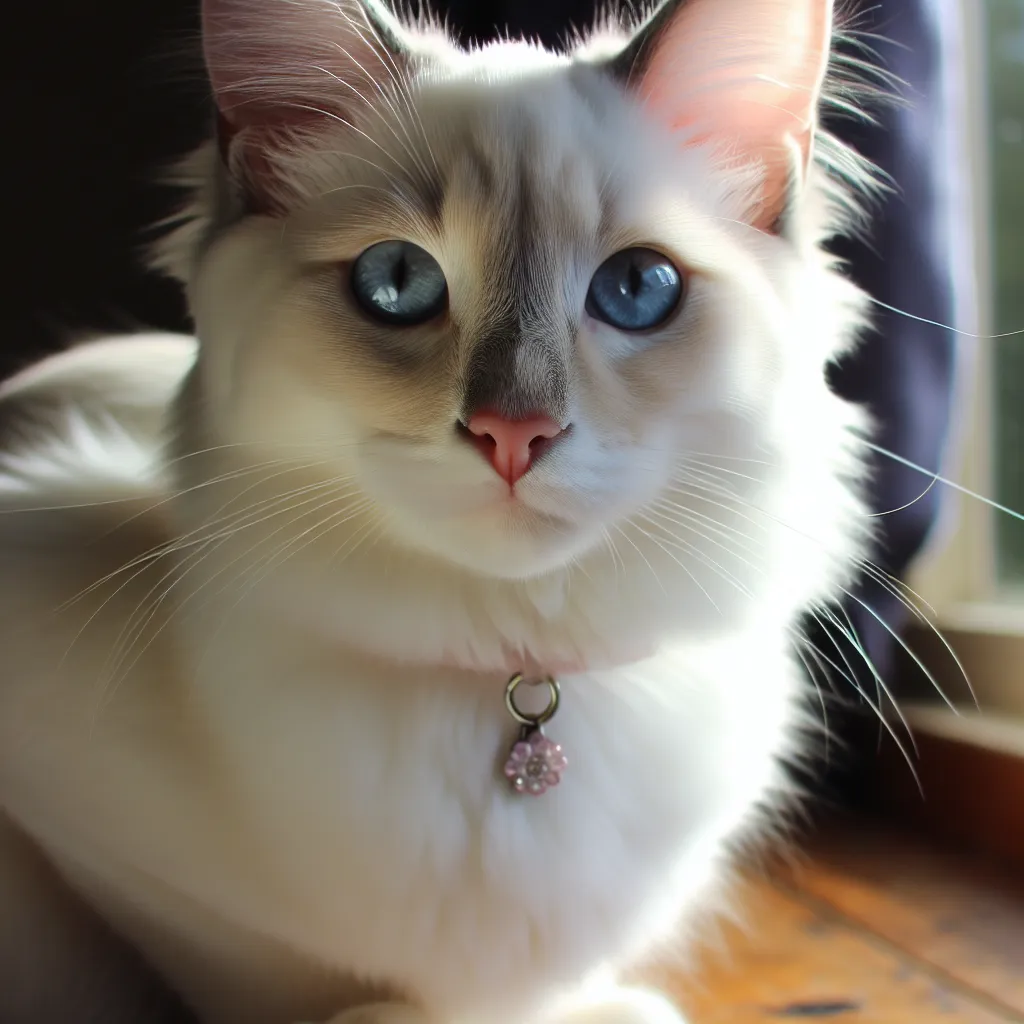 |
使用response_format 参数,每个图像都可以作为 URL 或 Base64 数据返回。 URL 将在一小时后过期。
4.5.2、edit图像编辑
图像编辑端点也称为“修复”,允许您通过上传图像和指示应替换哪些区域的蒙版来编辑或扩展图像。 蒙版的透明区域指示应编辑图像的位置,并且提示应描述完整的新图像,而不仅仅是擦除的区域。 此端点可以实现类似于我们 DALL·E 预览应用程序中的编辑器的体验。
curl https://api.openai.com/v1/images/edits \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -F model="dall-e-2" \
  -F image="@sunlit_lounge.png" \
  -F mask="@mask.png" \
  -F prompt="A sunlit indoor lounge area with a pool containing a flamingo" \
  -F n=1 \
  -F size="1024x1024"
from openai import OpenAI
client = OpenAI()

response = client.images.edit((
  model="dall-e-2",
  image=open("sunlit_lounge.png", "rb"),
  mask=open("mask.png", "rb"),
  prompt="A sunlit indoor lounge area with a pool containing a flamingo",
  n=1,
  size="1024x1024"
)
image_url = response.data[0].url

上传的图像和蒙版必须都是size<4MB的方形PNG图像,并且尺寸必须相同。 生成输出时不会使用遮罩的非透明区域,因此它们不一定需要像上面的示例一样与原始图像匹配。
4.5.3、variation变体(仅限 DALL·E 2)
图像变体端点允许您生成给定图像的变体。
curl https://api.openai.com/v1/images/variations \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -F model="dall-e-2" \
  -F image="@corgi_and_cat_paw.png" \
  -F n=1 \
  -F size="1024x1024"
from openai import OpenAI
client = OpenAI()

response = client.images.create_variation(
  model="dall-e-2",
  image=open("corgi_and_cat_paw.png", "rb"),
  n=1,
  size="1024x1024"
)

image_url = response.data[0].url

4.5.4、使用内存中的图像数据
上面指南中的 Python 示例使用 open 函数从磁盘读取图像数据。 在某些情况下,您可能会将图像数据存储在内存中。 以下是使用存储在 BytesIO 对象中的图像数据的 API 调用示例:
from io import BytesIO
from openai import OpenAI
client = OpenAI()

# This is the BytesIO object that contains your image data
byte_stream: BytesIO = [your image data]
byte_array = byte_stream.getvalue()
response = client.images.create_variation(
  image=byte_array,
  n=1,
  model="dall-e-2",
  size="1024x1024"
)
4.6、图片识别
Learn how to use GPT-4 to understand images
图像可通过两种主要方式提供给模型:传递图像的链接或直接在请求中传递 base64 编码的图像。 图像可以在用户、系统和助理消息中传递。 目前我们不支持第一条系统消息中的图像,但将来可能会改变。
curl https://api.openai.com/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-4-turbo",
    "messages": [
      {
        "role": "user",
        "content": [
          {
            "type": "text",
            "text": "What’s in this image?"
          },
          {
            "type": "image_url",
            "image_url": {
              "url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg"
            }
          }
        ]
      }
    ],
    "max_tokens": 300
  }'
import base64
import requests

# OpenAI API Key
api_key = "YOUR_OPENAI_API_KEY"

# Function to encode the image
def encode_image(image_path):
  with open(image_path, "rb") as image_file:
    return base64.b64encode(image_file.read()).decode('utf-8')

# Path to your image
image_path = "path_to_your_image.jpg"

# Getting the base64 string
base64_image = encode_image(image_path)

headers = {
  "Content-Type": "application/json",
  "Authorization": f"Bearer {api_key}"
}

payload = {
  "model": "gpt-4-turbo",
  "messages": [
    {
      "role": "user",
      "content": [
        {
          "type": "text",
          "text": "What’s in this image?"
        },
        {
          "type": "image_url",
          "image_url": {
            "url": f"data:image/jpeg;base64,{base64_image}"
          }
        }
      ]
    }
  ],
  "max_tokens": 300
}

response = requests.post("https://api.openai.com/v1/chat/completions", headers=headers, json=payload)

print(response.json())
4.6.1、多图片识别
curl https://api.openai.com/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-4-turbo",
    "messages": [
      {
        "role": "user",
        "content": [
          {
            "type": "text",
            "text": "What are in these images? Is there any difference between them?"
          },
          {
            "type": "image_url",
            "image_url": {
              "url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            }
          },
          {
            "type": "image_url",
            "image_url": {
              "url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
            }
          }
        ]
      }
    ],
    "max_tokens": 300
  }'
4.6.2、细节
通过控制细节参数(具有低、高或自动三个选项),您可以控制模型如何处理图像并生成其文本理解。 默认情况下,模型将使用自动设置,该设置将查看图像输入尺寸并决定是否应使用低设置或高设置。
low 将启用“低分辨率”模式。 该模型将收到图像的低分辨率 512px x 512px 版本,并以 65 个代币的预算表示该图像。 这使得 API 能够返回更快的响应,并在不需要高细节的用例中消耗更少的输入令牌。
high 将启用“高分辨率”模式,该模式首先允许模型查看低分辨率图像,然后根据输入图像大小将输入图像创建为 512 像素正方形的详细裁剪。 每个详细作物使用两倍的代币预算(65 个代币),总共 129 个代币。
curl https://api.openai.com/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-4-turbo",
    "messages": [
      {
        "role": "user",
        "content": [
          {
            "type": "text",
            "text": "What’s in this image?"
          },
          {
            "type": "image_url",
            "image_url": {
              "url": "https://upload.wikimedia.org/wikipedia/commons/thumb/d/dd/Gfp-wisconsin-madison-the-nature-boardwalk.jpg/2560px-Gfp-wisconsin-madison-the-nature-boardwalk.jpg",
              "detail": "high"
            }
          }
        ]
      }
    ],
    "max_tokens": 300
  }'
4.7、Text to speech
了解如何将文本转换为逼真的语音
curl https://api.openai.com/v1/audio/speech \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "tts-1",
    "input": "Today is a wonderful day to build something people love!",
    "voice": "alloy"
  }' \
  --output speech.mp3
4.8、speech to text
from openai import OpenAI
client = OpenAI()

audio_file= open("/path/to/file/audio.mp3", "rb")
transcription = client.audio.transcriptions.create(
  model="whisper-1",
  file=audio_file
)
print(transcription.text)
5、Chat Completions 全参数详解(重点)
/v1/chat/completions 是日常用得最多的端点。下面把核心参数逐个讲透,参数组合直接影响"像不像人、贵不贵、稳不稳"。
5.1、请求体核心参数表
| 参数 | 类型 | 默认值 | 作用 |
|---|---|---|---|
model |
str | 必填 | 模型名,如 gpt-4o |
messages |
list | 必填 | 对话历史,含 system/user/assistant/tool |
temperature |
float | 1.0 | 采样随机性(0 最确定,2 最发散) |
top_p |
float | 1.0 | 核采样,按累积概率截断候选词 |
max_tokens |
int | ∞(模型上限) | 单次最多新生成 token 数 |
n |
int | 1 | 一次返回几条候选 |
stop |
str/list | null | 遇到这些串即停止生成 |
presence_penalty |
float | 0 | 惩罚"已出现过的话题",鼓励新话题 |
frequency_penalty |
float | 0 | 惩罚"重复出现的词",抑制复读 |
logit_bias |
map | null | 手动抬升/压低特定 token 概率 |
seed |
int | null | 固定随机种子,提升可复现性 |
response_format |
obj | null | {"type":"json_object"} 强制 JSON 输出 |
tools / tool_choice |
list/str | null | 函数调用(见第 7 节) |
stream |
bool | false | 是否流式返回(见第 6 节) |
user |
str | null | 终端用户标识,用于安全/审计 |
5.2、temperature 与 top_p:控制"创造性"
两者都控制随机性,但机制不同,OpenAI 建议二选一调,不要同时大幅改动:
temperature:对 softmax 后的概率分布做温度缩放。0 → 几乎总是选概率最高的词(确定、死板);1 → 标准分布;>1 → 拉平分布,更发散、更容易胡说。top_p(核采样):只从"累计概率达到 p 的最小词集合"里采样。比如top_p=0.9表示只在前 90% 概率质量的词里选。p 越小越保守。
经验取值:
- 代码生成、事实问答、抽取:0~0.3
- 通用聊天、摘要:0.7
- 诗歌/创意写作:0.9~1.2
# 代码场景:低温保证稳定
client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "user", "content": "写一个快速排序"}],
    temperature=0.2,
)
5.3、max_tokens:别让输出被截断
max_tokens 限制的是新生成的 token,不包含输入。设太小会导致回答"戛然而止"。注意:
- 总上下文 = 输入 tokens + 输出 tokens ≤ 模型窗口(如 128k)。
- 设太大不会多花钱,只预留上限;但若同时输入很长,可能触发
max_context_length_exceeded。 - 推理模型(o 系列)的"思考 token"也计入,可能很贵。
5.4、presence_penalty 与 frequency_penalty:抑制复读
frequency_penalty:某词出现越多,越不想再出现——直接治"车轱辘话"。presence_penalty:只要出现过就降权——鼓励引入新主题,适合多轮不跑题。- 取值一般 0~1(也可到 2,但过大会语句破碎)。长文本生成设 0.5~1 明显缓解重复。
5.5、stop / seed / response_format
# stop:生成到 "###" 就停(常用于把模型当"填空器")
client.chat.completions.create(model="gpt-4o", messages=[...], stop=["###"])

# seed + temperature=0:尽量可复现(注意并发/缓存下仍可能微调差异)
client.chat.completions.create(model="gpt-4o", messages=[...], temperature=0, seed=42)

# response_format=json_object:强制返回合法 JSON(务必在 prompt 里说明要什么字段)
client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "system",
               "content": '只输出 JSON,字段: {"city": str, "temp": int}'}],
    response_format={"type": "json_object"},
)
注意:
response_format=json_object只保证"是 JSON 文本",不保证 schema 严格匹配。要严格 schema 请用函数调用(tools)的 JSON 模式,或用strict: true的 structured output。
5.6、返回值结构
{
  "id": "chatcmpl-xxx",
  "object": "chat.completion",
  "model": "gpt-4o",
  "choices": [
    {
      "index": 0,
      "message": {"role": "assistant", "content": "..."},
      "finish_reason": "stop"   // stop / length / tool_calls / content_filter
    }
  ],
  "usage": {"prompt_tokens": 12, "completion_tokens": 34, "total_tokens": 46}
}
finish_reason="length"表示触到max_tokens被截断,需要调大。usage是计费依据,做成本监控必读。
6、流式响应(Streaming)
默认请求是"等模型全部生成完"才返回,长回答要等很久。开启 stream=true 后,服务端以 SSE(Server-Sent Events)逐块推送 token,前端能"打字机"式展示,体感更快,也便于中途取消。
6.1、SDK 流式(推荐)
from openai import OpenAI
client = OpenAI()

# stream=True 返回的是一个可迭代的生成器
stream = client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "user", "content": "用三句话介绍量子计算"}],
    stream=True,
    temperature=0.7,
)

# 逐 chunk 打印;每个 chunk.choices[0].delta.content 是增量文本
for chunk in stream:
    delta = chunk.choices[0].delta.content
    if delta:                      # 注意首包可能是空的(只有 role)
        print(delta, end="", flush=True)
print()  # 收尾换行
要点:
- 流式下返回对象类型是
Stream而非一次性ChatCompletion。 delta.content可能是None(如开头只带role、结尾只带finish_reason),必须判空。- 最后一块带
finish_reason。
6.2、async 流式(高并发服务)
import asyncio
from openai import AsyncOpenAI
client = AsyncOpenAI()

async def main():
    stream = await client.chat.completions.create(
        model="gpt-4o", messages=[{"role": "user", "content": "讲个冷笑话"}],
        stream=True,
    )
    async for chunk in stream:
        if chunk.choices[0].delta.content:
            print(chunk.choices[0].delta.content, end="", flush=True)

asyncio.run(main())
6.3、curl 流式
curl https://api.openai.com/v1/chat/completions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"gpt-4o","messages":[{"role":"user","content":"hi"}],"stream":true}'
# 响应是每行一个 data: {...} 的 SSE 流,结尾有 data: [DONE]
前端(浏览器/Node)对接本地 vLLM/Ollama 同样支持
stream,用语料层的ReadableStream解析data:行即可,逻辑与上面一致。
7、函数调用(Function Calling / Tools)完整示例
第 4.2 节展示的是旧 functions 写法。2026 年的标准写法是 tools + tool_calls,流程更清晰、天然支持多轮。核心思想:模型不直接执行函数,只决定"调哪个函数、参数是什么",真正执行由你的代码完成。
7.1、完整可运行示例:天气查询
import json
from openai import OpenAI
client = OpenAI()

# 1) 定义工具(JSON Schema 描述函数签名)
tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "查询指定城市的当前天气",
        "parameters": {
            "type": "object",
            "properties": {
                "city": {"type": "string", "description": "城市名,如 北京"},
                "unit": {"type": "string", "enum": ["celsius", "fahrenheit"]},
            },
            "required": ["city"],   # 必填参数,模型必须满足
        },
    },
}]

messages = [{"role": "user", "content": "北京现在天气怎么样?"}]

# 2) 第一次调用:让模型决定是否调用工具
resp = client.chat.completions.create(
    model="gpt-4o", messages=messages, tools=tools, tool_choice="auto")
msg = resp.choices[0].message

# 3) 如果模型要求调用工具
if msg.tool_calls:
    # 把模型的"意图消息"原样追加回上下文(含 tool_calls)
    messages.append(msg)
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        # 4) 你的代码真正执行函数(这里用假数据代替真实 API)
        if call.function.name == "get_weather":
            result = {"city": args["city"], "temp": 22, "unit": "celsius"}
        # 5) 把函数执行结果以 role=tool 回传,tool_call_id 必须对应
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": json.dumps(result, ensure_ascii=False),
        })
    # 6) 第二次调用:模型基于工具结果生成自然语言回答
    final = client.chat.completions.create(model="gpt-4o", messages=messages)
    print(final.choices[0].message.content)
else:
    print(msg.content)
7.2、关键细节(踩坑点)
- 必须原样回传
msg:包含tool_calls的 assistant 消息要完整 append,不能只挑 content。否则报invalid_request_error(历史不一致)。 tool_call_id要对得上:每条role=tool消息必须有对应的tool_call_id,多工具并发时尤易错。tool_choice:"auto"让模型自己决定;"none"禁止调用;也可强制{"type":"function","function":{"name":"get_weather"}}。- 参数校验:模型给的
arguments是字符串,务必json.loads并校验类型;恶意/异常输入要在你的代码里兜底。 - 并行调用:模型可能一次返回多个
tool_calls,用 for 循环逐个执行即可。 - 递归 agent:把"工具结果 → 再问模型 → 再调工具"包成循环,就构成了最基础的 ReAct/Agent 框架。
7.3、强制结构化输出(Structured Outputs)
如果需要模型稳定吐出固定 schema 的 JSON(如喂给下游程序),用 response_format 的 strict 模式或把 schema 包进 tools 即可:
# 用 tools 强约束输出字段(不让模型真去"调用",只是借 JSON 模式拿结构化结果)
extract_tool = {
    "type": "function",
    "function": {
        "name": "emit_result",
        "description": "输出抽取结果",
        "parameters": {
            "type": "object",
            "properties": {
                "name": {"type": "string"},
                "age": {"type": "integer"},
                "sentiment": {"type": "string", "enum": ["pos","neg","neu"]},
            },
            "required": ["name", "age", "sentiment"],
        },
    },
}
resp = client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "user", "content": "张三,28岁,今天很开心"}],
    tools=[extract_tool], tool_choice={"type": "function", "function": {"name": "emit_result"}},
)
args = json.loads(resp.choices[0].message.tool_calls[0].function.arguments)
print(args)   # {'name':'张三','age':28,'sentiment':'pos'}
8、错误码与重试策略
API 调用不可能 100% 成功,生产代码必须处理错误。OpenAI 用 HTTP 状态码 + error 对象返回问题。
8.1、常见错误码
| HTTP | 错误类型 | 含义 | 处理建议 |
|---|---|---|---|
| 400 | invalid_request_error | 参数错误 / 上下文超限 | 检查 messages、max_tokens、schema |
| 401 | authentication_error | API Key 无效/过期 | 检查 key 与组织 |
| 403 | permission_error | 无权限(如模型不可用) | 确认账户/模型访问权 |
| 404 | not_found_error | 模型名拼错 | 核对 model 名 |
| 429 | rate_limit_error | 触发 RPM/TPM 限流 | 退避重试 / 降速 |
| 429 | quota_exceeded | 余额或配额用完 | 充值 / 申请提额 |
| 500 | server_error | 服务端内部错误 | 重试 |
| 502/503/529 | service_unavailable | 网关/过载 | 退避重试 |
8.2、带指数退避的重试封装
import time, random
from openai import OpenAI, APIError, RateLimitError

client = OpenAI()

def chat_with_retry(messages, max_retries=4, **kwargs):
    for attempt in range(max_retries):
        try:
            return client.chat.completions.create(
                model="gpt-4o", messages=messages, **kwargs)
        except RateLimitError as e:          # 429:限流,退避后重试
            wait = (2 ** attempt) + random.uniform(0, 1)   # 指数退避 + 抖动
            print(f"限流,{wait:.1f}s 后重试 ({attempt+1}/{max_retries})")
            time.sleep(wait)
        except APIError as e:                 # 5xx:服务端错误,同样退避
            if attempt == max_retries - 1:
                raise
            time.sleep((2 ** attempt))
    raise RuntimeError("重试耗尽")

resp = chat_with_retry([{"role": "user", "content": "你好"}])
print(resp.choices[0].message.content)
要点:
- 指数退避 + 抖动(jitter)避免所有客户端同时重试造成"重试风暴"。
- 只对可重试错误(429/5xx)重试;400/401/404 重试没意义,应直接报错。
- 设置上限次数,避免死循环。无代理时也可用
tenacity库的@retry装饰器更优雅。
9、成本优化
API 按 token 计费(输入 + 输出分别计价,输出更贵)。本地部署(见 07 篇)则把"按量付费"变成"一次性硬件/电费"。下面是调用 OpenAI 的省钱要点:
9.1、压输入
- 精简 system prompt:别塞几 KB 的"人设长文",每次请求都重复计费。需要持久背景优先考虑 RAG(检索后只拼相关片段)。
- 裁剪历史:多轮对话不是越长越好。只保留最近 N 轮 + 必要时摘要旧对话,避免每轮把全部历史重发。
- 用便宜模型做初筛:先用
gpt-4o-mini分类/抽取,只有复杂任务才上gpt-4o。
9.2、压输出
- 设合理的
max_tokens,不要无上限(尤其 o 系列推理 token 很贵)。 - 明确指令"用一句话回答 / 不超过 100 字",减少啰嗦。
- 批量任务用
batchAPI(异步、降价约 50%)。
9.3、监控与治理
- 读
usage字段,按user维度埋点统计,发现异常消耗。 - 设组织级
max_budget(月度上限)和告警。 - 高频同质任务:能本地化的(如 7B 中文问答)迁到 Ollama/vLLM,省下调用费。
9.4、本地 vs 云端成本决策
| 场景 | 建议 |
|---|---|
| 低频、偶发、要最强能力 | 直接用 OpenAI,省心 |
| 高频、隐私敏感、中文为主 | 本地 vLLM/Ollama(7B~14B 够用则几乎零边际成本) |
| 超长上下文/超大模型 | 云端(本地显存不够) |
| 需要 function calling 编排 | 两者都支持,按上面成本权衡 |
十、小结
chat/completions的核心旋钮是 temperature/top_p(创意)、max_tokens(长度)、penalty(复读)、tools(函数调用)、stream(流式)。- 流式用生成器逐块取
delta.content;函数调用记得原样回传tool_calls并配对tool_call_id。 - 生产代码必须做错误分类 + 指数退避重试,只对 429/5xx 重试。
- 成本大头在"输入重复发送"和"输出过长",靠裁剪历史、用便宜模型初筛、设 max_tokens 来压。
- 本地服务与 OpenAI 接口兼容,同一套客户端代码改
base_url即可切换——这也是 07 篇部署成果的直接用武之地。

 浙公网安备 33010602011771号