
Spark SQL 及其DataFrame的基本操作
1.Spark SQL出现的 原因是什么?
Spark SQL是用于结构化数据处理的Spark模块。它提供了一种称为DataFrames的编程抽象,还可以充当分布式SQL查询引擎。它使未修改的Hadoop Hive查询在现有部署和数据上的运行速度提高了100倍。
2.用spark.read 创建DataFrame
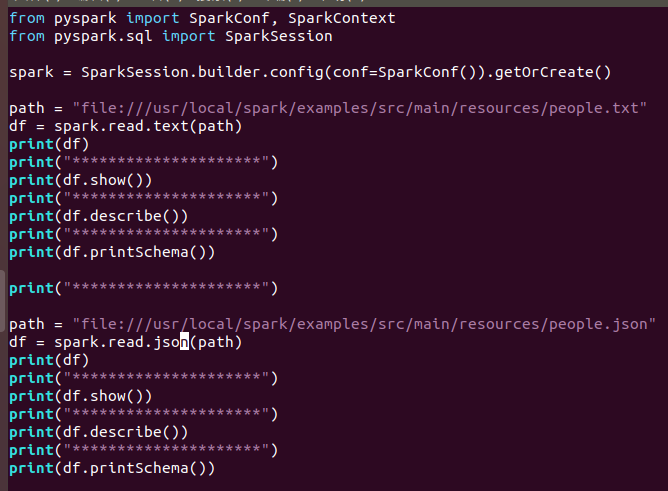
运行结果:
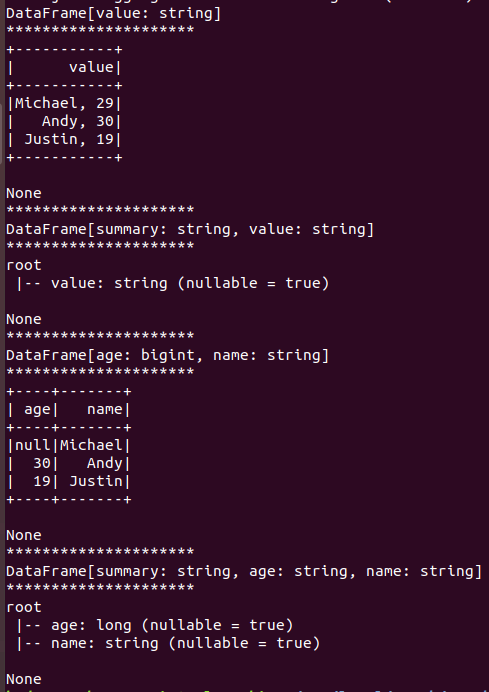
3.观察从不同类型文件创建DataFrame有什么异同?
txt文件:创建的DataFrame数据没有结构
json文件:创建的DataFrame数据有结构
读text
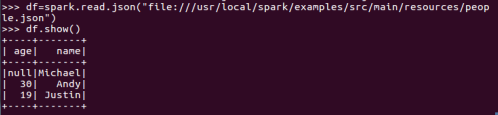
读json
打印概要
df.printSchema()

查询总行数
df.count()

df.head(3) #list类型,list中每个元素是Row类
输出全部行

df.collect() #list类型,list中每个元素是Row类
查询概况

df.describe().show()
取列

df.select()
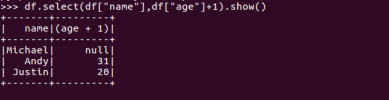
df.filter()
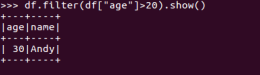
df.groupBy()

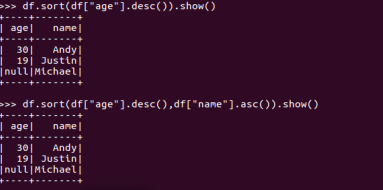
df.sort()

 浙公网安备 33010602011771号