
Java学习笔记—集合
继承关系
下图对Java中常用的Map类型集合继承关系进行了展示:

图中左上角带有“钉住”样式的框代表这是个接口
下图对Java中常用的集合继承关系进行了展示:

图中左上角带有“钉住”样式的框代表这是个接口
Collection
集合是存储对象数据的集合容器,集合比数组的优势:
- 集合可以存储任意类型的对象数据,数组只能存储同一种数据类型的数据
- 集合的长度是会发生变化的,数组的长度是固定的。
Collection是最基本的集合接口。
List
可以重复,通过索引取出加入数据,顺序与插入顺序一致,可以含有null元素。
实现List接口的有Vector、ArrayList和LinkedList,至于Stack这里不再赘述,他们的优缺点整理如下:
ArrayList:查询速度快,增删改慢,因为是一种类似数组的形式进行存储,因此它的随机访问速度极快;
Vector:与ArrayList相同,查询速度快,增删改慢;
LinkedList:增删速度快,查询稍慢;
ArrayList与Vector的区别:
- 如果集合中的元素数量大于当前集合数组的长度时,Vector的增长率是目前数组长度的100%,而ArryaList增长率为目前数组长度的50%。所以,如果集合中使用数据量比较大的数据,用Vector有一定优势
- Vector是线程同步的而ArrayList是线程不同步,所以Vector线程安全,但是因为每个方法都加上了synchronized,所以Vector在效率上小于ArrayList
Set
Set集合中的数据是无序且唯一的(与Map类似), 实现类都不是线程安全的类。可以通过Set set = Collections.sysnchronizedSet(Set对象)来实现线程安全
HashSet:是Set接口(Set接口是继承了Collection接口的)最常用的实现类,底层使用了哈希表散列算法。他的优点是查询以及插入速度非常快,因为相当于根据数组下标直接存取。但是他适用于较少量的数据操作,因为数据量多的情况下冲突的可能性会大大增加从而大大降低其速度。因为采用了哈希算法,所以他要求所有存在于哈希表中的对象元素必须实现equals和hashCode方法来判断两个对象是否相等,规则为:
- equals比较为true
- hashCode值相同
TreeSet:也是Set接口的一个实现类,也拥有set接口的一般特性,但是不同的是他也实现了SortSet接口,它底层采用的是红黑树算法。
Tree最重要的就是它的两种排序方式:自然排序和客户化排序
自然排序:实现了Comparable接口,所以TreeSet可以调用对象的ComparableTo()方法来比较集合的大小,然后进行升序排序,这种排序方式叫做自然排序。其中实现了Comparable接口的还有BigDecimal、BigInteger、Byte、Double、Float、Integer、Long、Short(按照数字大小排序)、Character(按照Unicode值的数字大小进行排序)String(按照字符串中字符的Unicode值进行排序)类等。
客户化排序:其实就是实现java.util. Comparator
Map
Java的Map(映射)是一种把键对象和值对象进行映射的集合,其中每一个元素都包含了键对象和值对象,其中值对象也可以是Map类型的数据,因此,Map支持多级映射,Map中的键是唯一的,但值可以不唯一,Map集合有两种实现,一种是利用哈希表来完成的叫做HashMap,它和HashSet都是利用哈希表来完成的,区别其实就是在哈希表的每个桶中,HashSet只有key,而HashMap在每个key上挂了一个value;另一种就是TreeMap,它实现了SortMap接口,也就是使用了红黑树的数据结构,和TreeSet一样也能实现自然排序和客户化排序两种排序方式,而哈希表不提供排序。
HashMap:哈希表的实现原理中,先采用一个数组表示位桶,每个位桶的实现在1.8之前都是使用链表,但当每个位桶的数据较多的时候,链表查询的效率就会不高,因此在1.8之后,当位桶的数据超过阈值(8)的时候,就会采用红黑树来存储该位桶的数据(在阈值之前还是使用链表来进行存储),所以,哈希表的实现包括数组+链表+红黑树,在使用哈希表的集合中我们都认为他们的增删改查操作的时间复杂度都是O(1)的,不过常数项很大,因为哈希函数在进行计算的代价比较高, HashMap和Hashtable类似,不同之处在于HashMap是非同步的,并且允许null,即null value和null key。但是将HashMap视为Collection时(values()方法可返回Collection),其迭代子操作时间开销和HashMap 的容量成比例。因此,如果迭代操作的性能相当重要的话,不要将HashMap的初始化容量设得过高,或者load factor过低。
HashTable:Hashtable继承Map接口,实现一个key-value映射的哈希表。任何非空(non-null)的对象都可作为key或者value,并且他是线程安全的,所以在性能上略低于HashMap。
LinkedHashMap:LinkedHashMap继承于HashMap,HashMap是无序的,当我们希望有顺序地去存储key-value时,就需要使用LinkedHashMap了,他的存储顺序默认为插入顺序。LinkedHashMap其实就是可以看成HashMap的基础上,多了一个双向链表来维持顺序。他的静态内部类Entry相比HashMap多了before和after两个前后节点的指针属性,所以在插入数据时依然是按照HashMap的插入方法,并且数据的实际物理存储顺序也是随机的,但是插入时通过维护每个Entry的前后指针指向,我们就可以通过指针按照我们希望的顺序去迭代遍历数据。
HashMap 和 Hashtable 的区别
命名
HashMap 采用标准的驼峰命名方法,而 Hashtable 不是
继承关系
Hashtable 继承自 Dictonary 抽象类,而 HashMap 继承自 AbstractMap 抽象类, AbstractMap 实现了 Map 接口
相同的是这两个类都实现了
Cloneable和Serializable接口
单从这个两个实现类以及父类的命名规则上来看,
HashMap相比较Hashtable也更加合理不是吗?
线程安全
Hashtable 更加注重安全,涉及修改的方法都用 synchronized 关键字修饰,所以是线程安全的,但是速度较慢
HashMap 则更加注重速度,所以它没有任何保证线程安全的措施
Null 存储策略
Hashtable 更加注重安全,所以不允许 key 为 null 或者value为 null
// 摘自Hashtable源码,jdk1.8
public synchronized V put(K key, V value) {
    // Make sure the value is not null
    if (value == null) {
        // value为null抛出空指针异常
        throw new NullPointerException();
    }

    // Makes sure the key is not already in the hashtable.
    Entry<?,?> tab[] = table;
    // 没有对key判空便调用其hashCode()方法,若key为null会空指针
    int hash = key.hashCode();
    int index = (hash & 0x7FFFFFFF) % tab.length;
HashMap 则同时允许 key 或 value 为 null ,但是 key == null 的 value 会被固定存储在下标为 0 的位置
// 摘自HashMap源码,jdk1.8
static final int hash(Object key) {
    int h;
    // key为null时返回值都是0
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
因此,使用
HashMap的get(key)方法获取到的结果为null时可能有两种情况:1. 哈希表中不存在该key;2. 哈希表中存在该key但是对应的value为null,这点需要注意
散列函数
常见的散列函数(将任意长度的输入转换为固定长度的输出的函数)有除留余数法、平方取中法、基数转换法、折叠法等等,其中除留余数法是最常用的也是比较简单的散列函数(至于其它的有兴趣可以去了解), Hashtable 和 HashMap 均使用的是除留余数法,只不过具体的及算法方式方法上有所区别
除留余数法是什么?其实就是取余运算,取余运算为什么能够作为散列函数?假设有如此取余运算: h(x) = x mod M ,不论关键码 x 取值为多少,使用 x 对 M 取余得到的结果 h(x) 必定满足 0 <= h(x) < M ,这 M 不刚好就符合成为下标的条件吗?
下面就来看看 Hashtable 是怎么使用除留余数法的
// 摘自Hashtable源码,jdk1.8
public synchronized V get(Object key) {
    Entry<?,?> tab[] = table;
    // 调用key的hashcode()方法获取关键码hash
    int hash = key.hashCode();
    // 先不管对关键码hash进行的运算,很明显可以看出来这就是取余
    int index = (hash & 0x7FFFFFFF) % tab.length;

    ...
}
为什么需要 (hash & 0x7FFFFFFF) ?
首先,作为 key 的类必须重写 Object 类的 hashCode() 和 equals() 方法(原因自行了解),而这个方法的返回值类型为 int ,所以 hash 有可能为负数:
public class Test {
    public static void main(String[] args) {
        // -1
        System.out.println(new Integer(-1).hashCode());
    }
}
如果 hash 为负数,那么和 tab.length 取余的结果也会是负数,而下标怎么可能为负数呢?所以 (hash & 0x7FFFFFFF) 就是为了将 hash 的符号位置零,使其变为正整数
在Java中整型转换为二进制后首位便是符号位(采用补码表示) ,符号位为
0表示正数,为1表示负数,&运算符是按位与,将16进制数0x7FFFFFFF转换为二进制是0111 1111 1111 1111 1111 1111 1111 1111,所以(hash & 0x7FFFFFFF)运算就是将hash的二进制最高位和0进行与运算,结果永远为0,符号位变为0那自然就成为正整数了
使用除留余数法时,选择并使用合适的值作为模 M (也就是哈希表的容量)对产生哈希冲突的影响举足轻重,一般有如此结论(或规律): 偶数 < 奇数 < 素数 (按照哈希冲突的概率从大到小排序)
具体原理和证明参考:证明为什么哈希表除m取余法的被除数为什么用素数比较好
可以看到使用素数作为 M 是最好的,所以 Hashtable 的默认初始化大小为素数 11 (不指定初始化容量时),但是扩容算法为 newSize = oldSize * 2 + 1 ,这样做是因为扩容时寻找下一个合适的素数是需要进行比较复杂的运算的(寻找素数本身就是比较复杂的),使用素数虽然减少了冲突,但是对速度会有较大的影响, Hashtable 选择了折中,将扩容时容量大小设置为奇数,在速度和冲突之间取得了平衡
前面说过, HashMap 和 Hashtable 采用了一样的散列函数只是在计算方式上有所不同
也正因为计算方式的改变,
HashMap的M选取规则也和Hashtable不同
HashMap 的下标计算方式如下:
// 摘自HashMap源码,jdk1.8
final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
            boolean evict) {
    ...
    // i =  (n - 1) & hash] 便是下标计算方法,n是容量,hash是关键码
    if ((p = tab[i = (n - 1) & hash]) == null)
        tab[i] = newNode(hash, key, value, null);

    ...
}
乍一看,这不是按位与运算吗?和取余有什么关系?试试下面的例子:
public class Test {
    public static void main(String[] args) {
        // 模拟随机hash
        final Random random = new Random();
        // 容量
        final int n = 16;

        for (int i = 0; i < 100; i++) {
            // 正整数
            int hash = random.nextInt() & 0x7FFFFFFF;
            int result1 = hash % n;
            int result2 = hash & (n - 1);
            // 打印的值恒为true
            System.out.println((result1 == result2));
        }

    }
}
不论执行多少次,以上两种运算获得的结果都是相等的,但是,如果将 n 改为奇数再运行就会出现大量结果不相等的情况,所以运算 (n - 1) & hash == hash % n 成立的前提条件是: n 必须是2的幂,也就是 n 必须是偶数
为什么呢?先来看一个例子:
| 位次 | 7 | 6 | 5 | 4 | 3 | 2 | 1 |
|---|---|---|---|---|---|---|---|
| 位权 | 2^6 | 2^5 | 2^4 | 2^3 | 2^2 | 2^1 | 2^0 |
| hash = 83 | 1 | 0 | 1 | 0 | 0 | 1 | 1 |
| n = 16 | 0 | 0 | 1 | 0 | 0 | 0 | 0 |
实际上Java中
int类型长度为32位,这里省去了更高的位次,因为更高的位次均是0
当 n 为偶数时,可以表示为: n = 1 * 2^x (x > 0) ,在二进制下, n 只有第 x + 1 位取值为 1 ,其它位均是 0 ,在上面的例子中 n = 16 = 1 * 2^4 ,所以 x = 4 ,继而 x + 1 = 5 ,也就是说此时 n 只有第5位为 1 ,以这个特殊的位次作为高低位分界线,那么 hash = 83 可以表示为高位部分的值(位次大于等于 5 的部分)加上低位部分的值(位次小于 5 的部分 ),即 hash = (1*2^6 + 1*2^4) + (1*2^1 + 1*2^0) = (64 + 16) + (2 + 1) ,将高位部分提出一个公因子 2^4 = 16 可得 hash = 2^4(2^2 + 1) + (2^1 + 2^0) = 16(4 + 1) + (2 + 1) = 16*5 + 3 ,低位部分的值 3 恰好就是余数
上面只是一个特定的例子,但是是可以推广的,对于任意 hash 值(整数),在二进制表示下都可以使用 x + 1 进行高低位的分割,并且高位部分一定可以被 n 整除(参考上例的写法),因为高位部分所有位权都含有公因子 n ;高位部分如果均为 0 说明 hash < n , hash 本身就是余数,以 x + 1 分割后低位部分已经是 hash 的值,所以低位部分依旧是余数
那么怎么才能直接得到低位部分的值也就是余数呢? 这就是 HashMap 取余运算设计非常巧妙的地方了,我们让 n = n - 1 = 15 :
| 位次 | 7 | 6 | 5 | 4 | 3 | 2 | 1 |
|---|---|---|---|---|---|---|---|
| 位权 | 2^6 | 2^5 | 2^4 | 2^3 | 2^2 | 2^1 | 2^0 |
| hash = 83 | 1 | 0 | 1 | 0 | 0 | 1 | 1 |
| n = 16 | 0 | 0 | 1 | 0 | 0 | 0 | 0 |
| n = n - 1 = 15 | 0 | 0 | 0 | 1 | 1 | 1 | 1 |
15 是一个低位部分(位次小于 5 的部分 )全都是 1 且高位部分全都是 0 的数,然后结合按位与运算的特性,将 n - 1 = 15 和 hash = 83 进行按位与运算就会得到 hash 低位部分的值,同样的,对于任意的正偶数 n , n - 1 都会得到一个低位部分均为 1 ,高位部分均为 0 的数,该数和 hash 进行按位与运算自然结果就是 hash 低位部分的值,也就是余数,并且,因为 n 必定为正整数,所以 n 的符号位必定为 0 ,所以使用按位与运算得到的余数的符号位也必定是 0 ,也就是说这样计算得到的余数还会自动取正(真的是太巧妙了)
为什么这么执着于位运算?因为计算机进行位运算的速度是非常快的,也正是因为
HashMap大规模采用位运算作为核心运算方式才极大地提高了速度
为什么
n为奇数时这个规律不行?
HashMap的扰动算法
但是(凡事都有利弊嘛),这种余数计算方式也给 HashMap 带来了另外一个问题:使用偶数作为模,提高了哈希冲突的概率
在上面的推广结论中,最后使用一个低位部分均为 1 ,高位部分均为 0 的数 n-1 和 hash 进行按位与运算得到了余数,问题就出在这里,因为一旦模 n 确定了之后,不论 hash 的值是多少,最终运算的结果只取决于 hash 的低位部分(位次小于 x + 1 的部分),也就是说 hash 值的低 x 位就能够决定最后的余数是多少, hash 的值虽然是随机变化的,但只要低位部分相同的 hash ,它们计算的结果就相同
解决这个问题的思路也非常清晰,既然低位部分能够决定最后的余数,那只需要让低位部分也能够反映高位部分的取值情况即可,也就是说不能直接使用原始的 hash 值进行取余运算,需要将其进行某种运算之后得到符合条件的(低位部分也能够反映高位部分的取值情况的) hash1 之后取余,在 HashMap 中的这个过程被称之为对 hash 值的扰动,下面来看看 HashMap 的扰动算法:
// 摘自HashMap源码,jdk1.8
static final int hash(Object key) {
    int h;
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
可以看到扰动算法将 h 与 无符号右移(高位补 0 )了 16 位后的 h 进行 异或运算,这样使得 h 的高16位和低16位的信息都被保留了,并且由于低16位和高16位进行了异或运算产生了关联,所以低16位也能够反映高16位的信息,从而使得后续的取余结果分布更加均匀,进一步降低哈希冲突的概率
我想大家肯定会有诸如“为什么偏偏是这样?”的疑问,针对可能的问题,解释如下:
1、为什么是无符号右移?
答:这里使用无符号右移和有符号右移都是可以的,但是无符号右移速度更快(不用考虑符号位情况,无脑补 0 即可),并且,这里无需考虑计算结果的正负问题(后面取余时余数会自动取正),所以使用无符号右移
2、为什么右移16位?不能是15、17位?
答:关于这一点,我也没找到一个简单清晰、容易理解的解释,说一下我自己的理解:在实际使用过程中,哈希表的容量是随机的,也就是说哈希码的低位部分位数是随机的,所以扰动时需要尽可能的让参与扰动的低位部分的位数更多(尽可能让可扰动的哈希表容量上限更大),但同时又需要低位部分每一位都能反应高位部分的信息(也就是要求低位部分每位都要有与之对应的高位并且这两部分不能交叉),所以满足条件的低位部分最多只能是容量位数上限的一半,在32位的情况下也就是16位,所以右移16位,再者,对于容量大于 2^16 的情况,哈希冲突的概率已经足够小了,也已经不需要扰动了
不能交叉是指在容量确定时,低位部分与低位部分、高位部分与高位部分自身进行了关联运算,比如只右移
2位、容量为n = 2 ^ 4 = 16时,低位部分(x < 5)中的第1位、第2位会和同处于低位部分的第3位和第4位进行异或运算产生关联,高位部分(x >= 5)中的第5位、第6位会和同为高位部分的第7位、第8位进行异或运算产生关联,这种情况就是产生了交叉,很明显,发生交叉时,低位部分已经不能满足每一位都反应高位取值情况的要求了
3、为什么要用异或运算?不能用与、或、同或运算吗?
答:首先,使用同或是可以的,但是在Java中只有异或运算符( ^ ),同或只能通过对异或的结果按位非( ~ )后得到,所以就直接使用了异或;其次,与、或运算会分别使运算结果向 0 、 1 靠拢(总共有四种运算情况: 00 , 01 , 10 , 11 ,与运算时四种情况中有三种情况结果都是 0 ,或运算中有三种情况结果都是 1 ),增加了哈希冲突的概率,违背了扰动的初衷
HashMap的开发者属实是把位运算给玩明白了
可以运行下面的例子验证一下试试:
@Slf4j
public class Test {
    public static void main(String[] args) {
        log.info("异或运算无符号右移:{}", 15 & ("郭德纲".hashCode() ^ ("郭德纲".hashCode() >>> 16)));
        log.info("异或运算无符号右移:{}", 15 & ("彭于晏".hashCode() ^ ("彭于晏".hashCode() >>> 16)));
        log.info("异或运算无符号右移:{}", 15 & ("李小龙".hashCode() ^ ("李小龙".hashCode() >>> 16)));
        log.info("异或运算无符号右移:{}", 15 & ("蔡徐鸡".hashCode() ^ ("蔡徐鸡".hashCode() >>> 16)));
        log.info("异或运算无符号右移:{}", 15 & ("张三".hashCode() ^ ("张三".hashCode() >>> 16)));
        log.info("异或运算无符号右移:{}", 15 & ("李四".hashCode() ^ ("李四".hashCode() >>> 16)));
        log.info("异或运算无符号右移:{}", 15 & ("王五".hashCode() ^ ("王五".hashCode() >>> 16)));
        log.info("异或运算无符号右移:{}", 15 & ("赵六".hashCode() ^ ("赵六".hashCode() >>> 16)));
        log.info("\n");
        log.info("同或运算无符号右移:{}", 15 & ~("郭德纲".hashCode() ^ ("郭德纲".hashCode() >>> 16)));
        log.info("同或运算无符号右移:{}", 15 & ~("彭于晏".hashCode() ^ ("彭于晏".hashCode() >>> 16)));
        log.info("同或运算无符号右移:{}", 15 & ~("李小龙".hashCode() ^ ("李小龙".hashCode() >>> 16)));
        log.info("同或运算无符号右移:{}", 15 & ~("蔡徐鸡".hashCode() ^ ("蔡徐鸡".hashCode() >>> 16)));
        log.info("同或运算无符号右移:{}", 15 & ~("张三".hashCode() ^ ("张三".hashCode() >>> 16)));
        log.info("同或运算无符号右移:{}", 15 & ~("李四".hashCode() ^ ("李四".hashCode() >>> 16)));
        log.info("同或运算无符号右移:{}", 15 & ~("王五".hashCode() ^ ("王五".hashCode() >>> 16)));
        log.info("同或运算无符号右移:{}", 15 & ~("赵六".hashCode() ^ ("赵六".hashCode() >>> 16)));
        log.info("\n");
        log.info("异或运算有符号右移:{}", 15 & ("郭德纲".hashCode() ^ ("郭德纲".hashCode() >> 16)));
        log.info("异或运算有符号右移:{}", 15 & ("彭于晏".hashCode() ^ ("彭于晏".hashCode() >> 16)));
        log.info("异或运算有符号右移:{}", 15 & ("李小龙".hashCode() ^ ("李小龙".hashCode() >> 16)));
        log.info("异或运算有符号右移:{}", 15 & ("蔡徐鸡".hashCode() ^ ("蔡徐鸡".hashCode() >> 16)));
        log.info("异或运算有符号右移:{}", 15 & ("张三".hashCode() ^ ("张三".hashCode() >> 16)));
        log.info("异或运算有符号右移:{}", 15 & ("李四".hashCode() ^ ("李四".hashCode() >> 16)));
        log.info("异或运算有符号右移:{}", 15 & ("王五".hashCode() ^ ("王五".hashCode() >> 16)));
        log.info("异或运算有符号右移:{}", 15 & ("赵六".hashCode() ^ ("赵六".hashCode() >> 16)));
        log.info("\n");
        log.info("与运算无符号右移:{}", 15 & ("郭德纲".hashCode() & ("郭德纲".hashCode() >>> 16)));
        log.info("与运算无符号右移:{}", 15 & ("彭于晏".hashCode() & ("彭于晏".hashCode() >>> 16)));
        log.info("与运算无符号右移:{}", 15 & ("李小龙".hashCode() & ("李小龙".hashCode() >>> 16)));
        log.info("与运算无符号右移:{}", 15 & ("蔡徐鸡".hashCode() & ("蔡徐鸡".hashCode() >>> 16)));
        log.info("与运算无符号右移:{}", 15 & ("张三".hashCode() & ("张三".hashCode() >>> 16)));
        log.info("与运算无符号右移:{}", 15 & ("李四".hashCode() & ("李四".hashCode() >>> 16)));
        log.info("与运算无符号右移:{}", 15 & ("王五".hashCode() & ("王五".hashCode() >>> 16)));
        log.info("与运算无符号右移:{}", 15 & ("赵六".hashCode() & ("赵六".hashCode() >>> 16)));
        log.info("\n");
        log.info("或运算无符号右移:{}", 15 & ("郭德纲".hashCode() | ("郭德纲".hashCode() >>> 16)));
        log.info("或运算无符号右移:{}", 15 & ("彭于晏".hashCode() | ("彭于晏".hashCode() >>> 16)));
        log.info("或运算无符号右移:{}", 15 & ("李小龙".hashCode() | ("李小龙".hashCode() >>> 16)));
        log.info("或运算无符号右移:{}", 15 & ("蔡徐鸡".hashCode() | ("蔡徐鸡".hashCode() >>> 16)));
        log.info("或运算无符号右移:{}", 15 & ("张三".hashCode() | ("张三".hashCode() >>> 16)));
        log.info("或运算无符号右移:{}", 15 & ("李四".hashCode() | ("李四".hashCode() >>> 16)));
        log.info("或运算无符号右移:{}", 15 & ("王五".hashCode() | ("王五".hashCode() >>> 16)));
        log.info("或运算无符号右移:{}", 15 & ("赵六".hashCode() | ("赵六".hashCode() >>> 16)));
    }
}
冲突处理
通常解决哈希冲突的方法有4种:
1、开放定址法:也称为线性探测法,就是发生冲突时,从冲突的下标开始,按照特定的顺序从哈希表中找到下一个空闲位置,然后把发生冲突的元素存入找到的空闲位置中
2、链地址法:即哈希表存储的元素类型是一个单向链表的头节点,发生冲突时把冲突的元素以尾插法的方式插入到以现有元素为头节点的那个单向链表末尾,该方法是用来解决哈希冲突最常用的方法
3、二次哈希法:顾名思义,就是当出现冲突时,用另外一个散列函数再次对运算结果做哈希,如果结果还是冲突,则继续运算直到不再产生冲突为止,很明显,这种方式会增加计算时间,对性能的影响较大
4、建立公共溢出区法:非常简单,就是将哈希表分为基本表和溢出表两个部分,把存在冲突的元素统一放到溢出表中
HashTable 使用的就是链地址法,没什么特别的; HashMap 虽然也使用了链地址法,但在同一冲突元素数量大于等于常量 TREEIFY_THRESHOLD = 8 且哈希表容量大于等于常量 MIN_TREEIFY_CAPACITY = 64 时,会将单向链表转变为红黑树(因为哈希表追求的查询速度是 O(1) ,当冲突元素过多时只使用单链表处理会使查询速度减慢到 O(n) ,而使用红黑树会使查询速度提高到 O(log n) ),在元素被删除减少到小于等于常量 UNTREEIFY_THRESHOLD = 6 时,红黑树又会转换为单链表
常见问题
UnsupportedOperationException 异常
public class test {
  public static void main(String[] args) {

    String[] arr = new String[3];
    arr[0] = "1";
    arr[1] = "2";
    arr[2] = "3";

    // 调用Arrays中的asList方法将String[]转化为List<String>
    List<String> list = Arrays.asList(arr);

    System.out.println("list: " + list.toString());
    // 为list添加一个元素,报错
    list.add("f");
    System.out.println("list: " + list.toString());
    // 删除list中的一个元素,报错
    list.remove(2);
    System.out.println("list: " + list.toString());
  }
}
将 String[] 转化为 List<String> 的时候,是不能对转化出来的结果进行 add , remove 操作的,因为它并不是我们熟悉的 ArrayList ,而是 Arrays 里面的内部类
先来看看 asList 方法的源码:
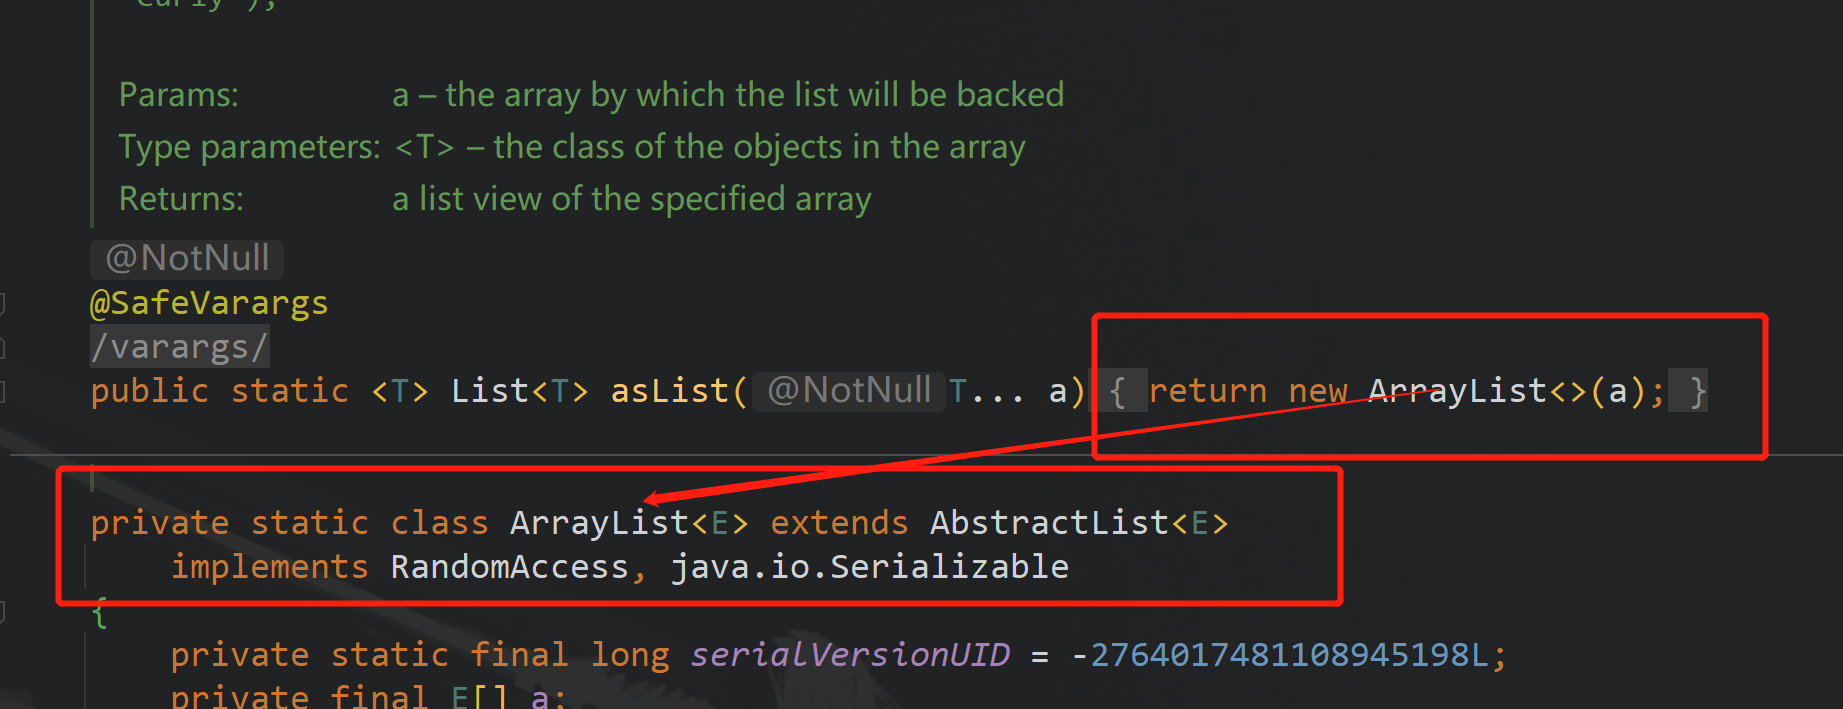
再看看 Arrays 中的这个内部类: ArrayList
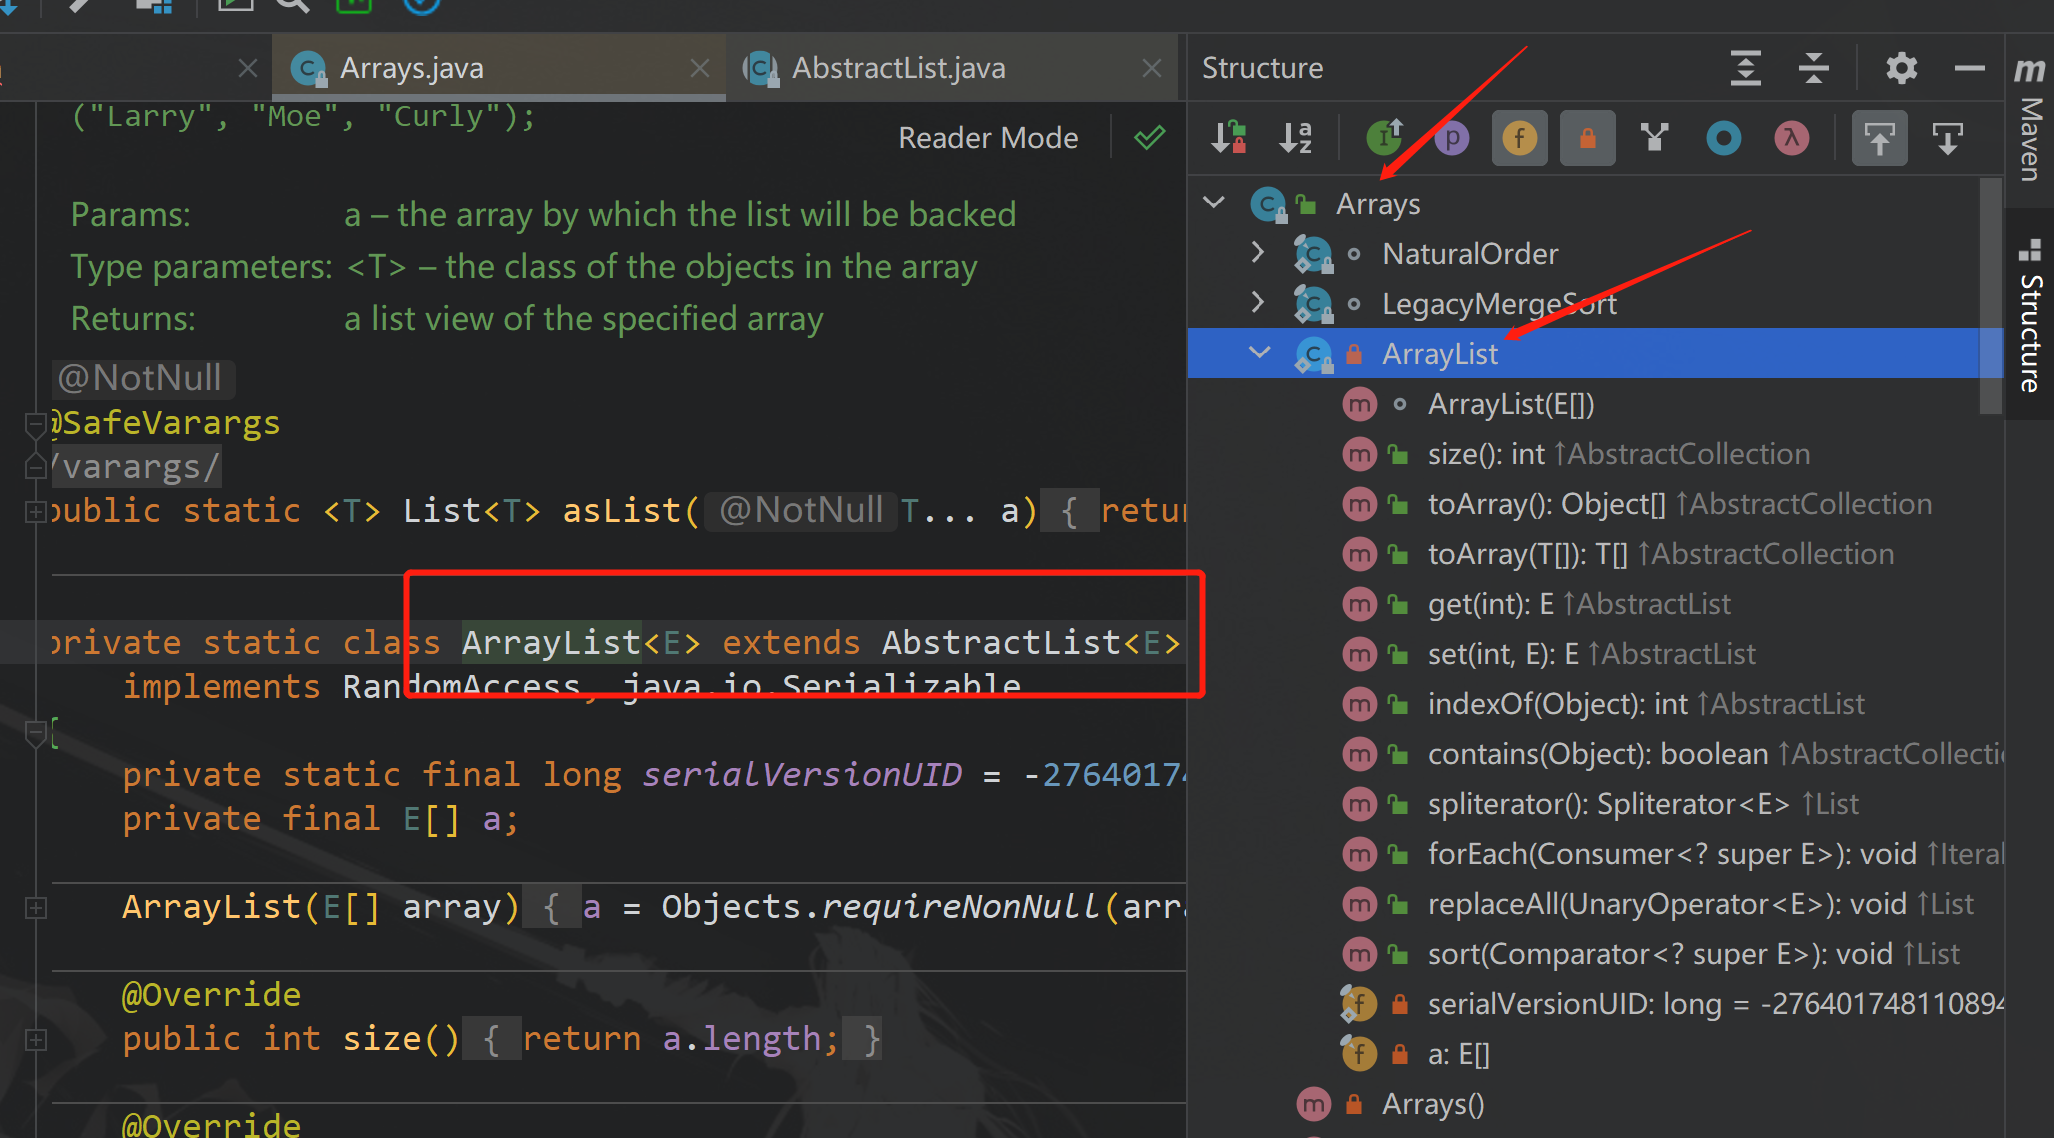
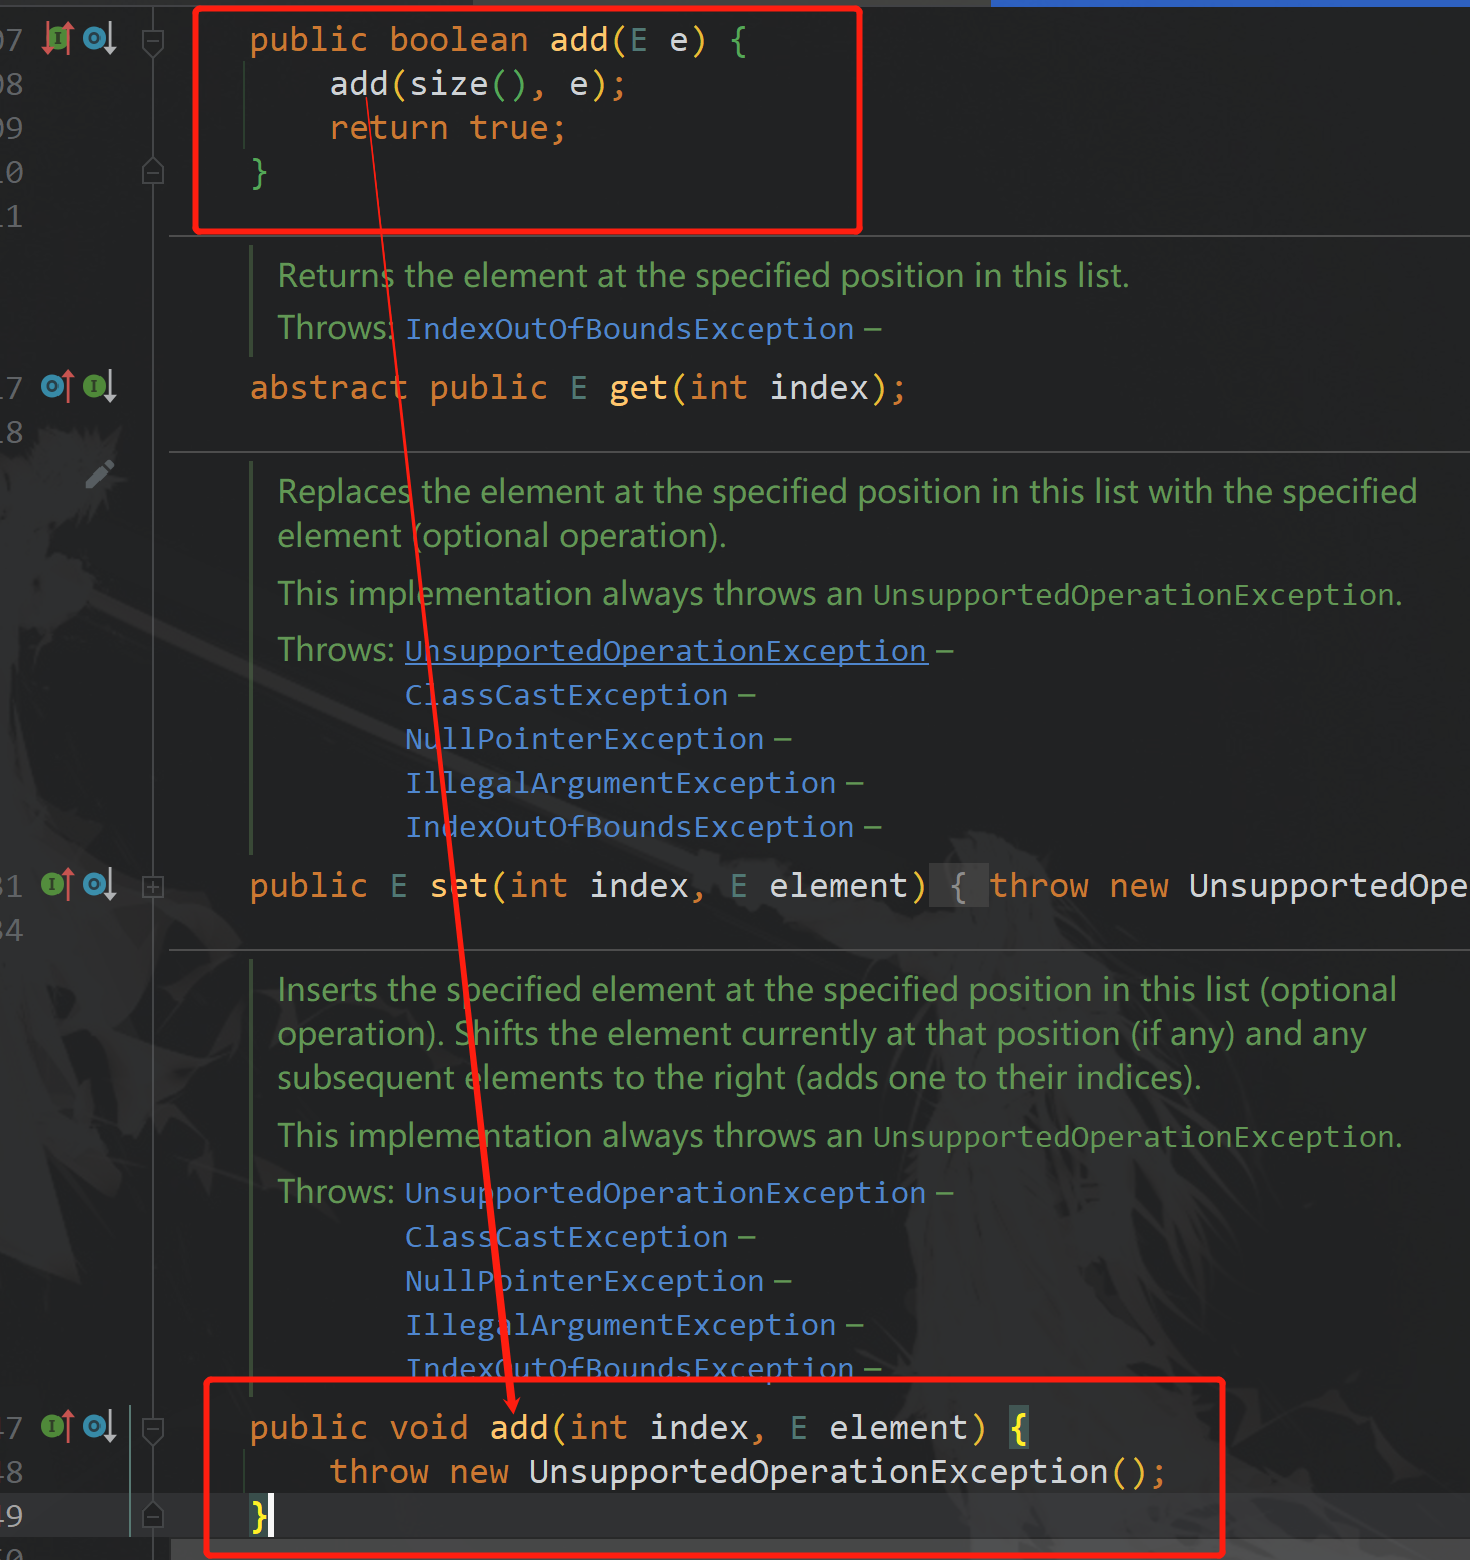
可以看到这个 ArrayList 继承了 AbstractList 类,但是它并没有重写 AbstractList 的 add 和 remove 方法,以 add 为例,在调用时其实就是调用的 AbstractList 的 add 方法,下面再来看看 AbstractList 的 add 方法:
解决办法:
List<String> list = new ArrayList<String>(Arrays.asList(arr));

 浙公网安备 33010602011771号