
软件开发
需要背的
交叉编译:在一个平台生成另一个平台的执行代码
调试器和被调试进程通过网络或串口
编译器工作过程:预处理,生成汇编,生成目标代码,连接成可执行代码
调试器到目标芯片的连接方式:串口,并口,网络,jtag
程序设计语言定义三要素:语法,语义,语用
编译过程:
词法分析:识别单词
语法分析:组合成语法短语
语义分析:类型审查,除数不为0等
中间代码优化:与平台无关的代码优化处理
目标代码生成:链接生成特定平台的可执行代码
逆波兰式:又叫后缀表示法,即运算符在操作数后面,
如
3 + 4 --> 3 4 +,
(a+b)*c-(a+b)/e =((a+b)*c)((a+b)/e)- = ((a+b)c*)((a+b)e/)- = (ab+c*)(ab+e/)- = ab+c*ab+e/-
计算过程就是先加括号加到任意一层的表达式都被括起来了,然后再由外到内更换运算符位置且去掉括号即可。
三地址码:c = a + b
四元式:运算符,操作数1,操作数2,结果
树:
C语言相关:
text:存代码
data:存已初始化的全局变量和常量
bss:存未初始化的全局变量
各种基本语法比如英文的分号,#include,#define,#ifdef之类,注释的两种方式:
c = a+b;	//单行的
/*
代码块的
*/
C标识符命名方式:字母数字下划线,不能使用保留字,即:
int edward;
int edward_0;
int Edward_0;
C语言区分大小写
关于数据类型:
可以这样记:
雷打不动的:char:8,short:16,long long:64,float:32,double:64
跟机器字长有关的:int:能32就32,char*:和字长一样,long:除了16位机是32之外,剩下的和字长一样。
优先按照题目给定,否则默认
void的三种用法:返回值为空,函数不需要参数,void* 代表指向的对象的地址
比方说:
char *p = (void *)malloc(sizeof(int)); //表示申请了一个4字节空间,地址赋值给了p,而p每次+1就会移动到下一个字节
C的左值,右值:https://www.cnblogs.com/david-china/p/17080072.html
314159E-5:这种表示方式合法
变量存储类型:
自动:默认啥都不加就是自动,或者auto int a;
寄存器:register int a;或register a;超过限制会自动变为auto;运行速度快
静态内部:static int a;静态变量的存储地址在整个程序的运行期间均保留,不会被占据。C 语言中 static 的作用
extern:声明全局变量或函数。C/C++中extern关键字详解
typedef:类型起别名。比如:typedef unsigned char BYTE;
运算符:
逻辑运算符:&& || !(与或是成对的)
位运算符:& | ^(单个的)
运算符的话:单目高于双目
双目运算符优先级:由高到低为算数移位关系逻辑赋值条件。
条件控制:
continue:跳过后面循环体的代码,但for循环的计数变量还是会+1,while的话会重新判断
全局变量:函数外定义的变量
局部变量:函数内定义的变量;若内外变量重名,优先使用局部。
指针:
声明:
typedef int (*p)(char,char); //int指的是返回值类型,括号内只有参数数据类型和格式,没有局部变量
传值调用:
void pp(char a,char b)	//声明的时候就是俩char类型的变量
{
	a++;
	b++;
}
int main()
{
	char x = 3,y = 2;
	pp(x,y);	//x,y还是原来的值
	return 0;
}
传址调用:
void pp(char *a,char *b)	//声明的时候是俩char类型的指针,接收地址的那种
{
	*a++;
	*b++;
}
int main()
{
	char x = 3,y = 2;
	pp(&x,&y);	//x变成4,y变成3
	return 0;
}
malloc:堆区开辟空间,不会被初始化
free:释放所指的空间,参数必须是头部地址
结构体在内存中的地址就是头一个成员的地址,后面的地址依次递增。占内存空间大小就是所有成员加一起的大小。
联合体所占空间的大小为成员内最占空间的成员的大小,只有一个成员带有值
C语言文件操作:
FILE fopen(const char *filename,const char *mode);
FILE类型的指针指向的区域储存了文件控制流的信息
r:打开+读取
r+:打开+读写,(不创建)
w:打开或创建+从头写(覆盖)
w+:打开或创建+读取+从头写(覆盖)
a:打开或创建+追加
a+:打开或创建+从头读+追加
fclose(FILE *fp);
关闭成功返回0,有错误返回EOF
其它函数:
fgetc:读取字符
fputc:写入字符
fgets:读取字符串
fputs:写入字符串
fread:二进制读取
fwrite:二进制写入
fseek:设置fp的位置,相当于虚拟光标。详见C 库函数 - fseek()
feof:检查是否在末尾,在的话会返回非0值
字符串操作函数:
memcpy,memset,strcat,strncat,strchr,strrchr,strstr,strcmp,strncmp,strcpy,strncpy,srelen
数据结构:
线性表:
数组:内存空间上连续,查找速度快,插入删除慢。
链表:内存空间上不一定连续,查找速度慢,插入删除快。
队列:先进先出;出过给定环形队列问判断什么时候表示队列已满,要点就是要么使用tag记录尾节点是否追上头节点,要么使用尾节点+1然后对队列总容量取余;参看【数据结构】循环队列
栈:后进先出;出过给定若干数据进栈顺序求可能的出栈情况,要点就是进栈之后不一定立马出栈
树
双亲,孩子,兄弟:参考族谱
度:子树的个数
叶子节点:终端节点;度为0
层数:根节点为第一层,向下以此类推
高度:最大层数
有序树:子树无法互换
二叉树:度为2
深度为k的二叉树最多2k-1个节点。自己用递推法能得出来,像多米诺骨牌似的。
任意二叉树终端节点为n0,度为2的节点数为n2,则n0 = n2+1
满二叉树:第n层的节点数为2n-1,就是那种1,2,4,8....
完全二叉树:倒数第二层是满的,且最后一层从左到右是满的
遍历方式:先序:根左右,中序:左根右,后序:左右根。都是依照递归的方式。技巧:将除了叶子节点的其他节点都补上一个“占位”的节点,然后按照给定的顺序递推下去,从叶子(也可能是假叶子)那开始遍历,记住要始终遵循给定的顺序。
比如:
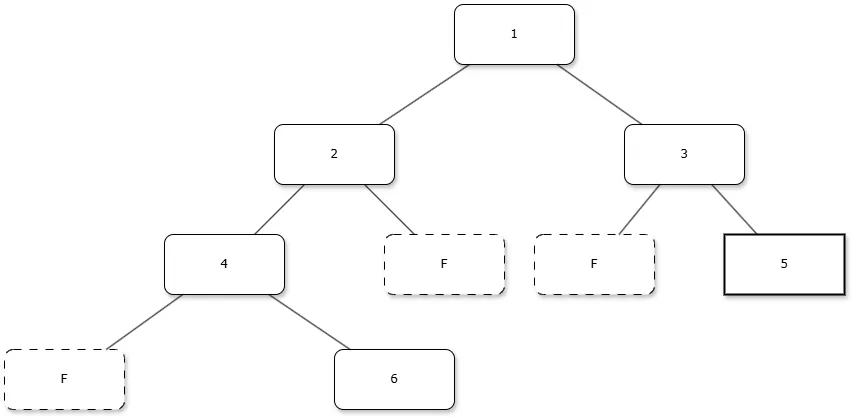
其中F就是补上的“占位”节点,遍历的时候算上,最后写答案的时候去掉就行。
前序(根左右):从根节点开始,12之后本来是3,但是2有子节点,所以再往下到4,因为补上占位节点了,所以4下边的F就是叶子节点,由于F下边没有节点了,那从这开始,4F6,算上之前的就是124F6,然后是2的右子节点F,就是124F6F,然后2节点这边就遍历完了,接下来是3,由于3下边的F节点没子节点了,那就是3F5,接上之前的就是124F6F3F5,此时遍历完成,检查的话可以去看任意一个非叶子节点是不是都满足“根左右”的形式即可。比如2节点的子树是4F6,遍历完这仨才遍历的2的F子节点,以此类推。检查无误后把F去掉,就是解题答案
图:
无向图:节点之间没箭头,不分方向,邻接矩阵对称
有向图:节点之间有箭头,不分方向,邻接矩阵不对称
完全图:节点之间都有连线,无向总连线个数:n(n-1)/2,有向因为方向原因,个数乘以2:n(n-1)
度:某节点连线数目。无向图直接查,有向图分入度出度,就是指进来的和指出去的箭头数目。箭头或者线叫做路径
邻接矩阵:有向图邻接矩阵的行表示起始节点,列表示目标节点,有路径填1,没有填0,自己到自己固定填0。无向图不分起始终点,有路径就是1,故对称。
邻接链表:除了根节点每个结点都表示与它链接的节点编号,有的也存储对应的度。根节点为唯一起始节点。
图的遍历方式:
深度优先:类似于前序遍历,先遍历到最末端,再往回查。
广度优先:从上到下,从左到右一个一个遍历。
考过选择题,给定图选深度遍历的顺序
算法复杂度:
空间复杂度指的是需要的内存空间
时间复杂度是执行时间数量级的表示,不是实际时间
二叉树查找的复杂度一般是log的形式
分治法的三个步骤:分解(成子问题),求解(每一个子问题),合并(所有子问题变成答案)
贪心法:
性质:1.最优子结构:最优解包含子问题的最优解。2.贪心选择:最优解可以由局部最优解叠加得到。
动态规划法:https://www.hello-algo.com/chapter_dynamic_programming/#_1
软件工程:
系统开发生命周期:
系统规划:系统设计任务书
系统分析:系统需求规格说明书
系统设计:概要设计说明书,详细设计说明书
系统实施:集成测试报告
系统验收:确认测试报告,项目验收报告
能力成熟度模型:
| 等级 | 特点 | 关键过程区域 |
|---|---|---|
| 初始级 | 乱 | 无 |
| 可重复级 | 建立了基本的项目管理过程和实践来跟踪项目费用,项目进度和功能特性, 有必要的过程准则来重复以往在同类项目的成功 |
软件子合同管理 软件需求管理 软件项目策划 软件配置管理 软件质量保证 软件项目跟踪与监督 |
| 已定义级 | 管理和工程两方面都已文档化,标准化,并综合成整个软件开发组织的标准软件过程 ,所有项目均以经过实际情况修改后的标准软件过程来开发软件 |
培训大纲 组件协调 同行评审 组织过程定义 组织过程集点 软件产品工程 集成软件管理 |
| 已管理级 | 制定了软件过程和产品质量的详细度量标准,对软件过程和产品质量有着定量的理解和把控 | 定量过程管理 软件质量管理 |
| 优化级 | 加强了定量分析,通过对来自质量过程的反馈和来自新概念新技术的反馈使得过程能够持续不断地改进 | 过程更改管理 技术改革管理 缺陷预防 |
(出过大题直接考定义的)
CMMI:初始级,已管理级,已定义级,定量管理,优化级。(稍作了解即可)
软件开发模型:
瀑布模型:结构化开发,适用于需求明确
原型:先设计原型和客户沟通确定细节,适用于需求不明确的情况,迭代思想
增量模型:先开发核心功能,再增量开发各个模块,难点是增量划分,每一个版本都是独立可操作的
螺旋模型:每一圈都有风险分析,适合大型项目开发。
V模型:
测试分段:
| 阶段 | 测试 |
|---|---|
| 需求建模 | 验收测试 |
| 概要测试 | 系统测试 |
| 详细设计 | 集成测试 |
| 编码 | 单元测试 |
测试计划先行:需求建模时指定验收和系统测试计划;概要测试时制定集成测试计划;详细设计时指定单元测试计划。
此处出过大题,要求补充完整V模型各阶段名称
喷泉模型:面向对象开发,迭代,无间隙。
基于构件:开发时建立构件库,方便复用。
形式化方法模型:基于数学。
统一过程:
特点:用例和风险驱动,以架构为中心,迭代且增量
四个阶段:起始,精化,构建,移交。
五个核心工作流:需求,分析,设计,实现,测试
选择题考过各阶段输出的开发文档
MVC模型:模型,视图,控制器。参见MVC 模式
简单来说就是为了在大型项目中实现业务逻辑,界面显示,数据这仨分离,便于移植开发升级。机制就是,用户对视图的操作传给控制器,由控制器调用合适的模型处理数据,控制器同时刷新界面
开发方法:
| 名称 | 优点 | 缺点 |
|---|---|---|
| 结构化开发 | 目标清晰 阶段明确 文档规范 结构工整 |
周期长 难变更 很少考虑数据结构 |
| 原型方法 | 周期短 风险低 效益高 容易运维 |
环境要求高 管理水平要求高 |
| 面向对象方法 | 复用性好 无缝开发 |
不能涉足系统分析以前的环节 |
| jackson方法 | 适合小规模项目 面向数据结构 |
|
| 敏捷开发方法 | 适合中小型项目 |
极限编程:敏捷开发的其中一个模型
4大价值观:
简单,沟通,勇气,反馈
5大原则:
简单性假设,优质工作,逐步修改,提倡更改,快速反馈
12大最佳实践:
隐喻,重构,计划游戏,简单设计,编码标准,结对编程,小型发布,持续集成,测试先行,现场客户,集体代码所有制,每周工作40小时
需求分析:
分类:
业务需求:客户的意见
用户需求:使用者的需求
系统需求:功能需求,非功能需求,设计约束等
几种基线:
功能基线:最初的功能配置标识,系统分析与软件定义阶段结束后撰写的系统设计规格说明。
分配基线:最初的分配配置标识,软件需求分析结束后撰写的需求规格说明。
产品基线:最初的产品配置标识,软件组装与系统测试阶段结束后撰写的配置项的规格说明。
结构化需求分析:
数据流图:
ER图:
最好熟悉图,大题可能出填空
选择题考过哪些是实体
面向对象需求分析:(还不熟)
结构化设计:
高内聚,低耦合:
内聚的类型:由低到高
偶然内聚:没直接关系
逻辑内聚:逻辑相似,通过参数选择其中的子程序执行
时间内聚:同时执行
过程内聚:指定的过程顺序
通信内聚:处理同一个数据结构;相同输入或输出
顺序内聚:流水线作业,输出输入首尾相连
功能内聚:共同作用,缺一不可
耦合的类型:由低到高
无直接耦合:没直接关系
数据耦合:存在传值调用
标记耦合:传递数据结构
控制耦合:传递控制变量
外部耦合:软件外部环境
公共耦合:公共数据结构
内容耦合:模块内部关联
面向对象设计:
系统测试与维护:
测试类型:
静态:
桌前检查:程序员自己查
代码审查:开会一起查
代码走查:测试人员拿用例让程序员手动运行
动态:黑白灰盒测试
测试阶段:单元测试,集成测试,确认测试,验收测试,系统测试,配置项测试,回归测试。
确认测试分三种:
内部确认:开发者按照软件需求规格书测试
阿尔法:用户在开发环境测试
贝塔:在实际环境测试
系统测试分为:功能测试,性能测试,界面测试,鲁棒性测试,安全性测试,安装与反安装测试。功能测试采用黑盒测试法。
测试用例设计:
黑盒:设计一个新用例,尽可能多覆盖有效等价类,不断增加用例直到有效等价类都被覆盖。;设计一个新用例,仅覆盖一个尚未被覆盖的无效等价类,不断增加用例直到无效等价类都被覆盖。
白盒:(覆盖层级由低到高)
语句覆盖:设计足够多的测试用例,使得代码中所有语句都被至少执行一遍
判定覆盖:设计足够多的测试用例,使得每个判定的真假都至少出现一次
条件覆盖:设计足够多的测试用例,使得判定的每个条件的真假都至少出现一次
(判定/条件覆盖)C/DC:设计足够多的测试用例,使得每个判定的真假都至少出现一次,并且每个条件的真假也都至少出现一次;就是说判断的真假都有,里面条件的真假也得有,还得用例最少。
(修正的判定/条件覆盖)MCDC:设计足够多的测试用例,使得每个条件的真假都至少出现一次,且每个条件的真假都能独立地影响结果
路径覆盖:设计足够多的测试用例,使得程序中的每条路径都至少被执行一次
组合覆盖(多重条件覆盖):每次改变一个条件的真假,且要求所有输入条件都改变至少一次,形成\(2^{n}\)个用例
除了组合覆盖,剩下的是不要求排列组合的,也就是说完全可以使用两个用例表示两个条件的真假,路径覆盖只关心流程图内的路径是否都走了一遍,不管分支内是否有代码块。
MCDC是组合覆盖的子集
圈复杂度计算:
没有流程图:基数1,碰见if,for,while,do while,case就+1,括号里两个条件就+2
有流程图:边的数量-节点数量+2;判定节点数量+1
调试:
蛮力法:穷举
回溯法:走不通退一步
演绎法:一般到特殊
归纳法:特殊到一般
维护:
系统转换:
直接转换:
并行转换:
分段转换:
容错:
手段主要是冗余:结构冗余,信息冗余,时间冗余,冗余附加技术
硬件角度:相似余度或非相似余度
软件角度:恢复块技术,N版本技术,防卫式程序设计
安全关键系统的原则:任何情况下决不放弃。测试项:语句覆盖,判定覆盖,条件覆盖,MCDC,路径覆盖。
项目管理:
甘特图:能反映并行关系,无法反映依赖关系。
pert图:反应依赖关系
质量管理:(不熟)
风险管理:(更不熟)
关于数据库:
事务 共享锁 排他锁:共享锁、排他锁、互斥锁、悲观锁、乐观锁、行锁、表锁、页面锁、不可重复读、丢失修改、读脏数据
路由算法:
静态路由,自适应路由,随机路由,洪泛路由:路由算法的分类(自适应路由、非自适应路由)
需要算的
霍夫曼树:
给定字符及出现频次求编码长度的话,其实就是先构造霍夫曼树,其中每个字符(叶子节点)的度就是编码长度。
详见霍夫曼树
缺陷探测率计算:
给定PERT图,算关键路径天数,算松弛时间
给定关系模式求候选关键字,判断哪个是无损链接,详见关系模式判断候候选关键字 与 函数依赖无损连接
遇到文字版本的,先转换成字母方便计算。

 浙公网安备 33010602011771号