拒绝“伪DFD”:从层级平衡到逻辑正交,资深分析师的避坑心法与工具评测
写在前面:
作为一名在系统分析和产品设计领域摸爬滚打多年的“老兵”,我见过太多团队把数据流图(DFD)画成了带箭头的流程图,或者直接用面向对象的类图思维去套用。结果就是:业务方看不懂,开发觉得没用,最后沦为应付文档的“装饰品”。
最近重读了 Visual Paradigm 关于 DFD 的深度指南,结合自己这些年从手工绘图到 AI 辅助建模的实战经验,我想以一个资深用户和产品体验者的视角,重新拆解一下 DFD 的核心心法。这不仅仅是一篇技术教程,更是一份帮你避开 90% 常见坑的产品级避坑指南。

💡 为什么你现在还需要 DFD?
在敏捷和微服务大行其道的今天,很多人问我:“还有必要画 DFD 吗?”
我的回答是:不仅有,而且是解决“需求模糊”和“范围蔓延”的神器。
DFD 不是控制流(Control Flow),也不是类模型(Class Model)。它是功能的严谨规格说明,只关心数据如何流动和变换。在项目启动阶段,一张高质量的 DFD 是连接业务 stakeholder 和技术团队的“契约”。它能在写第一行代码前,就帮你把系统边界、数据流向和逻辑漏洞暴露无遗。
🛠️ 核心词汇表:别让符号毁了你的专业度
很多新手输在“不讲究”。无论你用 Yourdon 还是 Gane & Sarson notation,以下四个元素是 DFD 的“字母表”,混用或乱命名都是大忌。
| 元素 | 核心作用 | 命名铁律(实战经验) |
|---|---|---|
| 外部实体 (Terminator) | 数据的源头或终点(人、组织、外部系统) | 名词。如:客户、支付网关 |
| 加工 (Process) | 数据的变换器。必须有编号+动宾短语 | 1.0 验证订单、2.3 扣减库存。动词开头! |
| 数据存储 (Data Store) | 静态数据的栖息地(DB、文件、缓存) | D1 客户信息、D2 库存表。必须有D编号! |
| 数据流 (Data Flow) | 数据的运动轨迹 | 订单请求、支付确认。拒绝“数据”这种废话标签! |
⚠️ 老手提醒:
进程编号不是为了好看,是为了分解(Decomposition)。父图里的2.0,在子图里必须严格对应2.1, 2.2, 2.3。如果编号乱了,后面的平衡检查就是灾难。
🪜 层级体系:像剥洋葱一样做抽象
DFD 的精髓在于自顶向下分解。不要试图在一张图里塞下所有细节,那是新手的通病。
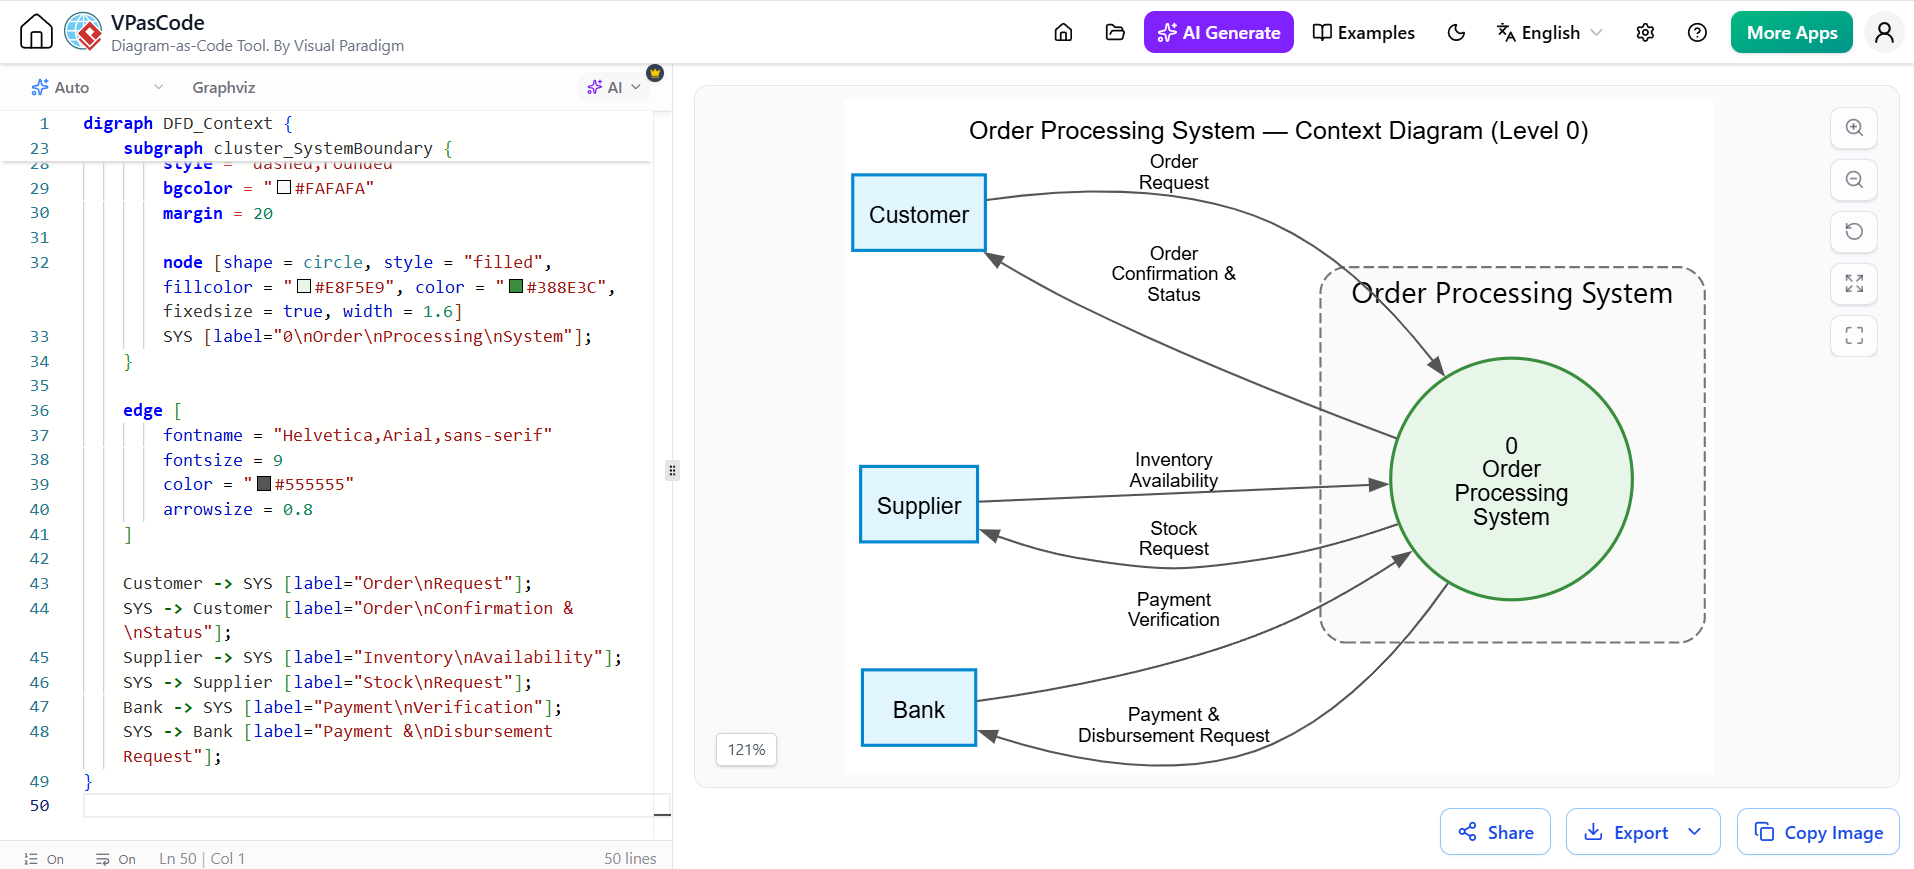
1. Context Diagram (Level 0):定边界的“宪法”
-
体验心得: 这是我最爱的一张图。整个系统就是一个黑盒(Process 0)。
-
核心价值: 它定义了Scope(范围)。凡是没出现在这张图上的外部交互,统统视为“不在本期范围内”。这是防止甲方无限加需求的尚方宝剑。
-
注意: 这里绝对不能出现内部数据存储和内部流程。
2. Level 1 DFD:看骨架
-
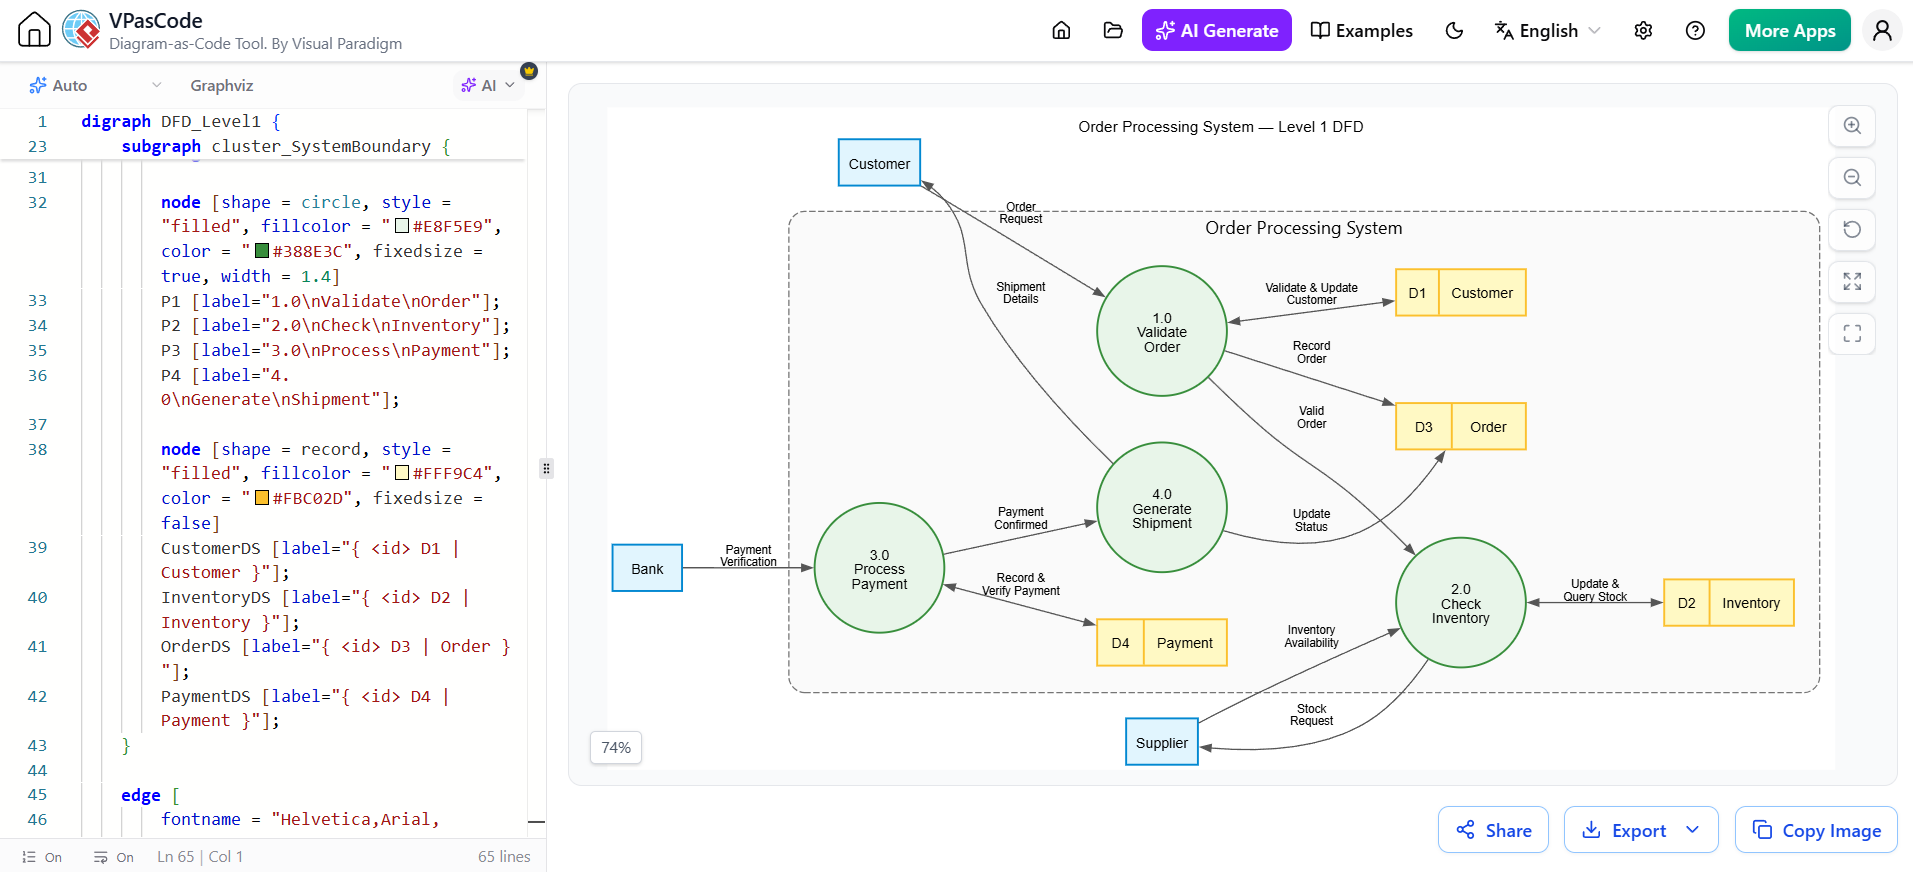
把 Process 0 炸开,展示主要功能模块(通常 3-7 个为宜)。
-
关键变化: 数据存储(Data Stores)首次登场。
-
审查点: 检查 Level 1 的所有输入输出流,是否与 Level 0 完全一致?这就是平衡(Balancing)。
3. Level 2+ DFD:见血肉
-
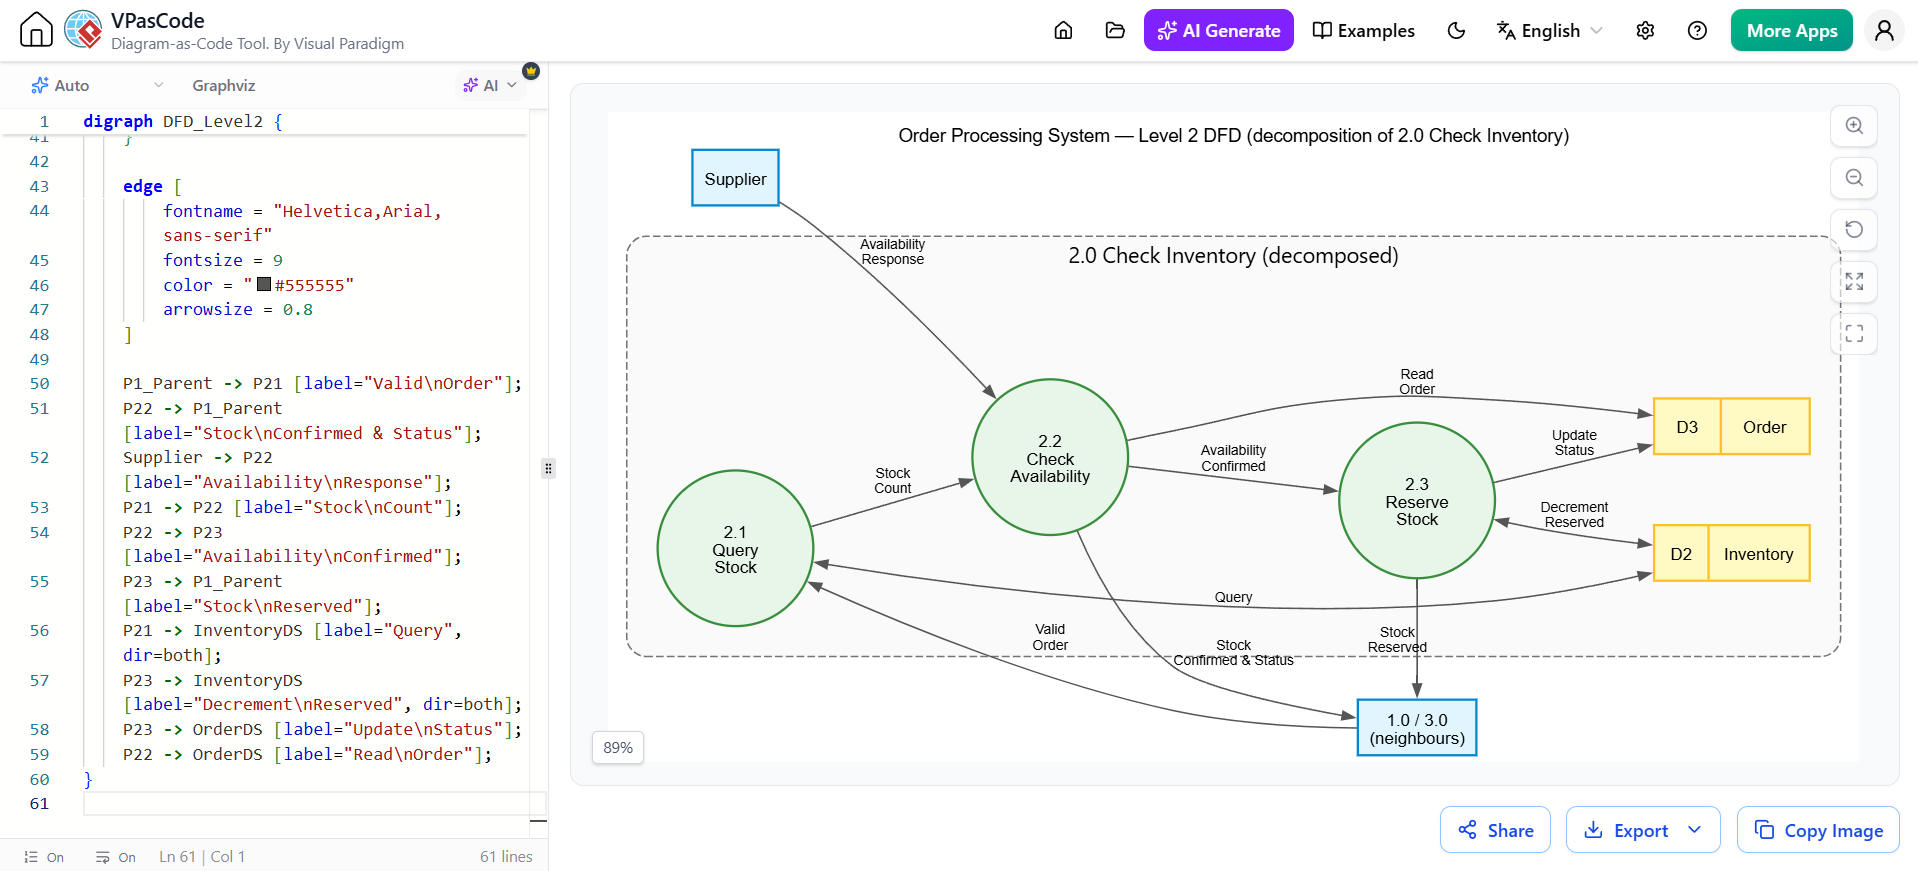
针对复杂功能继续分解。
-
停止标准: 直到每个叶子节点都是功能原语(Functional Primitive)——即可以用几行伪代码或一个用户故事说清楚的程度。不要为了分解而分解。
🧠 逻辑 vs 物理:最容易被混淆的“正交轴”
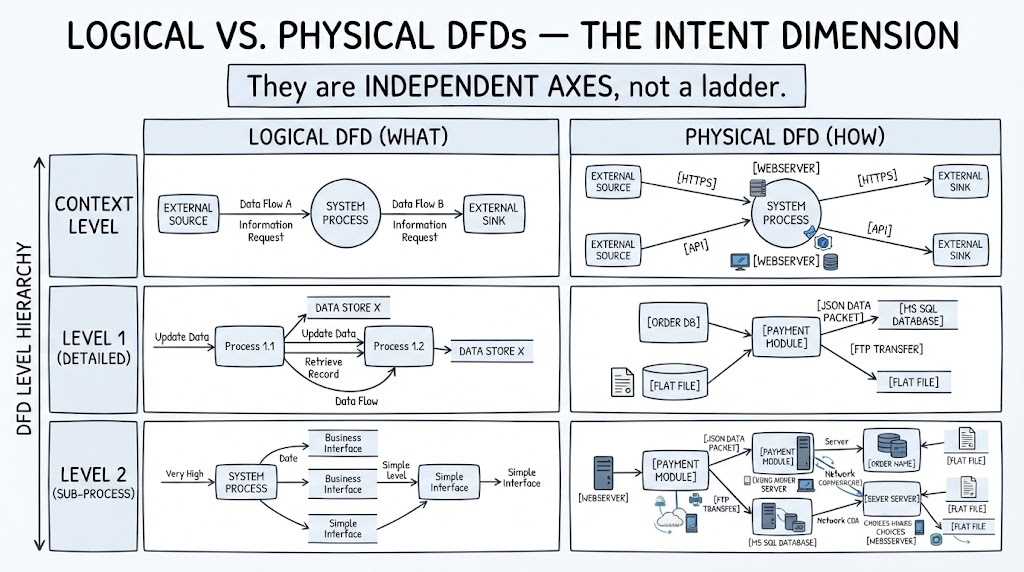
这是我见过误解最深的地方。很多人把 DFD 的层级叫作“概念层、逻辑层、物理层”,这是错的! 那是类图的术语。
在 DFD 中,Logical/Physical 是独立于 Layer 的另一个维度。
| 维度 | Logical DFD (逻辑DFD) | Physical DFD (物理DFD) |
|---|---|---|
| 关注点 | What (业务本质) | How (技术实现) |
| 包含内容 | 业务活动、概念数据 | API协议、数据库名、消息队列、具体部门 |
| 适用阶段 | 需求分析、业务确认 | 系统设计、架构落地 |
| 用户体验 | 业务方点头说“对,就是这样” | 开发说“明白,用JMS发JSON” |
💡 最佳实践路径:
先画 Logical DFD 搞定需求(排除技术噪音),再基于它推导 Physical DFD 指导开发。两者并行存在,而非先后替代。
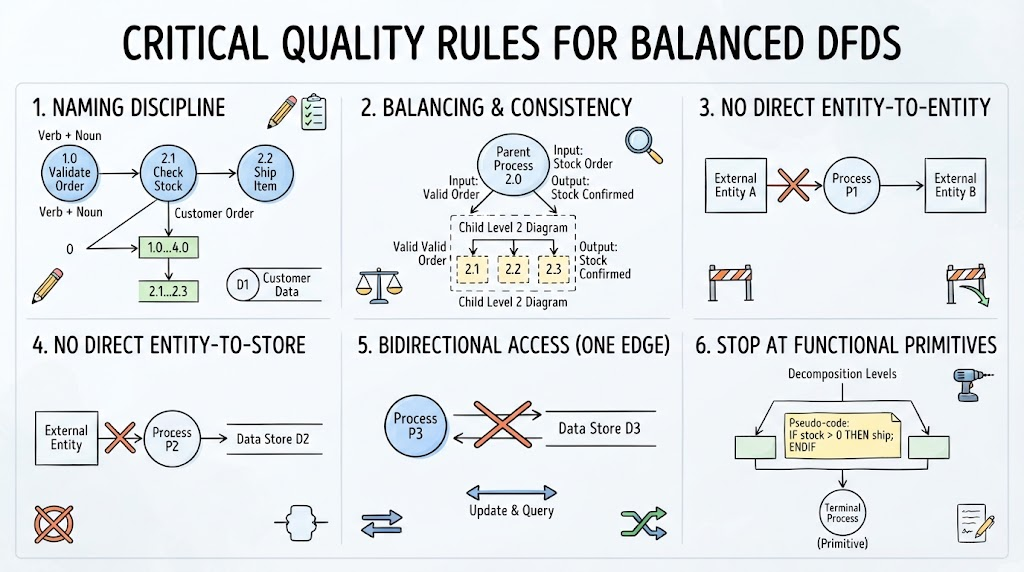
✅ 质量守门员:DFD 的“六大天条”
作为评审过上百份设计文档的人,我用这套清单来卡质量。任何一条不满足,打回重画:
-
命名规范: 动词+名词,编号树状结构完整。
-
父子平衡(Balancing): 这是最重要的规则。父图的 I/O 必须等于子图 I/O 的总和。多一个少一个都是逻辑错误。
-
禁止实体直连: 外部实体之间、外部实体与数据存储之间严禁直接连线。数据必须经过 Process。
-
双向流合并: 读写同一个 Store 时,用一条双向箭头 + 合并标签(如
Update & Query),别画两根线搞得像蜘蛛网。 -
无黑洞/奇迹: 只有输入没有输出的 Process 是黑洞;只有输出没有输入的是奇迹。两者皆非法。
-
原语可描述: 底层 Process 必须能用人话或伪代码解释清楚。
🔧 工具与可视化体验点评
文中使用的 Graphviz DOT 语言 + Visual Paradigm 的组合,是目前Diagram as Code 的优秀实践。
-
配色方案: 蓝色实体、绿色加工、黄色存储、灰色边界。这套配色符合认知心理学,长时间审阅不累眼。
-
VPasCode 编辑器: 支持实时预览 DOT 代码,对于习惯 Markdown/Git 管理的团队极其友好。相比拖拽式工具,代码化 DFD 更容易做版本控制和 Diff 对比。
-
AI 辅助: 现在的工具已经能通过自然语言生成 DFD 草稿(如文中提到的 AI Chatbot),但最终校验仍需人工介入。AI 提效,专家把关,这才是正确的打开方式。
📝 总结与建议
DFD 不是过时的古董,而是对抗复杂性的精密仪器。
-
对产品经理: 用它来厘清业务边界,别再写万字长文却说不清数据怎么流转。
-
对架构师: 用它来做设计前的 sanity check,避免过早陷入技术细节泥潭。
-
对新人: 记住 Context → Level 1 → Level 2 的分解节奏,严守 Logical ≠ Physical 的正交原则。
最后的话:
一张好的 DFD,不在于画得多么花哨,而在于它是否精准地传递了意图。当你拿着 Context Diagram 和业务方对齐范围,拿着 Balanced Level 2 Diagram 和开发确认逻辑时,你会发现,所有的返工和扯皮都减少了。建议收藏文中的 Section 7 Checklist,下次画图前过一遍。让 DFD 回归它应有的工程价值,而不是停留在PPT里的装饰画。
参考资料:Visual Paradigm Mastering DFD Guide | DeMarco Structured Analysis | Yourdon Modern Systems Analysis
posted on 2026-08-14 15:27 Lynch_Warren 阅读(29) 评论(0) 收藏 举报


 浙公网安备 33010602011771号